最好用的AI工具
搜尋:視頻
290 個結果
Seedance 2.5 4K – 火山引擎推出的高端版視頻生成模型
Seedance 2.5 4K是什麼 Seeda...
Hy-Nomas – 騰訊混元團隊開源的交互式視頻世界生成模型
Hy-Nomas是什麼 Hy-Nomas 是...
DeepSeek V4.1 Flash 1017 實測 – 幾句話生成完整項目
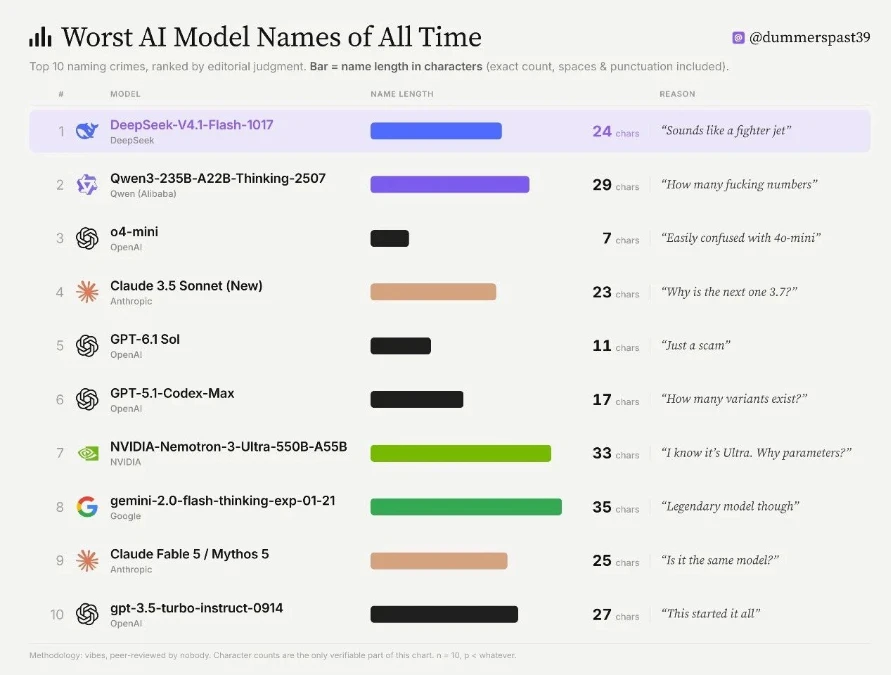
最近 DeepSeek 更了新模型,DeepSeek-V4.1-Flash-1017,一更新就登上了兩大排行榜榜首。 名字拉跨模型榜首: 開源模型榜首: 這次DeepSeek-V4.1-Flash-1017 官方打的是許願式編程的旗號,那是不是真的能幾句話出項目呢?實測一波不就知道了。 01. 模型實測 官方說 DeepSeek V4.1 Flash 1017 通過基於自反饋的強化學習(RL)訓練技術,提升了在遊戲開發、3D 建模等方面從零開始構建完整項目的能力,能夠支持實現更多許願式編程任務及項目開發請求。 說人話就是有了少量提示詞出完整項目對的能力,我們今天就用幾句話的提示詞來試試。 case 1 超光速穿梭網頁 提示詞:製作一個名爲 HYPERSPEED 的全屏交互網頁,使用 Three.js 實時繪製穿梭於霓虹高速公路的第一人稱場景。黑色背景,青色與洋紅色燈帶沿道路兩側延伸,車輛燈軌不斷經過鏡頭。按住鼠標或手機屏幕時,行進速度逐漸提高,燈軌拉長,鏡頭視野擴大;鬆開後平滑恢復。提供三種可切換配色,以及速度和光軌密度控制。頁面只保留簡潔標題、操作提示和底部控制欄。動畫由代碼實時生成,不使用背景視頻。 長按加速時,燈軌、視野、速度讀數和操作提示都會跟着變化,三種配色及參數調節也能正常使用,畫面的空間感已經出來了。 case 2 產品爆炸拆解 提示詞: 製作一個機械鍵盤的交互式產品展示網頁,使用 Three.js,通過基礎幾何體生成鍵盤模型。 初始顯示完整鍵盤,採用深灰色外殼、米白色鍵帽和橙色 Esc 鍵。滾動頁面時固定展示區域,讓鍵帽、軸體、定位板、電路板、消音棉和底殼依次分離,形成清晰的立體爆炸圖。 各層分離時出現名稱與引導線。繼續滾動,所有部件重新組裝;反向滾動時動畫能夠連續倒放。提供鼠標拖動觀察角度的功能,整體採用簡潔的工業產品展示風格。 滾動拆解完成得比較完整。六層結構依次展開,名稱和引導線跟着部件移動,繼續滾動還能重新組裝。鍵帽字符、定位板開孔和電路板走線也有體現。 case 3 3D 懸浮銀行卡輪播 提示詞: 製作一個全屏 3D 銀行卡展示網頁,純黑背景,五張不同材質的虛構銀行卡圍繞一個不可見的橫向圓柱排列。 中央卡片正對觀衆,其餘卡片沿圓柱向後旋轉,呈現透視和遮擋關係。支持拖動切換,鬆手後帶慣性並自動吸附到最近一張。鼠標移動時,中央卡片輕微傾斜;點擊可翻到背面,再次點擊恢復。 卡片有可見厚度、金屬芯片、虛構卡號和背面磁條。用 CSS 漸變生成鐳射、磨砂和金屬質感,不使用視頻或卡片截圖。 銀行卡輪播的細節完成得比較好。五張卡片各有不同紋理,翻面後也有完整的磁條和簽名欄。拖動時能感受到慣性與自動吸附,快速甩動和停頓後鬆手會得到不同結果。 case 4 鼠標探照燈 提示詞: 製作一個名爲「地層之下」的全屏交互網頁。 默認畫面是一片安靜的山地景觀。鼠標移動時,一個邊緣柔和的圓形探照燈跟隨光標,光圈內顯示對應位置的地下剖面,包括岩層、晶體和化石,光圈外仍然顯示地表。 地表與地下畫面使用 SVG 或 Canvas 繪製,空間位置保持對應。光圈帶少量跟隨延遲,滾輪可調整大小。前景加入簡潔標題、說明和探索按鈕,手機端支持手指拖動探照燈。 探索過程做得比較完整。移動光圈能揭開山體內部的岩層,靠近化石和晶洞時會出現對應標註,按鈕還能自動帶着瀏覽三處標本,山巒、薄霧和儀器刻度形成了統一的視覺風格。 case 5 海報風動態首頁 提示詞: 製作一個名爲 BEYOND 的創意工作室首頁,採用橙色背景、超大白色標題,以及淺綠和淺藍的錯位文字疊層,呈現復古立體海報效果。 首屏中央繪製一個原創 SVG 抽象角色,讓角色遮住部分標題,形成前後層次。頁面兩側排列大號關鍵詞,滾動時從兩側逐漸向中央移動,同時提高透明度。 下一屏是一條白底橙字的無縫滾動文字帶。 桌面端構圖大膽,手機端重新安排文字與角色的位置,保持標題清楚可讀。 海報風格比較鮮明。橙色背景、錯位大字和獨眼角色形成了統一構圖,滾動時兩側關鍵詞向內移動,接着進入白底橙字的跑馬燈區域,視覺演示已經比較完整。 case 6 液態漸變首頁 提示詞: 製作一個名爲 FLUID 的全屏交互首頁。 背景由五個緩慢運動的彩色色團組成,採用深藍、青色、珊瑚橙和少量紫紅。色團接近時像黏稠液體一樣融合,分離時自然拉伸。增加一個跟隨鼠標的色團,讓用戶能用光標影響畫面。 使用 SVG 濾鏡、CSS 或 Canvas 實現實時效果。提供暫停、運動速度和配色切換功能。前景放置清晰的大標題、簡短介紹及兩個按鈕,背景運動時仍保持文字可讀。 液態背景和控制面板都做出來了。鼠標能作爲額外的色團參與畫面,暫停、調速、換色和擾動按鈕也都有實際反饋。說明彈窗還能保留原先的播放狀態,細節比較完整。 實測總結:
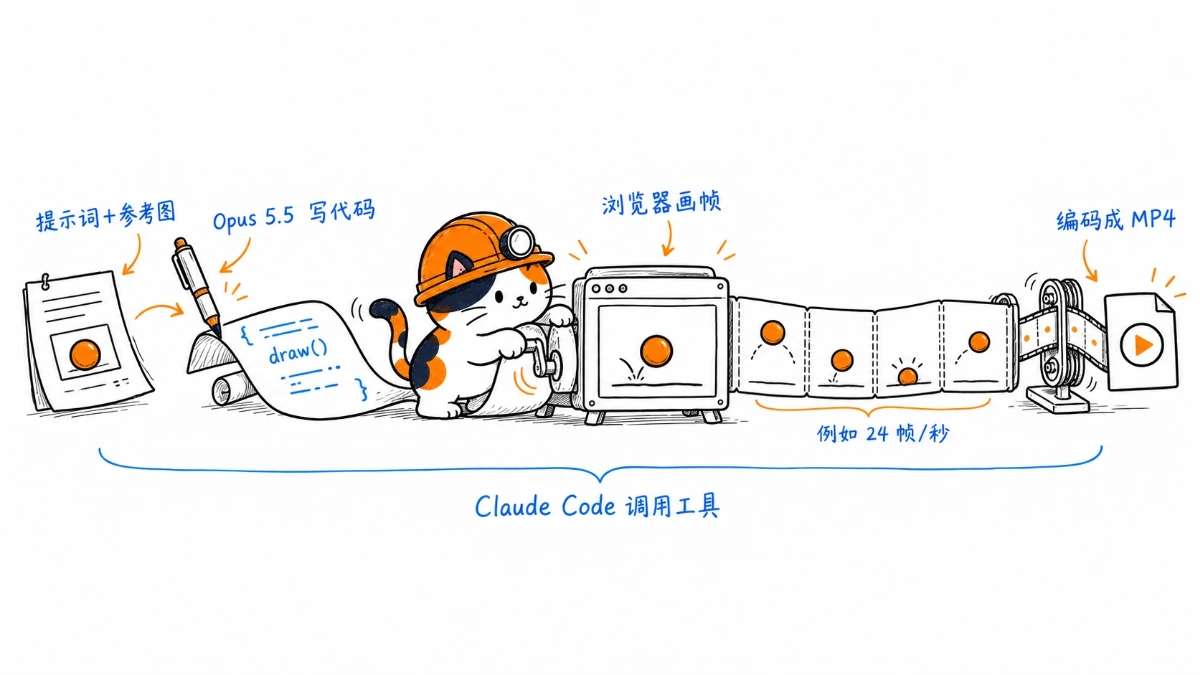
Claude Opus 5.5 視頻教程 – 附萬能提示詞模板與 GitHub 項目
最近,X 上出現了很多百萬播放的 Claude Opus 5.5 視頻作品。 kirill 的動效作品集,有 190 萬播放。 Donald 重製的《Claude Pop》MV,有 390 萬播放。 對做內容的人來說,這真的是史詩級別的技能提升,各種視頻都能不用視頻模型就能出了:可以給文章做一段動畫解釋,爲軟件錄一支宣傳片,或者把準備好的配音稿做成視頻。 過去需要逐個調整的字幕、圖形和轉場,現在都可以把要求交給 Claude Oups 5.5。 還沒試過的可以用我的萬能提示詞試試,我還給大家找了幾個 GitHub 上的的提示詞項目供大家參考。 01. Claude Opus 5.5 怎麼做視頻 Claude Opus 5.5 做視頻,不是代表這個模型已經變成了視頻模型。Claude Opus 5.5 還是隻能看文字和圖片,並輸出文字。 視頻畫面都是由代碼實現的,Claude Opus 5.5 寫好代碼,代碼在瀏覽器裏做出畫面,連續畫面達到 24 張每秒後,就會讓眼睛看到連續的畫面,最後再交給別的程序把畫面拍成視頻即可。 所以大家只需要輸入提示詞,其他的都交給 Claude Opus 5.5 即可。 我們來試着做一支普通人能看懂的諾獎科普動畫 2026 年諾貝爾物理學獎,授予弗朗西斯·哈爾岑,表彰他對冰立方中微子天文台的決定性貢獻,以及發現具有天體物理起源的高能中微子。 普通人一般都不懂這個方面,我們看看 Claude Oups 5.5 是如何做出普通人都能看懂的視頻的。 提示詞: 請製作一支中文科普動畫,介紹 2026 年諾貝爾物理學獎。 你同時擔任科普編導和動畫開發者。 【觀衆與目標】 觀衆沒有大學物理基礎。看完應該能解釋: 中微子爲什麼難以探測;冰立方怎樣探測中微子; 這項研究爲什麼能幫助我們瞭解宇宙。 建議標題:《2026 諾貝爾物理學獎:南極的冰,怎麼幫我們觀察宇宙?》 時長約 150 秒,中文旁白約 450~550 字,留出觀看動畫的時間。 橫屏 16:9,1920×1080,30 fps,中文旁白與中文字幕。 用 HTML、CSS 和 JavaScript 製作二維示意動畫,使用 HyperFrames 渲染。 【事實與資料】 2026 年諾貝爾物理學獎授予弗朗西斯·哈爾岑(Francis Halzen), 表彰他對冰立方中微子天文台的決定性貢獻, 以及發現具有天體物理起源的高能中微子。 製作前閱讀並覈實以下資料: https://www.kva.se/en/news/the-nobel-prize-in-physics-2026/ 獲獎者、年份、獲獎原因以官方資料爲準。 具體數字和歷史日期逐項覈實,無法覈實的內容省略。 體現哈爾岑的構想與領導作用,也說明國際團隊的共同貢獻。 【分鏡安排】 第一幕,約 0~12 秒:從南極地表向下移動, 顯示冰層中成串的傳感器。 開場旁白:「南極的冰層下面,藏着一台用來觀察宇宙的儀器。」 第二幕,約 12~25 秒:顯示哈爾岑姓名、2026 年諾貝爾物理學獎, 以及冰立方的簡化示意圖,用兩句口語說明獲獎原因。 第三幕,約 25~50 秒:用小圓點和軌跡表示中微子穿過物體。 解釋中微子是極小、不帶電的粒子,很少與物質發生相互作用, 因此難以留下可探測的信號。 畫面註明:粒子大小和運動速度爲示意。 第四幕,約 50~75 秒:用剖面圖展示透明的深層冰和光傳感器。 解釋探測需要很大的體積,透明的冰能讓微弱的光傳播到傳感器。 把傳感器畫在多根垂直線纜上,體現三維分佈,註明數量經過簡化。 第五幕,約 75~110 秒:放慢探測過程,按順序展示: 中微子進入冰層 → 極少數中微子與原子核發生相互作用 → 產生帶電粒子 → 帶電粒子運動時產生微弱的切倫科夫光 → 附近的光傳感器記錄這些光。 每一步配一句短旁白,前一步解釋完再出現下一步。 第六幕,約 110~135 秒:讓不同位置的傳感器依次亮起, 顯示記錄到的光信號,再用簡化箭頭展示分析後的來向。 解釋科學家根據光到達的位置、時間和強弱,估算中微子的來向與能量。 提一句分析需要排除來自地球大氣等背景的干擾。 把畫面拉回宇宙,說明高能中微子幫助研究遙遠宇宙中的高能過程。 第七幕,約 135~150 秒:重放完整過程: 宇宙中的高能過程 → 中微子 → 冰層中的相互作用 → 光傳感器記錄 → 科學分析。 用一句自然的旁白收尾,片尾顯示簡短資料來源。 【畫面與講解】 米白背景、深灰文字,冰層用淺藍色。 中微子用橙色,帶電粒子用綠色,光用藍色,保留簡短圖例。 用移動、穿過、局部放大和依次亮起展示過程。 每個鏡頭只引入一個新概念,複雜步驟放慢。 旁白使用短而完整的句子,術語第一次出現時立即解釋,儘量不用公式。 屏幕文字只保留關鍵詞和必要標籤
FLUX 3 Max – fal 與 Black Forest Labs 推出的視頻生成模型
FLUX 3 Max是什麼 FLUX 3 Max 是 fal Research 與 Black Forest Labs 聯合推出的後訓練視頻模型,支持文生視頻、圖生視頻與關鍵幀插值,可生成5–20秒、720p/1080p、帶原生音頻的視頻。FLUX 3 Max 主打極致速度,10秒成片約12秒生成,官方稱同畫質下比 Seedance 2.5 快22倍。 FLUX 3 Max的主要功能 文生視頻:一句話提示詞可生成 5–20 秒的完整視頻片段。 圖生視頻:輸入參考圖作爲起始幀,可選指定結束幀,實現首尾幀之間的受控生成。 音畫同步:原生生成配套音頻與人物口型對話,無需後期配音合成。 Draft 草稿模式:極低成本快速出預覽稿,確認後同提示詞一鍵渲染爲全質量成片。 極致速度:10 秒視頻約 12 秒生成,官方稱同畫質下比 Seedance 2.5 快 22 倍。 靈活輸出:720p/1080p 兩檔分辨率,通過 fal 等平台統一 API 調用。 FLUX 3 Max的技術原理 多模態統一底座:FLUX 3 Max 基於 Black Forest Labs 的 FLUX 3 基礎模型,後者將多模態生成與理解整合在同一底層架構中,圖像、視頻、音頻、文本共享一套表示空間,各模態能力互相增強。 Self-Flow 對齊方法:相比傳統 Flow Matching,Self-Flow 在各模態上的生成誤差更低,且經微調後在四組操控任務上的成功率更高,更易被精確控制。 後訓練效率特化:”Max”版本是 fal Research 與 BFL 在 FLUX 3 底座上做的後訓練版本,目標是推理效率:通過蒸餾等手段大幅減少採樣步數與計算開銷,在畫質基本無損的前提下把延遲壓低。 生態化推理部署:經 fal 統一 API 輸出,同時接入 Comfy、OpenRouter、Runware、HeyGen 等 17 家平台,配合 Draft 模式的先草稿後精修工作流,把創作端的試錯成本一併壓低。 如何使用FLUX 3 Max 打開入口:訪問 fal 官網,註冊或登錄賬號,或 Black Forest Labs 官網 https://bfl.ai/。 選擇模式:選文生視頻(純提示詞)、圖生視頻(上傳起始幀圖)或關鍵幀插值(首尾幀)。 輸入素材:文生視頻填寫提示詞,圖生視頻上傳圖片,可選配結束幀控制鏡頭走向。 設置參數:設定時長(5–20 秒)、分辨率(720p/1080p)及是否同步生成音頻。 先試草稿:用 Draft 模式跑一版低成本預覽,確認構圖和動作滿意後再渲染全質量成片。 API 接入:生產環境通過 fal 統一 API 調用(文檔見 fal.ai/docs),可走 Comfy、OpenRouter、Runware 等第三方接入。 FLUX 3 Max的核心優勢 質量第一梯隊:在獨立第三方 Artificial Analysis 圖生視頻榜單上並列第一(Elo 約 1138 分)。 價格最低檔:號稱同質量級別最便宜的前沿視頻模型。 音畫一體:原生同步生成音頻與口型對話,無需後期配音。 Draft 模式省成本:先低成本出預覽稿,確認後再渲染全質量,試錯費用大幅壓縮。 輸入靈活:支持文生視頻、圖生視頻、首尾關鍵幀插值三種工作流。 FLUX 3 Max的項目官網 項目地址:https://bfl.ai/models/flux-3-video#flux-3-max FLUX 3 Max的同類競品對比 對比維度 FLUX 3 Max MiniMax H3 產品定位 前沿模型的速度特化版,主打”最快” 通用音畫生成旗艦,主打”最全” 生成時長 5–20 秒 4–15 秒 分辨率 720p / 1080p 直出 768p 直出,2K 需二次再生 音頻能力 原生音頻 + 人物對話 原生 32kHz 立體聲 + 口型同步 生成速度 10 秒視頻約 12 秒生成 標準隊列速度(快版需選 H3 Max 變體) 榜單表現 圖生視頻並列第一(約 1138 Elo) 圖生視頻約 1140 Elo,略壓一頭 參考輸入 圖片、首尾關鍵幀 多模態參考:最多 9 圖 + 3 視頻 + 3 音頻 開放權重 否,僅 API 是,H3-Base 已上傳 Hugging Face FLUX 3 Max的應用場景 電商與虛擬試穿:上傳商品圖或模特圖生成動態展示視頻,替代傳統拍攝做詳情頁和廣告素材。 廣告與品牌營銷:Logo 動態演繹、產品質感鏡頭一鍵生成,品牌方無需傳統制作週期即可上新 campaign。 影視分鏡與預演:劇本文字直接轉動態分鏡,導演
Synvas – AI 視頻畫布創作工具,支持邊生成、邊剪輯
Synvas是什麼 Synvas 是 AI ...
用 Claude Opus 5.5 製作視頻,18 類場景案例合集
Opus 5.5 能做什麼視頻?從 4...
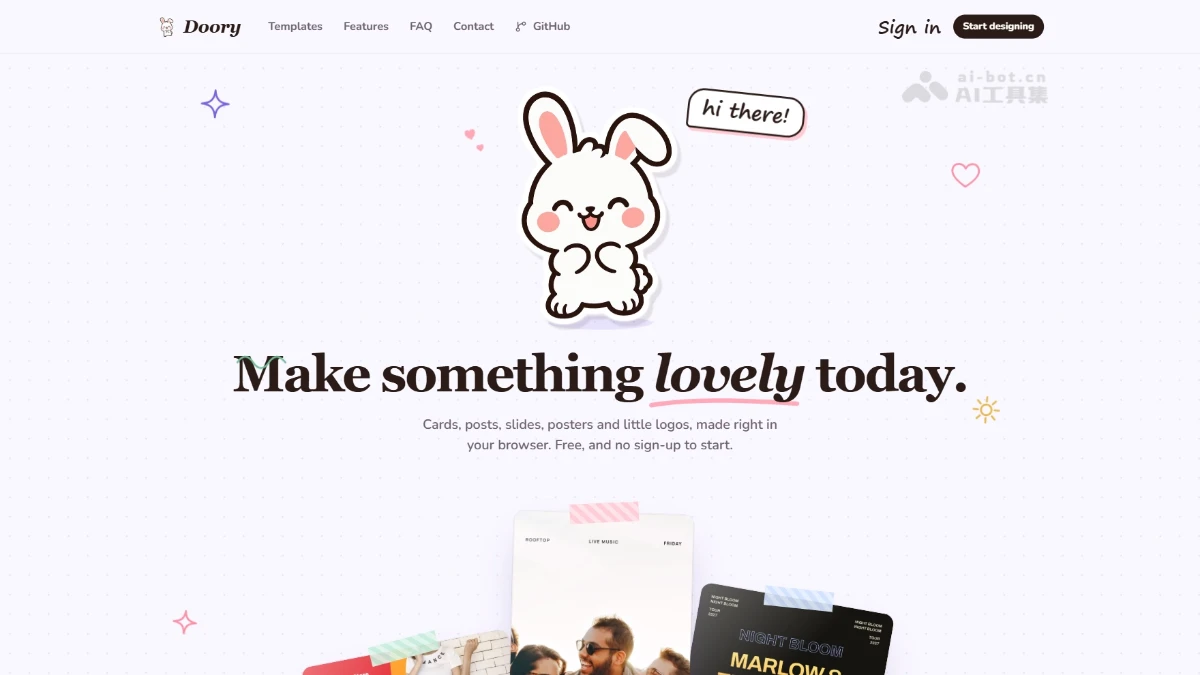
Doory – 開源的在線設計編輯器,Canva 開源平替
Doory是什麼 Doory 是開源的在線設計工具,開源的 Canva 替代品,運行在瀏覽器裏的全功能在線設計編輯器,可製作海報、社媒圖、簡歷、PPT、名片等。Doory支持導出 PNG/JPG/SVG/PDF/MP4/GIF,具備實時協同編輯、動畫特效、一鍵摳圖和私有化部署能力,完全免費無廣告,適合小團隊自建使用。 Doory的主要功能 模板設計:內置10個高頻率場景起步模板(海報、簡歷、邀請函等),也支持從空白畫布開始創作。 像素級畫布編輯:基於 Fabric.js 的畫板支持多頁面、多尺寸設計,配備對齊參考線、自動吸附和標尺。 圖層管理:每個元素都是圖層,可重命名、鎖定、隱藏、分組、拖拽排序,右鍵即可調整層級。 文字工具:支持標題、彎曲文字、文字效果、字體搭配,內置開放許可字體庫,也可上傳自有字體。 素材庫:自帶約25000個開放許可圖標、Emoji和插畫,支持上傳圖片、應用蒙版和濾鏡。 一鍵摳圖:背景移除模型直接在瀏覽器本地運行,無需上傳服務器。 動畫製作:提供27種入場/退場動畫、12種強調效果和16種頁面過渡,配時間軸編輯。 多格式導出:支持 PNG(透明)、JPG、SVG、PDF,動畫可導出 MP4/WebM/GIF。 微信關注回覆“開源”,加入AI開源項目交流羣 如何使用Doory 在線體驗: 打開官網:訪問 Doory 官網 https://doory.art/ 進入模板畫廊。 選擇模板:瀏覽或搜索模板,點擊”Use this template”進入編輯器;也可從空白頁開始。 編輯設計:點擊畫布上任意元素即可修改,左側欄可添加文字、形狀、貼紙、圖片、動畫、音頻等,上方工具欄調整字體、顏色、大小等屬性。 保存作品:遊客模式自動將設計保存在瀏覽器本地,點”Sign up”註冊後可將作品一鍵遷移到雲端。 分享協作:點擊右上角 Share 生成鏈接,可設密碼和”僅查看/可評論/可編輯”權限,多人實時協同編輯。 導出成品:點擊下載按鈕,選擇 PNG/JPG/SVG/PDF或 MP4/WebM/GIF導出。 Docker 私有化部署: 獲取代碼:git clone 倉庫到服務器,複製 .env.example 爲 .env。 配置環境變量:在 .env 中設置 DJANGO_SECRET_KEY(用 openssl rand -base64 48 生成)和 POSTGRES_PASSWORD。 啓動服務:運行 docker compose up -d --build,等待容器構建完成。 創建管理員:執行 docker compose exec api python manage.py createsuperuser 設置後台賬號。 填充內容:依次運行 seed_templates、seed_elements、sync_fonts、sync_element_packs、sync_audio 等命令導入模板、圖標、字體和音頻。 訪問使用:瀏覽器打開 http://localhost:8080可開始設計,管理員可登錄後台上傳自定義模板和素材。 Doory的核心優勢 數據自主可控:支持 Docker 一鍵私有化部署,所有設計文件和上傳素材都存儲在自己的服務器上,可對接 S3,徹底避免數據託管在第三方平台的風險。 功能完整度高:圖層、蒙版、濾鏡、彎曲文字、動畫時間軸、音頻、演示模式、版本歷史一應俱全。 實時協同編輯:基於 Yjs 的多人協作,實時光標、評論、權限分級,達到商業產品水準。 本地AI摳圖:背景移除模型直接在瀏覽器本地運行,圖片無需上傳服務器,速度快且保護隱私。 Doory的項目地址 項目官網:https://doory.art/ GitHub倉庫:https://github.com/shaongitbd/doory Doory的同類競品對比 對比維度 Doory Canva 開源 ✅ 開源(Attribution Assurance License) ❌ 閉源商業軟件 私有化部署 ✅ Docker 一鍵部署到自己的服務器 ❌ 僅限官方雲服務 數據控制 文件存儲在自己掌控的基礎設施上 數據託管在 Canva 服務器 免登錄使用 ✅ 遊客直接設計,作品存本地 ❌ 必須註冊賬號 實時協同編輯 ✅ 實時光標、評論、版本歷史 ✅ 支持團隊協作 動畫/視頻導出 ✅ MP4、WebM、GIF ✅ 支持 背景移除 ✅ 模型在瀏覽器本地運行 ✅ 雲端處理(免費版有限額) 模板庫 僅 10 個起步模板(可自行擴充) 百萬級模板庫,生態成熟 素材規模 約 25000 個圖標/Emoji 海量照片、視頻、字體
DMAD – 字節聯合德州農工開源的擴散模型少步蒸餾技術
DMAD是什麼 DMAD(Distribution Matching as Adversarial Distillation)是字節跳動與德州農工大學聯合開源的少步蒸餾框架,用於加速擴散模型生成。DMAD訓練二分類判別器直接學習目標分佈與學生分佈的差異,省去輔助擴散模型,將50步教師模型蒸餾爲4步學生模型。已支持ImageNet、SDXL、Wan2.1及MiniMax-H3-33B,8GB顯存可生成約5秒1344×768有聲視頻。 DMAD的主要功能 少步圖像生成:將 ImageNet-64 的 EDM 模型蒸餾至 1 步採樣,FID 低至 1.04,SDXL 僅需 4 步可文生圖。 少步文生視頻:把 Wan2.1-T2V-14B 蒸餾爲 4 步學生模型,VBench 達 85.15。 聯合音視頻生成:將 MiniMax-H3-33B 的 50 步教師模型蒸餾爲 4 步,輸出 1344×768 視頻與 32kHz 原生立體聲音頻。 消費級硬件支持:提供 8GB 顯存 ComfyUI 工作流與低顯存命令行推理,8GB 顯卡可生成約 5 秒、12GB 約 15 秒有聲視頻。 訓練與推理全開源:發佈蒸餾方法、訓練代碼、推理腳本及多模型 LoRA 權重,覆蓋命令行與 ComfyUI 兩種使用方式。 DMAD的技術原理 分佈匹配即對抗蒸餾:DMAD 爲訓練二分類判別器區分目標樣本與學生樣本,最優判別器的 logit 等於兩分佈的對數密度比,對其輸入求梯度即得 score 差,直接給出學生的修正方向,省掉輔助 score 擬合模型。 共享骨幹、雙頭判別器:判別器採用單一共享特徵骨幹、兩個判別頭,教師頭區分教師樣本與學生樣本,真實數據頭區分真實樣本與學生樣本,均用二元交叉熵訓練;學生用兩個 logit 的加權線性損失更新,更新時凍結判別器參數但保留梯度回傳。 噪聲區間動態加權:教師樣本與真實數據的分佈差異隨噪聲水平變化,DMAD 用真實數據頭在兩類樣本上的平均 logit 差作爲經驗信號,以 0.99 衰減的指數移動平均追蹤各噪聲區間,差距小的區間獲得更高教師權重,歸一化後參與學生損失。 離線教師樣本加速訓練:教師只提供預生成並緩存的樣本,訓練時無需在線調用教師。4 卡 H200、MiniMax-H3 rank-128 LoRA 配置下,每次學生更新及關聯判別器更新耗時從 818.1 秒降至 233.3 秒,實現約 3.51 倍訓練加速。 微信關注回覆“開源”,加入AI開源項目交流羣 如何使用DMAD 克隆倉庫:git clone https://github.com/Yzmblog/DMAD.git 並進入項目目錄。 創建環境:用 conda 創建 Python 3.12 環境並激活。 安裝依賴:按官方固定版本安裝 PyTorch 2.11.0(cu126)、torchvision、torchaudio,再執行 pip install -r requirements.txt 和 pip install -U modelscope-hub。 準備硬件:確保有支持 CUDA 的 NVIDIA 顯卡,並預留約 64GB 系統內存與 170GB 磁盤空間。 下載基礎模型:通過 modelscope download MiniMax/MiniMax-H3 下載 MiniMax-H3 基礎模型。 下載蒸餾權重:從魔搭下載 DMAD 的 4 步 LoRA。 命令行推理:運行 inference.py,指定模型路徑、LoRA、提示詞文件、--steps 4、--height 768 --width 1344,按顯存選擇 --low-vram 8或 --low-vram 12。 查看輸出:輸出目錄包含 0000.mp4、提示詞 txt 和 settings.json,跑通後可替換爲自己的提示詞文件。 DMAD的核心優勢 推理大幅提速:將 50 步教師模型蒸餾爲 4 步學生模型,去噪迭代減少 92% 以上,同時保持接近教師的生成質量。 訓練效率更高:判別器直接學習分佈差異,省去輔助擴散模型,4 卡 H200 上訓練更新加速約 3.51 倍。 生成質量領先:ImageNet-64 一步生成 FID 達 1.04,優於 DMD2、SiDA 等方法;人類評估中對 DMD2 總體偏好率 79.1%、對 rCM 達 84.6%。 覆蓋多模態全場景:同一框架統一支持圖像、文生視頻和聯合音視頻生成。 DMAD的項目地址 項目官網:https://yzmblog.github.io/projects/DMAD/ GitHub倉庫:https://github.com/Yzmblog/DMAD Huggin
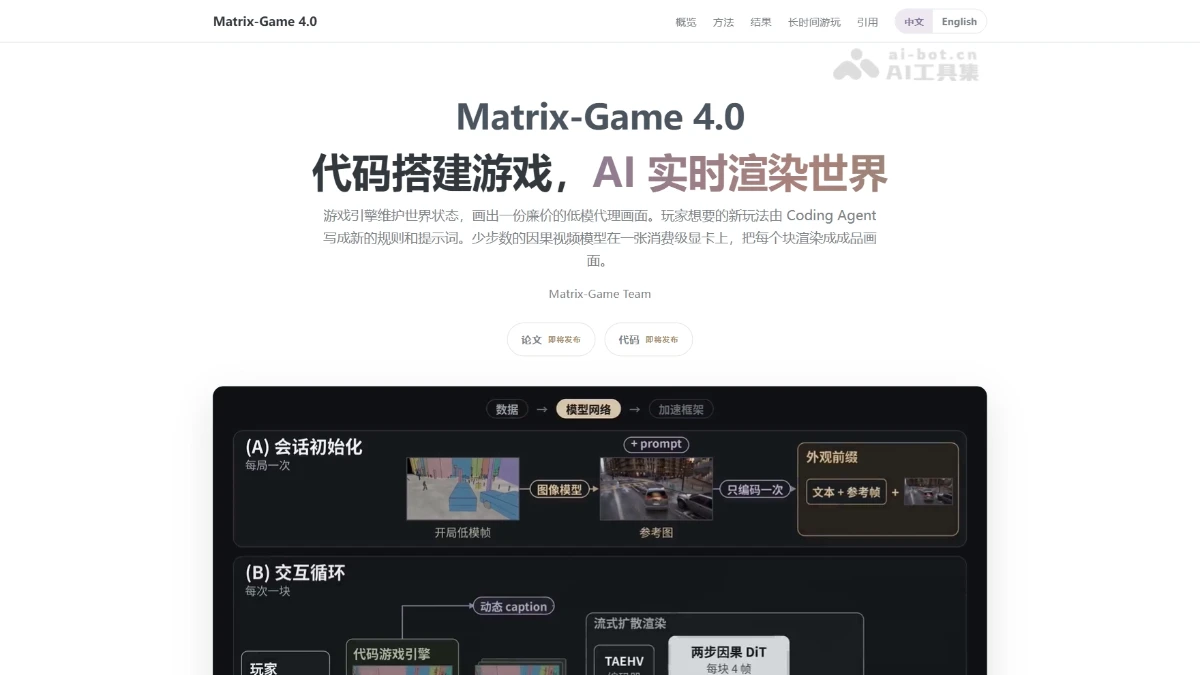
Matrix-Game 4.0 – 崑崙萬維開源顯卡運行的視頻大模型遊戲
Matrix-Game 4.0是什麼 Matrix-Game 4.0是崑崙萬維推出的全球首款運行在單張消費級顯卡上的視頻大模型遊戲,採用”Harness”新範式,遊戲引擎作爲裁判維護世界狀態與規則,Coding Agent 用自然語言改寫玩法,視頻模型作爲畫師實時渲染精細畫面。Matrix-Game 4.0單張 RTX 5090 可實現 480p、60 FPS、延遲低於150毫秒的遊戲體驗,讓小團隊能搭世界成爲現實。 Matrix-Game 4.0的主要功能 單卡實時運行:單張 RTX 5090 即可實現 480p、60 FPS、延遲低於 150 毫秒的可玩遊戲體驗。 自然語言改玩法:通過 Coding Agent 用一句指令調整地形、NPC 行爲或設計全新玩法規則。 世界狀態顯式管理:遊戲引擎以代碼維護血量、揹包、碰撞、勝負等狀態,物體離開視野仍持續演化。 低模轉精細畫面:視頻模型把引擎輸出的幾何結構畫面實時重渲染爲帶光影材質的 3A 級畫面。 長時間一致遊玩:支持 54-99 秒不間斷遊玩,場景、角色身份與交互結果保持穩定不漂移。 Matrix-Game 4.0的技術原理 Harness 架構:系統給視頻模型套上由 Coding Agent 和遊戲引擎組成的Harness,引擎負責規則之內的狀態演化並輸出結構畫面,Coding Agent 把用戶意圖轉成新規則與細化提示詞,視頻模型只專注渲染,三者分工解耦。 結構-精細畫面對齊數據:基於 UE5 構建跨域數據集,用輕量化幾何抽象採集管線將複雜場景抽象爲保留空間拓撲的低模結構表徵,與高模畫面逐幀像素級對齊,同步捕獲實例 ID 與因果事件元數據。 動態 Caption:系統將物體 ID 與語義描述關聯,運行時從引擎讀取當前可見對象及實時狀態填入提示詞模板,與結構畫面配合,共同提供畫什麼、畫在哪的條件約束。 可控 V2V 生成:基於 Wan2.2 5B 改造,結構畫面與待生成視頻以 148 通道拼接輸入 30 層因果 DiT,自注意力讀取空間記憶與歷史 KV 緩存,交叉注意力讀取文本條件,用自迴歸方式逐塊生成。 微信關注回覆“開源”,加入AI開源項目交流羣 如何使用Matrix-Game 4.0 消費級單卡實時:單張 RTX 5090 跑出 480p、60 FPS、112ms 延遲,首次讓視頻模型遊戲走出實驗室的多卡集羣。 世界狀態顯式可管:遊戲引擎以代碼維護世界規則,狀態可讀取、可修改、可驗證,根治了上一代世界只存在模型記憶裏的漂移問題。 一句話改玩法:Coding Agent 將自然語言指令直接轉爲遊戲規則與代碼,創意迭代不再受 3D 資產生產線拖累。 長時間穩定一致:空間記憶 + 參考幀 + 動態 Caption 機制,保障長時段遊玩中場景結構和物體身份不崩壞。 性能斷層領先:延遲約爲 Code World Model 的 1/90、StreamRender-H3 的 1/5,且對端是唯一消費級方案。 Matrix-Game 4.0的核心優勢 消費級單卡實時:單張 RTX 5090 跑出 480p、60 FPS、112ms 延遲,首次讓視頻模型遊戲走出實驗室的多卡集羣。 世界狀態顯式可管:遊戲引擎用代碼維護世界規則,狀態可讀取、可修改、可驗證。 一句話改玩法:Coding Agent 將自然語言指令直接轉爲遊戲規則與代碼,創意迭代不再受 3D 資產生產線拖累。 長時間穩定一致:空間記憶 + 參考幀 + 動態 Caption 機制,保障長時段遊玩中場景結構和物體身份不崩壞。 性能斷層領先:延遲約爲 Code World Model 的 1/90、StreamRender-H3 的 1/5,且對端是唯一消費級方案。 Matrix-Game 4.0的項目地址 項目官網:https://matrix-game-v4-0.github.io/page/ GitHub倉庫:https://github.com/SkyworkAI/Matrix-Game.git HuggingFace模型庫:https://huggingface.co/Skywork/Matrix-Game-4.0 Matrix-Game 4.0的同類競品對比 對比維度 Matrix-Game 4.0 StreamRender-H3 端到端延遲 112ms(實時可玩) 約 545ms 硬件要求 單張 RTX 5090(消費級,32GB) 8× GB200(數據中心級) 分辨率/幀率 480p @ 60 FPS 未達消費級實時標準 世界狀態管理 引擎顯式維護,可讀取/修改/驗證 主要依賴模型內部表示 玩法定製
HelixWorld – Noiz AI 聯合港科大開源的實時交互世界模型
HelixWorld是什麼 HelixWorld 是 Noiz AI 與港科大聯合開源的實時交互式音視頻世界模型。給模型一張起始圖片和文字描述,可通過 WASD 和方向鍵在 AI 生成的世界中行走、轉頭,畫面與立體空間音效同步實時生成,且聲像隨視角自然變化。HelixWorld 基於 LTX-2.3 構建,採用”雙向教師 + 因果蒸餾”訓練,單張 H800 顯卡可實現 768×512 分辨率、24 FPS 的實時生成。配套發佈 HelixBench 基準,專門評估空間聲學一致性。 HelixWorld的主要功能 實時可交互世界生成:輸入起始圖片和文字描述,可在 AI 生成的世界中自由探索。 鍵盤/動作操控:WASD 控制移動、方向鍵調整視角,畫面隨操作即時響應。 原生音視頻聯合生成:視頻與立體聲音頻同步生成,非後期配音。 空間聲學一致性:聲像隨鏡頭轉動自然變化,如左側聲源轉身後面向時聲音方向隨之改變。 三軌解耦提示詞:分別用視頻、音頻、音視頻聯合描述控制生成內容。 實時流暢體驗:單張 H800 顯卡上達到 768×512 分辨率、24 FPS 實時生成。 HelixWorld的技術原理 雙向教師模型預訓練:先訓練一個雙向音視頻擴散模型作爲教師:連續 6-DoF 相機軌跡通過 PRoPE 注入視覺注意力,81 類離散動作經 AdaLN-Zero 調製擴散時間步,跨模態注意力把相機運動傳遞到音頻分支,使聲音自然產生立體聲像變化。 因果蒸餾實現實時化:將教師模型蒸餾爲少步因果學生模型:視頻潛變量與音頻 token 分塊處理,塊內雙向注意力、塊間通過 KV cache 因果連接,配合 ODE 初始化使學生能以 4 步完成去噪,滿足實時推理需求。 在線軌跡蒸餾抑制漂移:針對自迴歸長程生成的誤差累積問題,訓練時用教師 Probability Flow ODE 的終點爲目標監督學生速度場,與分佈匹配損失(DMD)隨機交替使用,兼顧生成多樣性與長程穩定性。 長程流式微調:通過滑窗 KV cache 逐段展開長序列訓練,保留 sink 幀錨點、歷史梯度截斷,配合約一分鐘的長序列微調,進一步減少長時間生成中的畫面漂移與聲音退化。 微信關注回覆“開源”,加入AI開源項目交流羣 如何使用HelixWorld 方式一:在線體驗 打開官網 https://helixworld.org,選擇示例圖片或上傳自己的圖片。 填寫場景的文字描述。 進入世界後用 WASD 移動、方向鍵轉動視角,實時探索生成內容。 運行過程中還可隨時修改提示詞,調整後續生成的場景。 方式二:本地部署 環境準備:Linux 系統、Python 3.11、CUDA 12.x、NVIDIA 顯卡(建議 80GB 顯存)、ffmpeg 和 ffprobe。 下載項目並安裝依賴:git clone https://github.com/NoizAI/HelixWorld.git,創建 conda 環境後 pip install -r requirements.txt。 運行 python download_models.py 下載模型權重。 準備一張起始圖片,通過 ./run.sh 指定圖片、畫面/聲音/聯合提示詞、動作序列等參數,生成 MP4 輸出到 outputs 目錄。 HelixWorld的核心優勢 首個開源實時交互式音視頻世界模型:畫面與空間立體聲在用戶操控下聯合實時生成,代碼和權重完全開放。 真正的”轉頭即變聲”:聲像嚴格跟隨視角轉動,空間一致性得分數倍於同類。 單卡即可實時:單張 H800 實現 24 FPS、RTF 0.77 實時生成,速度是同類的 2.5 倍以上。 長程生成不漂移:在線軌跡蒸餾 + 長程微調,30 秒以上連續生成畫面聲音依然穩定,且多樣性不降反升。 音頻質量全面領先:HelixBench 核心指標全面最優,用戶盲測帶音頻場景下以 67.9% 偏好率碾壓對手。 HelixWorld的項目地址 項目官網:https://helixworld.org/ GitHub倉庫:https://github.com/NoizAI/HelixWorld arXiv技術論文:https://arxiv.org/pdf/2609.38123 HelixWorld的應用場景 沉浸式遊戲原型:無需建模和引擎,輸入圖片即可生成可行走探索的開放世界,大幅縮短遊戲 Demo 開發週期。 VR/AR 虛擬空間:第一人稱視角 + 空間音頻的組合天然適配頭顯設備,可快速生成虛擬展廳、數字孿生環境。 影視與廣告預演:導演上傳概念圖即可”走進”場景試聽音畫效果,在實拍前低成本驗證鏡頭語言和氛圍設計。 AI 視頻通話/虛擬主播背景:根據語音
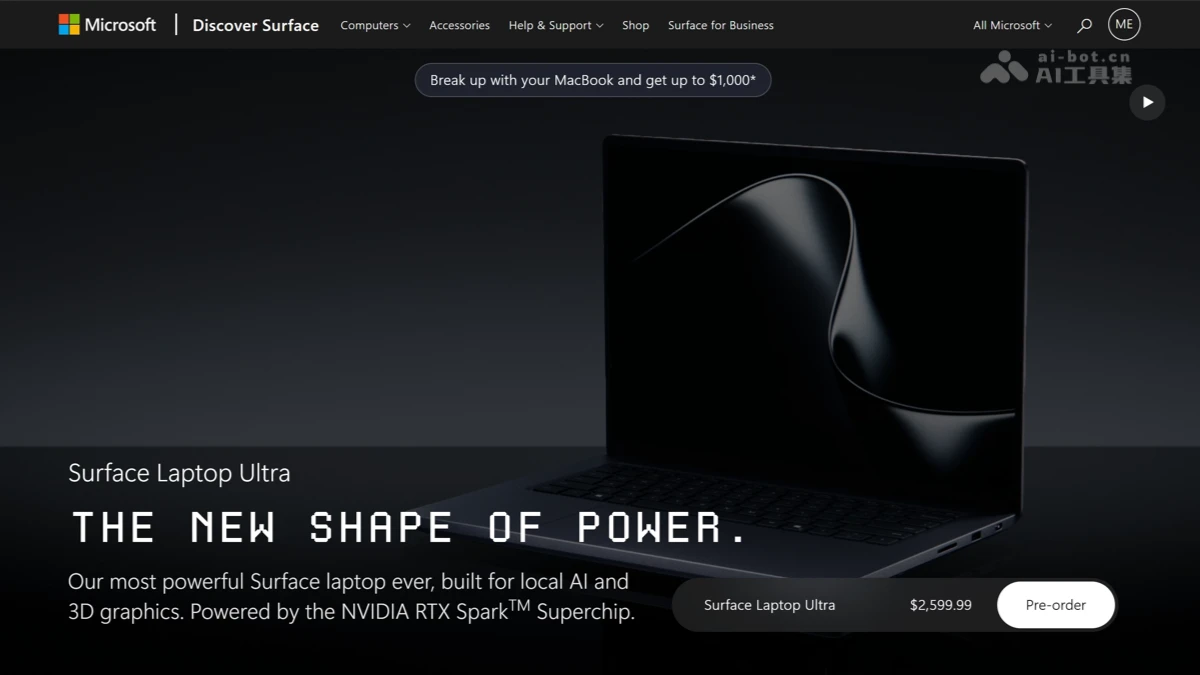
Surface Laptop Ultra – 微軟聯合英偉達推出的最強 AI PC
Surface Laptop Ultra是什麼 Surface Laptop Ultra是微軟推出最強Surface PC,搭載英偉達RTX Spark N1X超級芯片,最高20核CPU+6144核GPU+128GB統一內存,本地AI算力達1PFLOPS,可運行超1200億參數大模型。Surface Laptop Ultra採用15英寸PixelSense Ultra觸控屏、磁吸式USB-C充電,續航一整天,專爲AI開發、創意工作與智能體場景打造。 Surface Laptop Ultra的主要功能 本地跑大模型:1PFLOPS算力+128GB統一內存,本地運行超1200億參數模型。 AI編程:本地跑MAI-Code-1.1-Flash,Copilot智能編排本地與雲端任務。 智能體運行:配合MXC沙箱安全運行OpenClaw、Codex等智能體。 視頻創作:支持電影級視頻編輯,AI視頻生成比M5 Pro快6.2倍。 遊戲:光線追蹤+DLSS,《戰爭機器》穩定60幀。 屏幕:15英寸觸控屏,HDR亮度比MacBook Pro M5高25%。 磁吸充電:全球首款內置磁吸式USB-C接口。 擴展性:3個USB-C+HDMI等接口,可驅動3台4K顯示器,存儲可拆卸升級。 續航散熱:散熱提升2.5倍,續航滿足一整天。 Surface Laptop Ultra的規格參數 芯片:英偉達RTX Spark N1X超級芯片,Grace CPU + Blackwell RTX GPU,互聯速度600GB/s CPU:最高20核,入門版爲18核 GPU:最高6144核,入門版爲5120核 AI算力:1 PFLOPS FP4,可本地運行超1200億參數模型 內存:24GB家庭版或32GB~128GB專業版LPDDR5x統一內存 存儲:512GB~1TB固態硬盤,支持用戶自行拆卸、升級和更換 屏幕:15英寸PixelSense Ultra觸控屏,HDR峯值亮度比MacBook Pro M5高25% 機身:厚度不足18mm,重量不足4.5磅 散熱:全新散熱架構,散熱能力爲現有Surface筆記本的2.5倍 電池:續航滿足一整天使用 接口:3個USB-C,含全球首款內置磁吸式充電接口Magnetic Connect),、HDMI、USB-A、SD卡讀卡器、3.5mm耳機插孔,可驅動最多3台4K顯示器 操控:觸控板面積增大30%,配備先進觸覺反饋技術 系統:Windows 11家庭版/專業版 遊戲技術:英偉達光線追蹤、DLSS、Reflex Surface Laptop Ultra的價格配置 入門版2599美元,約17425元,18核CPU+5120核GPU+24GB+512GB 頂配5899.99美元,約39557元,20核CPU+6144核GPU+128GB+1TB Surface Laptop Ultra的購買地址 官方購買地址:https://www.microsoft.com/en-us/store/configure/surface-laptop-ultra/8wg5vqp0x4b8 Surface Laptop Ultra的應用場景 本地AI開發:依託1PFLOPS算力和128GB統一內存,開發者可在本地運行1200億參數大模型及MAI-Code-1.1-Flash,無需聯網即可完成代碼生成與調試。 企業智能體辦公:通過MXC安全沙箱隔離運行OpenClaw、Codex等智能體,自動完成文件整理、郵件歸檔等流程性工作。 影視內容創作:藉助AI圖像生成4.3倍、視頻生成6.2倍於M5 Pro的速度,創作者可本地完成電影級剪輯與AI素材生成。 隱私敏感計算:醫療、法律、金融行業的機密數據全程在本地處理,無需上傳雲端即可滿足合規要求。
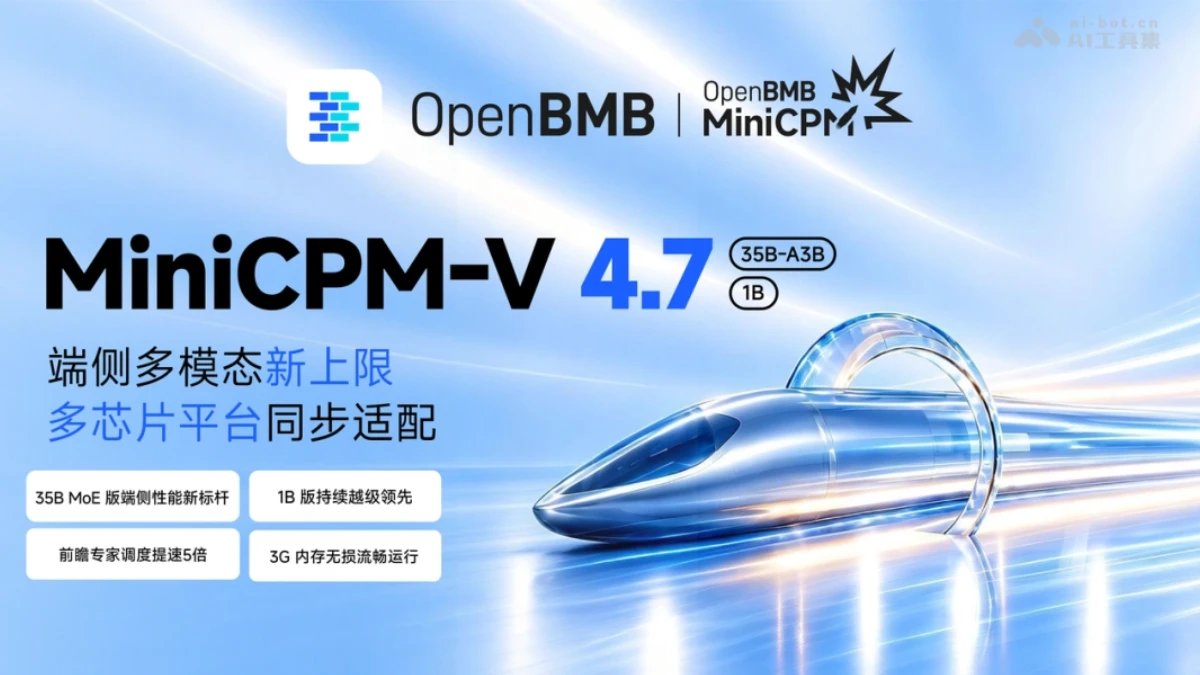
MiniCPM-V 4.7 – 面壁智能等開源的端側多模態大模型
MiniCPM-V 4.7是什麼 MiniCPM-V 4.7 是面壁智能聯合 OpenBMB 開源的端側多模態大模型,含 35B-A3B(MoE)與 1B 兩個版本。旗艦版爲全球首個可在手機端無損流暢運行的開源 MoE 多模態模型,藉助前瞻專家調度技術,約 3GB 內存可在 iPhone 上達 13+ tokens/s,34 項基準全面領先同檔模型;1B 版面向入門級設備。 MiniCPM-V 4.7的主要功能 通用視覺理解:看圖識物、多圖對比、視覺問答,MMBench 91.72 分領先同檔模型。 文檔與 OCR 解析:識別圖片/PDF 中的文字、表格與圖表,OCRBench 91.2 分。 數學與 STEM 推理:解答數學題、科學問題,MMMU 80.22、MathVista 88 分。 長視頻理解:理解長時序視頻內容並回答相關問題,LongVideoBench 68.9 分。 端側流暢運行:35B 模型在 iPhone 上僅佔約 3GB 內存、13+ tokens/s 實時生成。 低成本定製微調:開源自回放微調,學新任務不忘舊能力。 MiniCPM-V 4.7的技術原理 前瞻專家調度(LES):MoE 模型 65.6 GiB 的權重無法全量入內存,大部分專家存於 SSD、用時讀取,但逐層路由依賴上一層結果,導致每層都要停等讀盤。LES 用相鄰層輸入高度相似的特點,用當前層路由特徵提前預測下一層所需專家並後台預取,同時讓已加載且被真實路由選中的專家優先計算,實現邊算邊讀,實測提速 5 倍且輸出零損失。 權重存取優化:通過逐層混合精度量化減少權重的存儲體積與傳輸量;同時重組專家權重在文件中的佈局,將原本分散三處的參數改爲按編號連續存放,使 SSD 一次順序讀取即可取出完整專家,大幅降低加載開銷。 視覺 token 壓縮:基於 LLaVA-UHD v4 在視覺編碼器內部提前壓縮 token,從源頭減少後續計算;支持 4 倍/16 倍兩檔壓縮率切換,16 倍模式下關鍵指標幾乎無損,兼顧畫質細節與實時交互。 DSpark 投機解碼:由輕量草稿模塊一次生成多個候選 token,主模型並行驗證後批量產出,多個 token 分攤 MoE 的專家讀取與調度等固定成本,實測生成速度平均提升 1.17 倍且質量不受影響。 微信關注回覆“開源”,加入AI開源項目交流羣 如何使用MiniCPM-V 4.7 獲取模型:從 GitHub、Hugging Face下載模型權重與代碼。 本地快速體驗:訪問 Hugging Face Spaces 上的官方 Web Demo(MiniCPM-V-4.7-Demo)可免安裝在線試玩。 安裝 App:前往 GitHub 的 MiniCPM-V-Apps 倉庫下載 iOS/Android 客戶端,在手機或平板上直接安裝使用。 選擇推理框架部署:根據硬件平台選用 llama.cpp、Ollama、MLX 或 vLLM/SGLang 之一加載模型,完成本地推理服務部署。 啓用 LES 加速(可選):端側運行 35B-A3B 時,按開源文檔開啓前瞻專家調度,實現 3GB 內存流暢運行。 選擇視覺壓縮模式:根據需求切換 4 倍壓縮或 16 倍壓縮模式。 MiniCPM-V 4.7的項目地址 GitHub倉庫:https://github.com/OpenBMB/MiniCPM-V HuggingFace模型庫:https://huggingface.co/collections/openbmb/minicpm-v-47 MiniCPM-V 4.7的核心優勢 端側 MoE 全球首創:全球首個可在端側無損、流暢運行的開源 MoE 多模態大模型。 極致內存效率:65.6 GiB 權重的 35B 模型僅需約 3GB 內存即可運行,爲 16GB 設備內存的 1/4。 推理速度領先:iPhone 17 Pro Max 實測 13+ tokens/s,iPad Pro M4 達 17+ tokens/s,LES 技術提速 5 倍。 性能全面碾壓同檔:34 項權威基準全面領先 Qwen3.6-35B-A3B,甚至超越體量更大的 Qwen 27B、Gemma-4 31B。 性能與效率帕累托最優:更短推理時間取得更高綜合得分,刷新端側多模態”性能—效率”前沿。 雙版本普惠覆蓋:35B 旗艦拉能力上限,1B 小鋼炮讓入門級設備也能跑高質量多模態。 MiniCPM-V 4.7的同類競品對比 對比維度 MiniCPM-V 4.7 35B-A3B Qwen3.6-35B-A3B 推理速度 iPhone 17 Pro Max 13+ tokens/s,LES 提速 5 倍 較慢(同檔中處於
福客 AI 客服上手實測 – 全流程覆蓋售前導購+售後處理
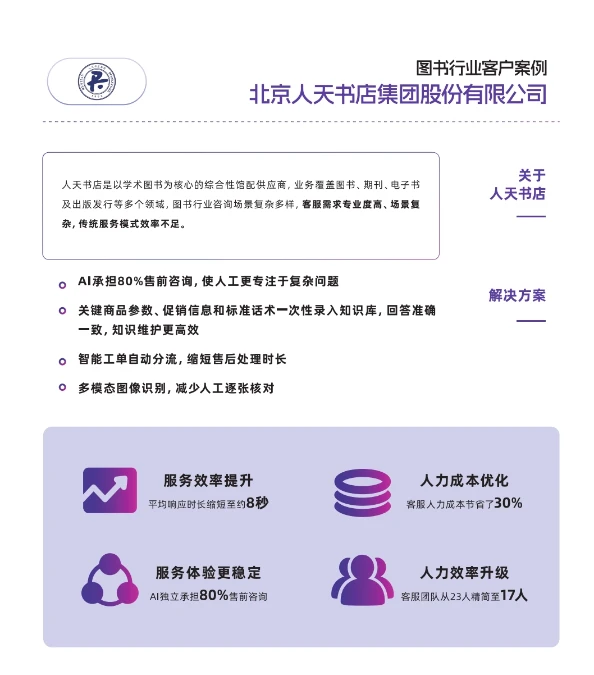
一年中流量最貴的幾十天,已經到了。 爲了雙11,很多電商老闆咬着牙在直通車和投流上砸了重金。但現實往往很扎心:推廣費大把花出去,後台諮詢消息瞬間爆紅,客服打字打到鍵盤冒煙,回覆還是慢了半拍。 在電商大促裏,讓顧客多等30秒,對方大概率就切到別家下單了。 如果爲了圖快,全盤交給傳統關鍵詞機器人,三句不離“親親在的呢”,顧客問東它答西,更是分分鐘把高意向買家直接勸退。更尷尬的是短期兼職客服:培訓要大半個月,大促提成高,大促一過還得遣散,用人成本居高不下。 有一批商家摸索出了低成本破局的辦法: 做服裝的 ELOF女裝,靠着 AI 預接待+人工兜底,客服團隊縮減了 75%,按單人全包年薪 6-7 萬元折算,一年直接省下 50 多萬; 專做圖書的人天書店,直接把 80% 的售前重複諮詢交給了 AI,客服團隊精簡了近三分之一,人力成本直降 30%。 他們背後用的都是拿過阿里巴巴戰略投資的福客 AI。 很多商家心裏都打鼓:大促交易鏈條這麼複雜,稍有不慎就是投訴和僅退款,到底哪些髒活累活能放心交給 AI ?它會不會在價格和承諾上滿嘴跑火車? 帶着這幾個核心痛點,我自己上手把福客 AI 徹底體驗了一遍。 01. 會思考的 AI 客服 我們打開 福客 AI,可以看到它支持淘寶/天貓、拼多多、抖音、京東、快手、微信小店等多個電商平台。 點擊平台後面的聚。接入後的多個平台、多個店鋪,會在同一個側邊欄中集中接待,不需要我們頻繁切換軟件和頁面。 高峯秒回絕不能滿嘴跑火車 大促期間,諮詢高峯一波接一波。很多老闆不敢用 AI,不是嫌它不夠快,而是怕它太愛表現,隨口給顧客承諾福利,最後全是店鋪買單。 我們在福客 AI 側邊欄中選擇店鋪語料知識庫。 把店鋪問答、商品參數等信息喂進去,大概花了不到十分鐘。 我們發起諮詢,發送一個商品鏈接,福客 AI 客服會自動搜索店內的知識庫內容,回覆商品介紹。 商品材質、現貨庫存、發貨時效……福客 AI 幾乎全做到了秒級應答。 最關鍵的是,在回覆信息時,福客會自動標記回覆的置信度。 簡單來說:只要在知識庫裏找到了 100% 匹配的鐵證,AI 纔會秒級自動發送。 一旦顧客問到知識庫裏沒有的信息,系統會判定爲低置信度,立刻靜默攔截,絕不擅自作主。 這時候,福客 AI 會在快速擬好一條高情商建議回覆,人工客服掃一眼覺得沒問題,點一下發送即可。 我們可以自由設置置信度閥值,減少 AI 一本正經胡說八道的商業風險。 這一套下來,至少能把日常 70% 以上查物流、問參數的重複勞動徹底濾掉,不僅保住了黃金進店前 30 秒的響應率,還把商業風險牢牢卡死在規則線內。 顧客猶豫不決時,怎麼像金牌導購一樣推一把? 傳統機器人最讓人頭疼的,就是隻會死板地一問一答,顧客一追問就傻眼了。福客 AI 的導購邏輯明顯更懂做生意。 我模擬一位女裝買家,進行連續提問:有連衣裙嗎 此時福客 AI 會調用智能商品推薦 Skill ,推薦了一款中長的牛仔連衣裙。 我們繼續諮詢:跟這款有什麼區別 智能商品對比 SKill 會精準拆解服裝特點,像線下的金牌導購一樣,從版型設計、面料、風格到穿着場景,條理清晰地拆解了差異。 165cm,100斤,選哪個碼 福客 AI 會調用尺碼推薦 Skill 動態給出合身建議。 很多大促流失的訂單,往往就卡在顧客選碼糾結的那幾分鐘裏。 把這個環節做透,不僅是幫人工省時間,更是在源頭上把買錯尺碼導致的退換貨率壓了下來。 大促催付回不過來?把瀕臨流失的訂單拉回來 大促期間,諮詢後不買、拍下不付款是流失率非常高的環節。 人工客服忙着回新消息,根本沒精力做個性化挽留催付。 當顧客諮詢完商品突然沒動靜,或者拍下超過設定時間未付款,福客 AI 會自動發起一輪輕量提醒,比如補充優惠券提醒,或者解答疑慮。 福客的福脈功能支持人工或 AI 在後台悄悄給買家打標籤,比如高意向、歷史諮詢、大客戶。 我們設置標籤,福客 AI 會根據我們設置的條件自動完成打標。 客戶這次沒買不要緊,諮詢中留下的需求和意向也能成爲後續跟進的線索。 福客 AI 的福脈功能支持客戶打標和分羣,運營可以根據不同的標籤客羣制定針對性的營銷計劃,讓 AI 客服接待中累計的信息,繼續服務與後續的客戶經營。 售後處理,如何快而不亂? 過去機器人最怕圖片和視頻,顧客甩一張照片,傳統客服只會機械回覆,根本處理不了問題。 福客 AI 的圖像/視頻識別 Skill 可以直接看懂客戶發的圖片和視頻內容。 我發了張有明顯瑕疵的圖片,一句話都沒說。 福客 AI 的多模態能力直接看懂了圖片上的瑕疵位置,第一句話就是標準的高情商安撫:“寶子,看到圖片裏裙襬的破損確實讓人心疼呢……” 但這裏必須說清楚一個關鍵機制:涉及退換貨、補發或退款補償等利益承諾,福客 AI 並不會直接替店鋪
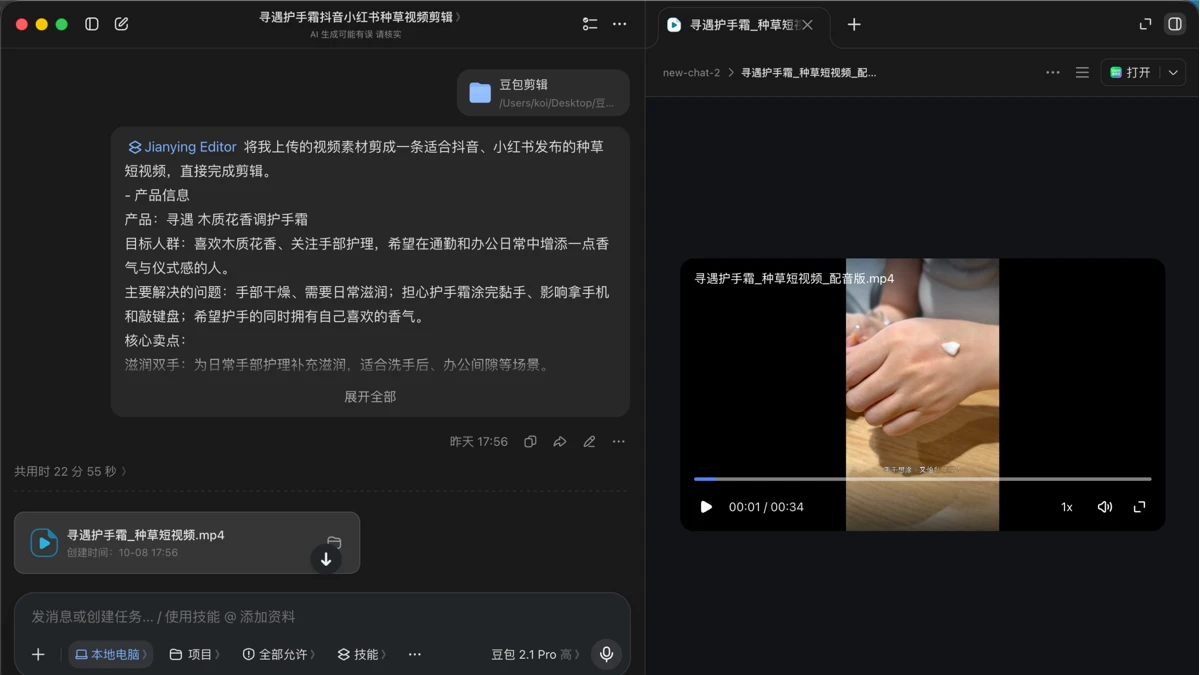
怎麼用豆包工作操作剪映,附 AI 剪視頻完整教程
友友們,你們相冊裏有多少視...
Kling 4.0 – 快手推出的新一代 AI 視頻生成模型
Kling 4.0是什麼 Kling 4.0 ...
LibTV 1.5 升級實測 – AI 視頻製作一站搞定
現在隨便去刷一個視頻平台,...
M3.1-Flash-Preview – MiniMax 推出的最新文本編程模型
M3.1-Flash-Preview是什麼 M3.1-Flash-Preview 是 MiniMax 推出的最新文本模型,首發上線 MiniMax Code。M3.1-Flash-Preview 面向日常開發場景,支持原生多模態輸入和百萬級上下文,可從 Bug 修復到完整功能開發形成定位→實現→測試→交付閉環。M3.1-Flash-Preview提供 low 至 max 五檔推理強度控制。目前僅限 MiniMax Code 和 Token Plan 使用。 M3.1-Flash-Preview的主要功能 日常開發交付:從 Bug 修復到完整功能開發均可穩定交付,可靠覆蓋日常編碼需求。 需求深度理解:能深入理解開發需求,細緻處理各種邊界情況。 迴歸測試補齊:自動生成並補齊迴歸測試用例,保障代碼質量。 改動影響驗證:可驗證代碼改動對現有功能的影響,降低迴歸風險。 原生多模態輸入:支持文本、圖像、視頻等多種輸入形式,理解更直觀。 百萬級上下文窗口:可處理超大代碼庫和長文檔,適合大型項目分析。 五檔推理強度控制:提供 low 至 max 五檔 Effort 調節,平衡速度與深度。 開發閉環支持:形成問題定位→代碼實現→測試驗證→成果交付的完整開發流程。 M3.1-Flash-Preview的技術原理 MoE + 稀疏注意力底座:繼承 M3 的 428B 總參、每 token 僅激活約 23B 的稀疏混合專家架構,核心是自研 MSA,通過 KV 分塊和動態選擇相關塊替代全量注意力,將百萬級上下文的計算量壓縮至前代的約 1/20,實現長文本下的高速推理。 全稀疏化改造:M3 前三層的全注意力錨點層被替換爲 MSA 稀疏層,每個 token 只關注上下文的選定子集,消除模型中最後的全注意力計算瓶頸,進一步降低長序列處理成本。 激進量化壓縮:採用 Q8KV4 混合精度 KV Cache和 W4A4 NVFP4 專家量化,KV 緩存內存約爲 M3 的一半,顯著降低顯存佔用。 投機解碼加速:用 DSpark 投機解碼頭取代 M3 的 EAGLE 多頭預測頭,由高效小模型先”猜測”token、大模型並行驗證,大幅提升生成吞吐。 如何使用M3.1-Flash-Preview 下載安裝 MiniMax Code:訪問 MiniMax Code 官網下載對應系統版本並完成安裝。 註冊/登錄賬號:打開客戶端,用 MiniMax 賬號登錄。 選擇模型開始對話:在模型選擇器中切換至 M3.1-Flash-Preview,按需調整推理強度(low 至 max 五檔)。 輸入開發任務:用自然語言描述需求,M3.1-Flash-Preview 會完成定位、實現、測試驗證並交付代碼。 M3.1-Flash-Preview的核心優勢 開發全流程閉環:從問題定位、代碼實現到測試驗證、成果交付一站式完成,覆蓋日常開發全場景。 邊界情況處理細緻:能深入理解需求並妥善處理各種邊界條件,交付質量穩定可靠。 極速響應:約 280ms 首字延遲、126 tokens/秒 生成速度,輕量任務體驗接近瞬時。 超長上下文:支持百萬級上下文窗口,可一次性處理大型代碼庫和長文檔。 原生多模態:支持文本、圖像、視頻輸入,需求理解更直觀準確。 推理強度可調:low 至 max 五檔 Effort 控制,可按任務複雜度平衡速度與深度。 成本極低:MoE + MSA 稀疏架構配合激進量化,token 消耗和算力成本大幅低於同檔模型。 M3.1-Flash-Preview的同類競品對比 維度 M3.1-Flash-Preview(MiniMax) Kimi K2.7 Code(月之暗面) 架構 MoE(繼承 M3 底座,官方未公佈規格) 1T 總參 / 32B 激活 MoE,MLA 注意力 上下文窗口 100 萬 token 256K token 推理強度 low / medium / high / xhigh / max 五檔 鎖定思維模式,不可關閉 首字延遲 約 280ms(Low 檔 210ms) 未公開,以長思考爲主 輸出速度 約 126 tokens/秒 有高速版(kimi-for-coding-highspeed),輸出提升 5-6 倍 多模態 文本 / 圖像 / 視頻輸入 文本 / 圖像 / 視頻輸入(MoonViT) M3.1-Flash-Preview的應用場景 日常 Bug 修復:針對報錯日誌和代碼片段快速定位問題根因,Medium 檔可在 320ms 首字延遲內完成邊界條件檢查並給出修復方案,適合高頻迭代的敏捷開發。 完整功能開發:從需求描述到可運行代碼的全流程交
剪映Hub – 剪映推出的一站式 AI 視頻創作入口
剪映Hub是什麼 剪映Hub是剪映...
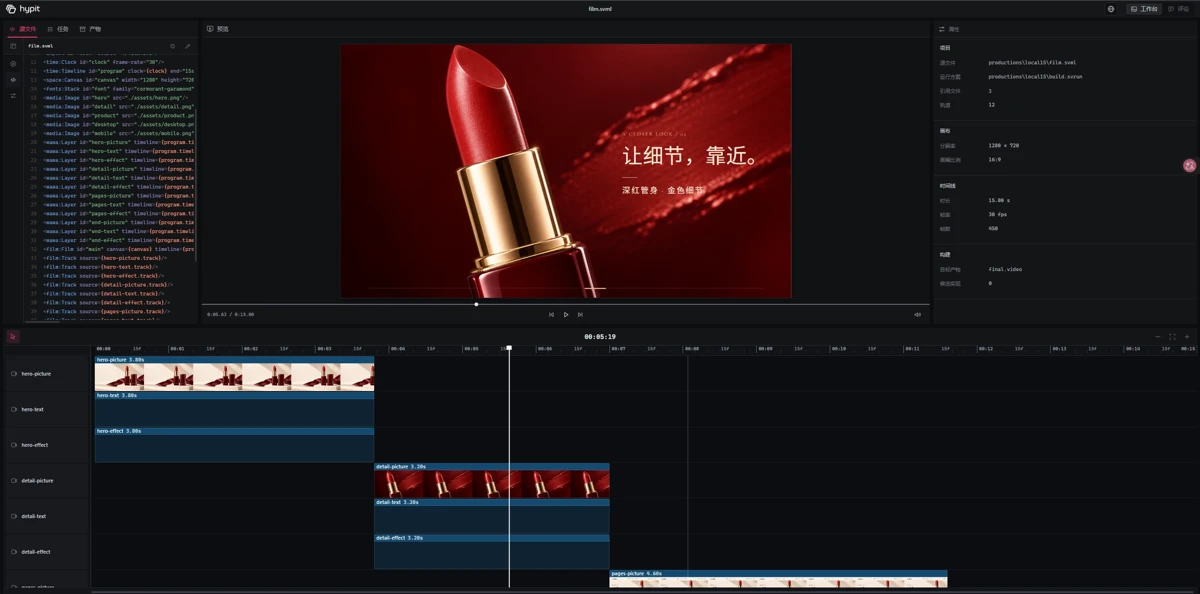
Hypit 實測 – 一句話讓 AI Agent 復刻爆款視頻
平時刷到一條不錯的視頻時,...