最好用的AI工具
精品文章
2,234 個結果
7 個開源 AI Agent vs Claude Code 橫評,誰更好用?
現在各方面的開源 Agent 太多...
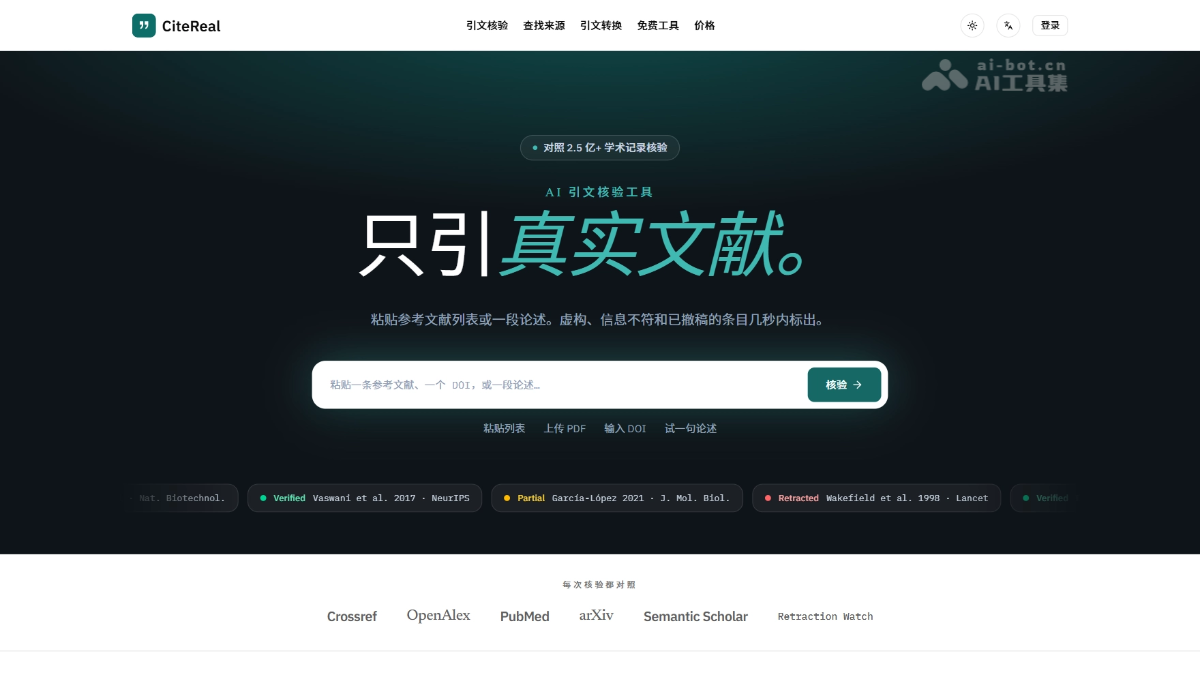
CiteReal – AI引文覈驗與文獻溯源工具,查找真實來源
CiteReal是什麼 CiteReal 是A...
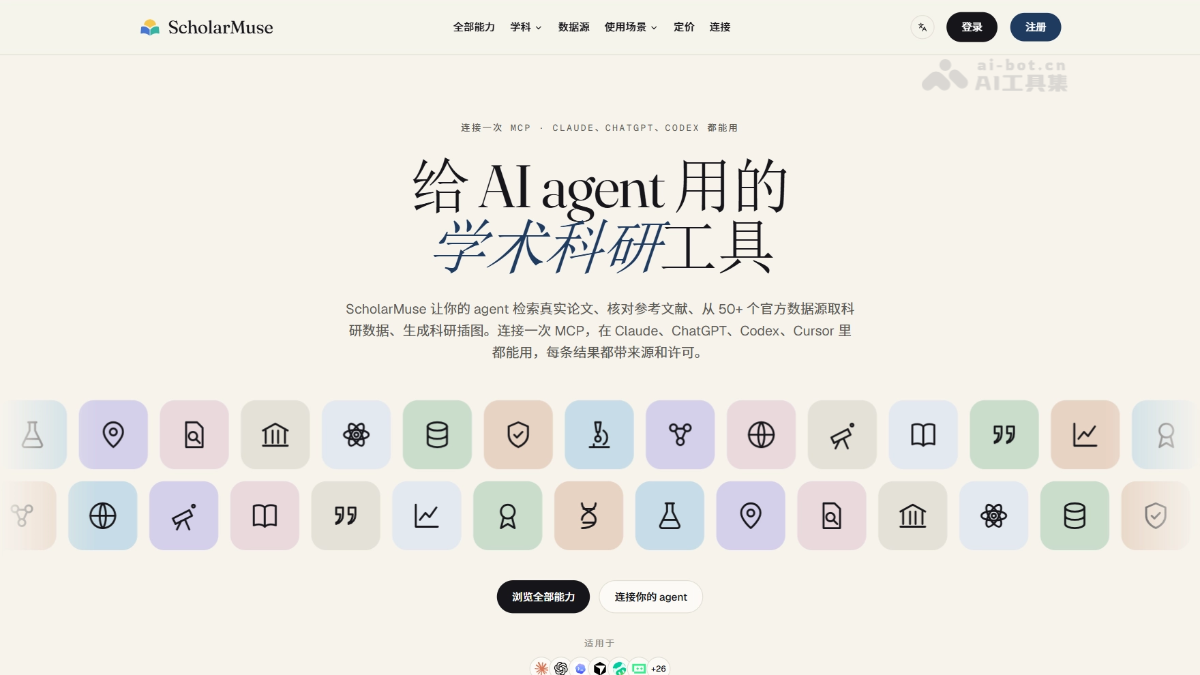
ScholarMuse – 把論文檢索與科研數據接入現有 AI 助手
ScholarMuse是什麼 ScholarMu...
Synvas – AI 視頻畫布創作工具,支持邊生成、邊剪輯
Synvas是什麼 Synvas 是 AI ...
Void – 開源的全棧開發部署工具,創作部署一體化
Void是什麼 Void 是尤雨溪團...
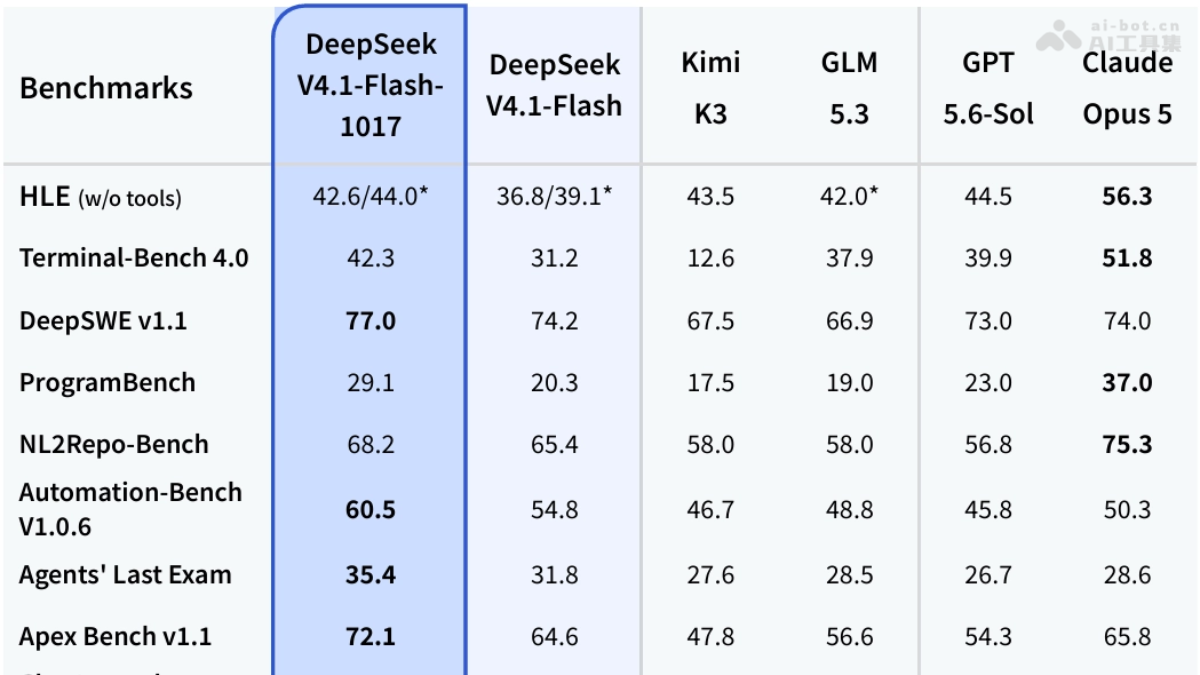
DeepSeek-V4.1-Flash-1017 – DeepSeek推出的最新優化版
DeepSeek-V4.1-Flash-1017是...
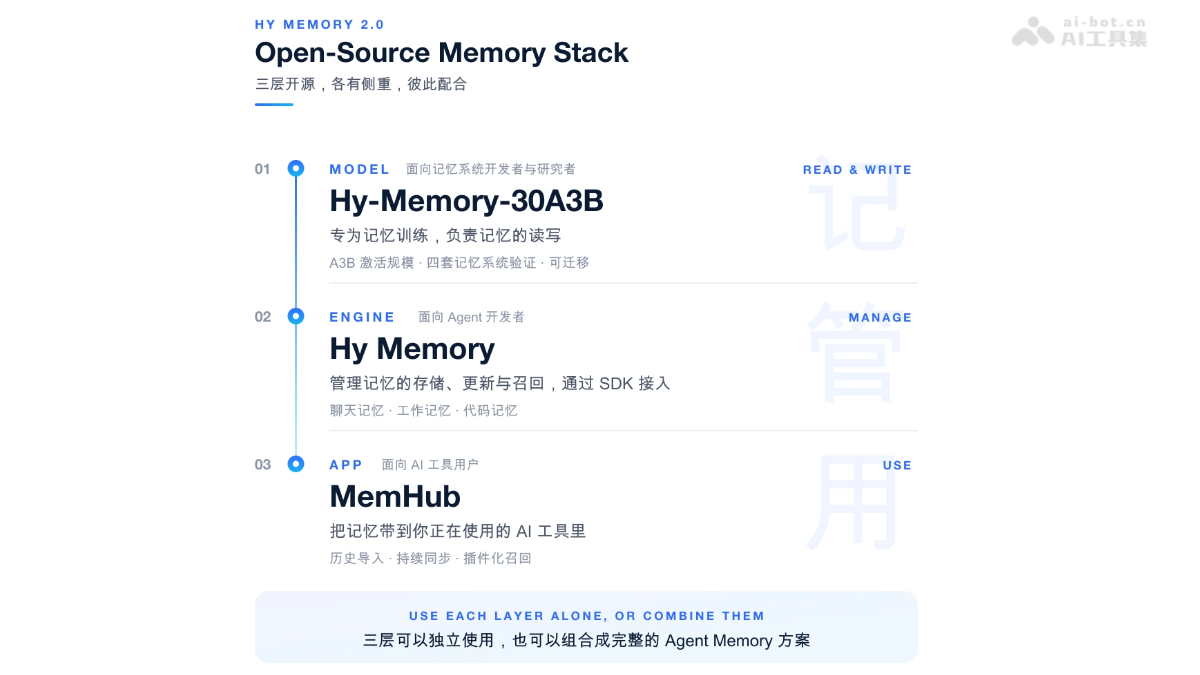
Hy Memory 2.0 – 騰訊混元開源的智能體記憶框架
Hy Memory 2.0是什麼 Hy Memo...
MiDashengLM-Spatial – 小米開源的空間音頻理解大模型
MiDashengLM-Spatial是什麼 M...
GPT-Live-1.1 – OpenAI 推出的 ChatGPT 新一代語音模型
GPT-Live-1.1是什麼 GPT-Live...
Muse Spark Open – Meta 開源的多模態大模型
Muse Spark Open是什麼 Muse ...
用 Claude Opus 5.5 製作視頻,18 類場景案例合集
Opus 5.5 能做什麼視頻?從 4...
Doory – 開源的在線設計編輯器,Canva 開源平替
Doory是什麼 Doory 是開源的在線設計工具,開源的 Canva 替代品,運行在瀏覽器裏的全功能在線設計編輯器,可製作海報、社媒圖、簡歷、PPT、名片等。Doory支持導出 PNG/JPG/SVG/PDF/MP4/GIF,具備實時協同編輯、動畫特效、一鍵摳圖和私有化部署能力,完全免費無廣告,適合小團隊自建使用。 Doory的主要功能 模板設計:內置10個高頻率場景起步模板(海報、簡歷、邀請函等),也支持從空白畫布開始創作。 像素級畫布編輯:基於 Fabric.js 的畫板支持多頁面、多尺寸設計,配備對齊參考線、自動吸附和標尺。 圖層管理:每個元素都是圖層,可重命名、鎖定、隱藏、分組、拖拽排序,右鍵即可調整層級。 文字工具:支持標題、彎曲文字、文字效果、字體搭配,內置開放許可字體庫,也可上傳自有字體。 素材庫:自帶約25000個開放許可圖標、Emoji和插畫,支持上傳圖片、應用蒙版和濾鏡。 一鍵摳圖:背景移除模型直接在瀏覽器本地運行,無需上傳服務器。 動畫製作:提供27種入場/退場動畫、12種強調效果和16種頁面過渡,配時間軸編輯。 多格式導出:支持 PNG(透明)、JPG、SVG、PDF,動畫可導出 MP4/WebM/GIF。 微信關注回覆“開源”,加入AI開源項目交流羣 如何使用Doory 在線體驗: 打開官網:訪問 Doory 官網 https://doory.art/ 進入模板畫廊。 選擇模板:瀏覽或搜索模板,點擊”Use this template”進入編輯器;也可從空白頁開始。 編輯設計:點擊畫布上任意元素即可修改,左側欄可添加文字、形狀、貼紙、圖片、動畫、音頻等,上方工具欄調整字體、顏色、大小等屬性。 保存作品:遊客模式自動將設計保存在瀏覽器本地,點”Sign up”註冊後可將作品一鍵遷移到雲端。 分享協作:點擊右上角 Share 生成鏈接,可設密碼和”僅查看/可評論/可編輯”權限,多人實時協同編輯。 導出成品:點擊下載按鈕,選擇 PNG/JPG/SVG/PDF或 MP4/WebM/GIF導出。 Docker 私有化部署: 獲取代碼:git clone 倉庫到服務器,複製 .env.example 爲 .env。 配置環境變量:在 .env 中設置 DJANGO_SECRET_KEY(用 openssl rand -base64 48 生成)和 POSTGRES_PASSWORD。 啓動服務:運行 docker compose up -d --build,等待容器構建完成。 創建管理員:執行 docker compose exec api python manage.py createsuperuser 設置後台賬號。 填充內容:依次運行 seed_templates、seed_elements、sync_fonts、sync_element_packs、sync_audio 等命令導入模板、圖標、字體和音頻。 訪問使用:瀏覽器打開 http://localhost:8080可開始設計,管理員可登錄後台上傳自定義模板和素材。 Doory的核心優勢 數據自主可控:支持 Docker 一鍵私有化部署,所有設計文件和上傳素材都存儲在自己的服務器上,可對接 S3,徹底避免數據託管在第三方平台的風險。 功能完整度高:圖層、蒙版、濾鏡、彎曲文字、動畫時間軸、音頻、演示模式、版本歷史一應俱全。 實時協同編輯:基於 Yjs 的多人協作,實時光標、評論、權限分級,達到商業產品水準。 本地AI摳圖:背景移除模型直接在瀏覽器本地運行,圖片無需上傳服務器,速度快且保護隱私。 Doory的項目地址 項目官網:https://doory.art/ GitHub倉庫:https://github.com/shaongitbd/doory Doory的同類競品對比 對比維度 Doory Canva 開源 ✅ 開源(Attribution Assurance License) ❌ 閉源商業軟件 私有化部署 ✅ Docker 一鍵部署到自己的服務器 ❌ 僅限官方雲服務 數據控制 文件存儲在自己掌控的基礎設施上 數據託管在 Canva 服務器 免登錄使用 ✅ 遊客直接設計,作品存本地 ❌ 必須註冊賬號 實時協同編輯 ✅ 實時光標、評論、版本歷史 ✅ 支持團隊協作 動畫/視頻導出 ✅ MP4、WebM、GIF ✅ 支持 背景移除 ✅ 模型在瀏覽器本地運行 ✅ 雲端處理(免費版有限額) 模板庫 僅 10 個起步模板(可自行擴充) 百萬級模板庫,生態成熟 素材規模 約 25000 個圖標/Emoji 海量照片、視頻、字體
DMAD – 字節聯合德州農工開源的擴散模型少步蒸餾技術
DMAD是什麼 DMAD(Distribution Matching as Adversarial Distillation)是字節跳動與德州農工大學聯合開源的少步蒸餾框架,用於加速擴散模型生成。DMAD訓練二分類判別器直接學習目標分佈與學生分佈的差異,省去輔助擴散模型,將50步教師模型蒸餾爲4步學生模型。已支持ImageNet、SDXL、Wan2.1及MiniMax-H3-33B,8GB顯存可生成約5秒1344×768有聲視頻。 DMAD的主要功能 少步圖像生成:將 ImageNet-64 的 EDM 模型蒸餾至 1 步採樣,FID 低至 1.04,SDXL 僅需 4 步可文生圖。 少步文生視頻:把 Wan2.1-T2V-14B 蒸餾爲 4 步學生模型,VBench 達 85.15。 聯合音視頻生成:將 MiniMax-H3-33B 的 50 步教師模型蒸餾爲 4 步,輸出 1344×768 視頻與 32kHz 原生立體聲音頻。 消費級硬件支持:提供 8GB 顯存 ComfyUI 工作流與低顯存命令行推理,8GB 顯卡可生成約 5 秒、12GB 約 15 秒有聲視頻。 訓練與推理全開源:發佈蒸餾方法、訓練代碼、推理腳本及多模型 LoRA 權重,覆蓋命令行與 ComfyUI 兩種使用方式。 DMAD的技術原理 分佈匹配即對抗蒸餾:DMAD 爲訓練二分類判別器區分目標樣本與學生樣本,最優判別器的 logit 等於兩分佈的對數密度比,對其輸入求梯度即得 score 差,直接給出學生的修正方向,省掉輔助 score 擬合模型。 共享骨幹、雙頭判別器:判別器採用單一共享特徵骨幹、兩個判別頭,教師頭區分教師樣本與學生樣本,真實數據頭區分真實樣本與學生樣本,均用二元交叉熵訓練;學生用兩個 logit 的加權線性損失更新,更新時凍結判別器參數但保留梯度回傳。 噪聲區間動態加權:教師樣本與真實數據的分佈差異隨噪聲水平變化,DMAD 用真實數據頭在兩類樣本上的平均 logit 差作爲經驗信號,以 0.99 衰減的指數移動平均追蹤各噪聲區間,差距小的區間獲得更高教師權重,歸一化後參與學生損失。 離線教師樣本加速訓練:教師只提供預生成並緩存的樣本,訓練時無需在線調用教師。4 卡 H200、MiniMax-H3 rank-128 LoRA 配置下,每次學生更新及關聯判別器更新耗時從 818.1 秒降至 233.3 秒,實現約 3.51 倍訓練加速。 微信關注回覆“開源”,加入AI開源項目交流羣 如何使用DMAD 克隆倉庫:git clone https://github.com/Yzmblog/DMAD.git 並進入項目目錄。 創建環境:用 conda 創建 Python 3.12 環境並激活。 安裝依賴:按官方固定版本安裝 PyTorch 2.11.0(cu126)、torchvision、torchaudio,再執行 pip install -r requirements.txt 和 pip install -U modelscope-hub。 準備硬件:確保有支持 CUDA 的 NVIDIA 顯卡,並預留約 64GB 系統內存與 170GB 磁盤空間。 下載基礎模型:通過 modelscope download MiniMax/MiniMax-H3 下載 MiniMax-H3 基礎模型。 下載蒸餾權重:從魔搭下載 DMAD 的 4 步 LoRA。 命令行推理:運行 inference.py,指定模型路徑、LoRA、提示詞文件、--steps 4、--height 768 --width 1344,按顯存選擇 --low-vram 8或 --low-vram 12。 查看輸出:輸出目錄包含 0000.mp4、提示詞 txt 和 settings.json,跑通後可替換爲自己的提示詞文件。 DMAD的核心優勢 推理大幅提速:將 50 步教師模型蒸餾爲 4 步學生模型,去噪迭代減少 92% 以上,同時保持接近教師的生成質量。 訓練效率更高:判別器直接學習分佈差異,省去輔助擴散模型,4 卡 H200 上訓練更新加速約 3.51 倍。 生成質量領先:ImageNet-64 一步生成 FID 達 1.04,優於 DMD2、SiDA 等方法;人類評估中對 DMD2 總體偏好率 79.1%、對 rCM 達 84.6%。 覆蓋多模態全場景:同一框架統一支持圖像、文生視頻和聯合音視頻生成。 DMAD的項目地址 項目官網:https://yzmblog.github.io/projects/DMAD/ GitHub倉庫:https://github.com/Yzmblog/DMAD Huggin
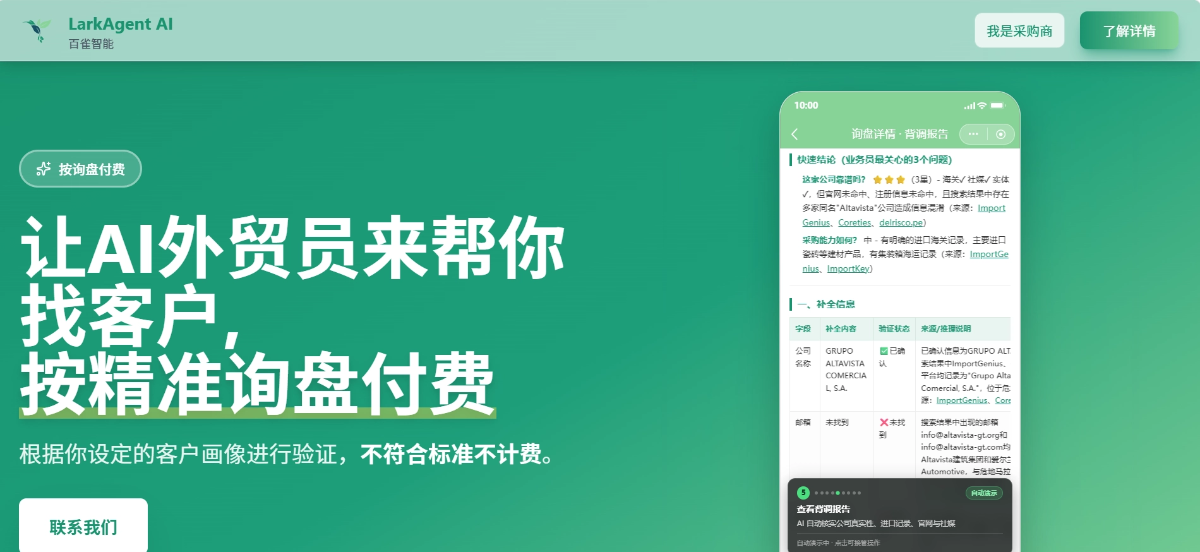
百雀智能獲客教程 – 覆蓋從定製標準到銷售接手
做外貿獲客,耗時最長的往往不是找聯繫方式,而是要逐個確認:對方是否採購你的產品、採購量夠不夠、是不是目標買家、願不願意繼續談。 百雀智能把這些前期工作交給了AI外貿員:先按企業要求圈定客羣,再製作營銷內容、投放廣告和郵件,把感興趣的買家引導到WhatsApp,由AI接待、挖掘需求並完成驗證。符合約定標準後,詢盤才交給企業的銷售經理。 企業拿到的不是一份等着自己逐個開發的名單,而是已經有過溝通、帶着採購需求和驗證信息的詢盤。 那麼,企業具體要做什麼?AI會完成哪些工作?收到詢盤後又該怎麼看?下面按照百雀官網展示的工作流程,以官網中的地板、牆板業務場景爲例,一步步說明。文中的場景用於解釋產品流程,不作爲實際成交案例。 01. 先明確:要交付什麼樣的詢盤 訪問百雀智能中文官網:https://www.larkagent.cn/zh.html 面向出口企業尋找海外採購商的頁面是以“讓AI外貿員來幫你找客戶,按精準詢盤付費”爲核心介紹;頁面中的“我是採購商”入口服務於尋找供應商的買家。 需要開通服務時,通過頁面的“聯繫我們”或“查詢報價”入口,與銷售經理溝通。官網列出的購買方式包括:由銷售經理根據行業、產品和目標市場測算詢盤價格及數量。 開始前,建議準備好產品手冊、企業業務介紹,以及目標市場和客戶類型。資料不是讓你重新做一遍搜客,而是幫AI外貿員明確產品知識和判斷標準。 第一步的重點:先確定什麼樣的買家纔算符合要求,而不是先買一批聯繫方式再慢慢篩。 官網的詢盤計費口徑是:通過約定標準驗證的詢盤才計費,不符合標準不計費。具體價格、數量、服務配置及異議處理方式,在開通前確認,以合同爲準。 02. 定製客戶標準:誰值得聯繫、聊到哪一步交付 這是企業需要重點參與的一步。百雀的客戶標準遠不止國家、行業,還可以細化到產品範圍、業務關聯、採購門檻、貿易條款、買家角色和價格接受度。 下面沿用官網的建材場景,看看這些條件如何落到業務上。 先說明產品和業務範圍 比如你提供地板和牆板,想開發對PVC地板、層壓地板或相關品類有需求的買家。除了產品名稱,還要說明兩點:是否必須確認到具體型號,以及採購商現有業務需要滿足什麼條件。 官網示例中:採購商當前可以不銷售完全相同的產品,但必須與建材、家居行業相關,具備延展產品線的可能,與只按產品關鍵詞篩公司完全不同。 再確定市場、客戶類型和採購門檻 把重點國家或地區、需要排除的市場、希望合作的買家類型說清楚。官網支持按國家、地區定向,也可逐個國家排除;買家類型可約定爲終端採購商、經銷商、貿易商、批發商或中間商等。 採購門檻也要明確:是某個型號的最低起訂量(MOQ),還是單次混批採購金額(MOA)?兩者不能混用。官網說明,未達到約定門檻的買家不交付、不計費。 官網建材示例選擇的是南美、東南亞、中東、中亞市場,並要求買傢俱備進口經驗和當地清關能力。注意:這是該示例自己的業務條件,不必照搬。 最後確認需求要聊到多細 這直接影響業務員接手時掌握的信息量。根據官網的定製說明,企業可以提出: 具體產品:是否需要明確到SKU;未選定型號的採購商是否交付。 價格接受度:是否要求AI先溝通單價範圍;如果需要,什麼回應纔算通過。 關鍵聯繫人:是否必須聯繫到採購經理、採購負責人等角色。 真實性依據:是否需要覈實官網、社交媒體或公司實景等信息。 貿易與履約條件:例如可接受的貿易條款,以及買家是否具備當地清關能力。 以價格爲例:官網建材場景的條件是”報出價格範圍後未明確拒絕”,另一份定製說明是”明確接受價格才交付”,兩者嚴格程度不同。企業應結合自身業務選擇合適的條件,與百雀確認後執行,別把某個演示條件當成通用標準。 這一步完成後,形成的就是一套具體要求,分別用於客羣匹配、對話驗證和詢盤交付。 03. AI圈定客羣,製作創意並觸達 標準確認後,進入百雀AI外貿員的執行環節。官網將這部分拆爲三個連續動作。 第一,按標準圈定目標客羣。 AI結合社交媒體公開主頁、企業網站、海關數據、B2B名錄等信息,匹配企業設定的條件,並進行去重與真實性校驗,篩出值得觸達的買家。 第二,針對不同客羣製作內容。 同樣是地板產品,面向不同採購商時,社媒廣告素材和郵件表達內容可以不同。百雀根據客羣畫像批量製作廣告素材與郵件創意,無需企業重新寫開發信。 第三,通過廣告和郵件開展觸達。 官網展示廣告投放與郵件觸達同步執行,將感興趣的採購商引導至WhatsApp,進入主動諮詢和對話環節。 因此,使用百雀並不等於企業先自建投放團隊、買數據、羣發郵件,再讓AI簡單回一句話。按官網展示的分工:投放與前期接待由百雀承擔,企業的重心在前面定標準、備資料,以及後面承接意向客戶。 產品材料還列有AI數據員、設計員、外貿員、運營員、背調員、建站員、成單助
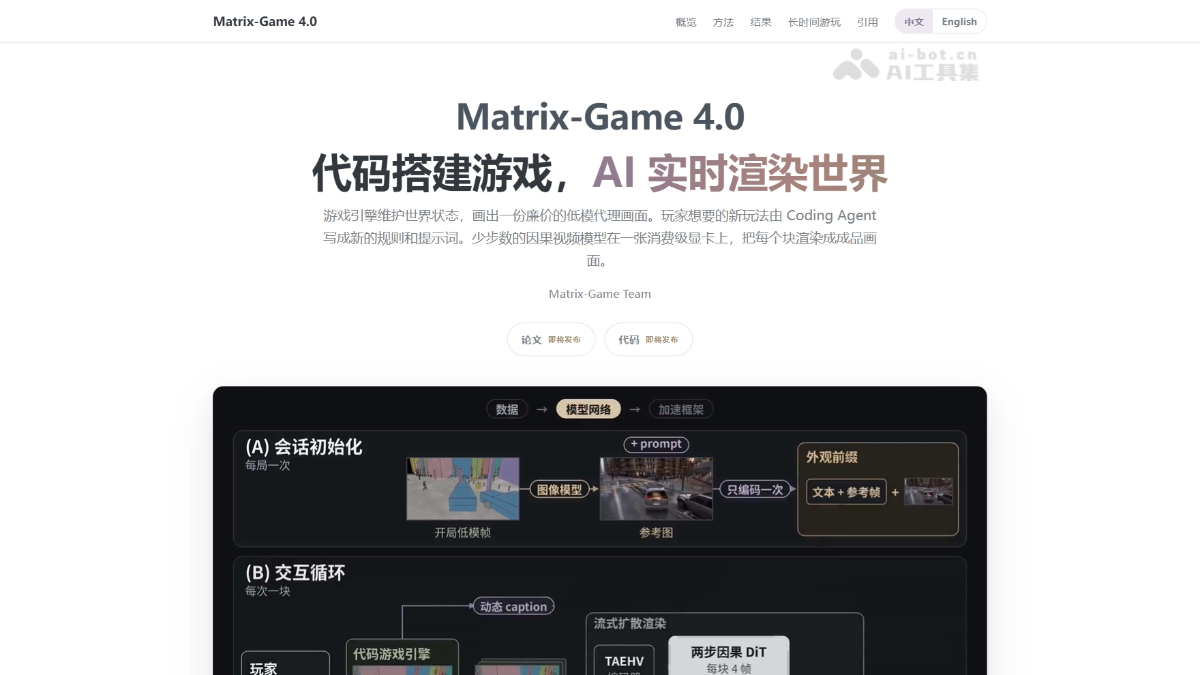
Matrix-Game 4.0 – 崑崙萬維開源顯卡運行的視頻大模型遊戲
Matrix-Game 4.0是什麼 Matrix-Game 4.0是崑崙萬維推出的全球首款運行在單張消費級顯卡上的視頻大模型遊戲,採用”Harness”新範式,遊戲引擎作爲裁判維護世界狀態與規則,Coding Agent 用自然語言改寫玩法,視頻模型作爲畫師實時渲染精細畫面。Matrix-Game 4.0單張 RTX 5090 可實現 480p、60 FPS、延遲低於150毫秒的遊戲體驗,讓小團隊能搭世界成爲現實。 Matrix-Game 4.0的主要功能 單卡實時運行:單張 RTX 5090 即可實現 480p、60 FPS、延遲低於 150 毫秒的可玩遊戲體驗。 自然語言改玩法:通過 Coding Agent 用一句指令調整地形、NPC 行爲或設計全新玩法規則。 世界狀態顯式管理:遊戲引擎以代碼維護血量、揹包、碰撞、勝負等狀態,物體離開視野仍持續演化。 低模轉精細畫面:視頻模型把引擎輸出的幾何結構畫面實時重渲染爲帶光影材質的 3A 級畫面。 長時間一致遊玩:支持 54-99 秒不間斷遊玩,場景、角色身份與交互結果保持穩定不漂移。 Matrix-Game 4.0的技術原理 Harness 架構:系統給視頻模型套上由 Coding Agent 和遊戲引擎組成的Harness,引擎負責規則之內的狀態演化並輸出結構畫面,Coding Agent 把用戶意圖轉成新規則與細化提示詞,視頻模型只專注渲染,三者分工解耦。 結構-精細畫面對齊數據:基於 UE5 構建跨域數據集,用輕量化幾何抽象採集管線將複雜場景抽象爲保留空間拓撲的低模結構表徵,與高模畫面逐幀像素級對齊,同步捕獲實例 ID 與因果事件元數據。 動態 Caption:系統將物體 ID 與語義描述關聯,運行時從引擎讀取當前可見對象及實時狀態填入提示詞模板,與結構畫面配合,共同提供畫什麼、畫在哪的條件約束。 可控 V2V 生成:基於 Wan2.2 5B 改造,結構畫面與待生成視頻以 148 通道拼接輸入 30 層因果 DiT,自注意力讀取空間記憶與歷史 KV 緩存,交叉注意力讀取文本條件,用自迴歸方式逐塊生成。 微信關注回覆“開源”,加入AI開源項目交流羣 如何使用Matrix-Game 4.0 消費級單卡實時:單張 RTX 5090 跑出 480p、60 FPS、112ms 延遲,首次讓視頻模型遊戲走出實驗室的多卡集羣。 世界狀態顯式可管:遊戲引擎以代碼維護世界規則,狀態可讀取、可修改、可驗證,根治了上一代世界只存在模型記憶裏的漂移問題。 一句話改玩法:Coding Agent 將自然語言指令直接轉爲遊戲規則與代碼,創意迭代不再受 3D 資產生產線拖累。 長時間穩定一致:空間記憶 + 參考幀 + 動態 Caption 機制,保障長時段遊玩中場景結構和物體身份不崩壞。 性能斷層領先:延遲約爲 Code World Model 的 1/90、StreamRender-H3 的 1/5,且對端是唯一消費級方案。 Matrix-Game 4.0的核心優勢 消費級單卡實時:單張 RTX 5090 跑出 480p、60 FPS、112ms 延遲,首次讓視頻模型遊戲走出實驗室的多卡集羣。 世界狀態顯式可管:遊戲引擎用代碼維護世界規則,狀態可讀取、可修改、可驗證。 一句話改玩法:Coding Agent 將自然語言指令直接轉爲遊戲規則與代碼,創意迭代不再受 3D 資產生產線拖累。 長時間穩定一致:空間記憶 + 參考幀 + 動態 Caption 機制,保障長時段遊玩中場景結構和物體身份不崩壞。 性能斷層領先:延遲約爲 Code World Model 的 1/90、StreamRender-H3 的 1/5,且對端是唯一消費級方案。 Matrix-Game 4.0的項目地址 項目官網:https://matrix-game-v4-0.github.io/page/ GitHub倉庫:https://github.com/SkyworkAI/Matrix-Game.git HuggingFace模型庫:https://huggingface.co/Skywork/Matrix-Game-4.0 Matrix-Game 4.0的同類競品對比 對比維度 Matrix-Game 4.0 StreamRender-H3 端到端延遲 112ms(實時可玩) 約 545ms 硬件要求 單張 RTX 5090(消費級,32GB) 8× GB200(數據中心級) 分辨率/幀率 480p @ 60 FPS 未達消費級實時標準 世界狀態管理 引擎顯式維護,可讀取/修改/驗證 主要依賴模型內部表示 玩法定製
Grok Voice 3.0 – SpaceXSI 推出的端到端語音轉語音模型
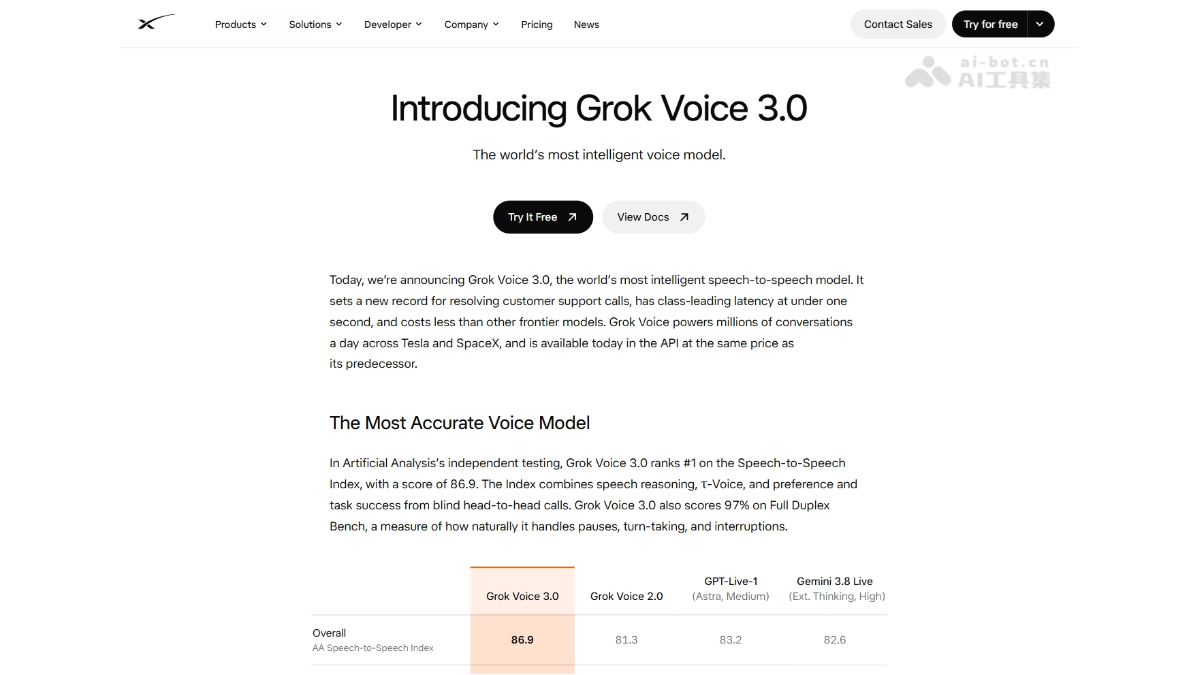
Grok Voice 3.0是什麼 Grok Voice 3.0 是 SpaceXSI 推出的端到端語音轉語音模型,在獨立測試機構 Artificial Analysis 的語音綜合榜單以 86.9 分居首,響應延遲低於 1 秒,單次任務運行成本約 0.025 美元,低於同級別競品。目前每天支撐特斯拉車內數百萬次對話,星鏈客服中心依託模型日處理 2 萬通多語言來電,約七成無需人工介入可解決。 Grok Voice 3.0的主要功能 端到端語音對話:支持語音輸入直接生成語音輸出,無需文字中轉,實現自然流暢的實時人機對話。 全雙工交互:可智能處理停頓、對話輪替和插話,用戶隨時打斷,模型響應自然不僵硬。 複雜任務執行:依託 Connectors 和 Grok Bot,可完成查日程、回郵件、下單咖啡、預訂晚餐等免動手操作。 企業客服能力:單個智能體即可完成客戶身份覈驗、硬件故障排查、發放退款和補發設備全流程服務。 多語言支持:星鏈客服中心每天以多種語言承接約 2 萬通客戶來電。 Grok Voice 3.0的技術原理 端到端語音轉語音架構:傳統語音助手採用”語音識別→文本理解→文本生成→語音合成”的多模塊級聯方案,信息逐級損耗且延遲疊加。Grok Voice 3.0 採用語音到語音的直接建模,音頻信號進入模型後不經文本中間表示,直接輸出語音回覆,減少級聯誤差,是其首響延遲壓至 1 秒以內的結構基礎。 全雙工對話建模:模型能同時處理收聽與生成:通過流式編碼器持續捕捉用戶音頻流,結合對停頓、語氣詞和插話行爲的判別,動態決定何時續說、何時讓步,在 Full Duplex Bench 上取得 97% 的成績,是其車載免喚醒、可打斷交互體驗的核心支撐。 語音推理與智能體能力融合:模型將聽覺理解與大語言模型的推理規劃能力耦合,用戶語音被解析爲任務意圖後,由內置的智能體框架調用日程、郵件、下單等外部工具 Connectors 或 Grok Bot 完成任務,把執行結果用自然語音回饋用戶,形成”聽懂—規劃—執行—回覆”的閉環,是其客服場景能獨立完成退款、補發等操作的原因。 如何使用Grok Voice 3.0 普通用戶:在 Grok 應用、Grok Bot 或特斯拉車內直接開啓語音模式可對話,grok-voice-latest 用戶已自動升級無需操作。 開發者:註冊 API Console 獲取密鑰後,按官方文檔調用 Voice Agent API 接入應用。 Grok Voice 3.0的核心優勢 綜合智能第一:以 86.9 分登頂 Artificial Analysis 語音轉語音綜合榜,在語音推理、任務完成率和人類偏好上全面領先競品。 延遲行業領先:響應延遲低於 1 秒,比同級別 GPT-Live-1 低 40%,實現智能與速度的最優平衡。 運行成本更低:單次任務成本約 0.025 美元,低於 GPT-Live-1 和 GPT-Realtime-2.1,且 API 定價與上代持平不漲。 全雙工交互自然:Full Duplex Bench 拿下 97%,對停頓、輪替和插話的處理接近真人對話體驗。 企業場景驗證充分:EVA-Bench 以 74% 精度居首,星鏈實測日接 2 萬通電話、70% 無需人工、四分之一銷售通話直接成交。 Grok Voice 3.0的項目地址 項目官網:https://x.ai/news/grok-voice-3 Grok Voice 3.0的同類競品對比 對比維度 Grok Voice 3.0 Gemini 3.8 Live AA 語音綜合指數 86.9(第 1 名) 82.6 語音推理(Big Bench Audio) 98.5% 97.7% 人類偏好(Arena Elo) 1070 990 任務完成率 94.8% 89.1% 全雙工(Full Duplex Bench) 97.0% 91.9% τ-Voice 客服場景 71.6% 68.6% 單次任務成本 $0.025 更高(未列具體值) EVA-Bench 企業客服精度 74%(最高) 未領先 Grok Voice 3.0的應用場景 智能車載語音助手(特斯拉):駕駛員全程免動手,通過 Connectors 查詢日程、回覆郵件,或用 Grok Bot 完成下單咖啡、預訂晚餐等複雜任務,目前每天處理數百萬次車內對話。 企業客服中心(星鏈):星鏈客服依託 Grok Voice 每天多語言接聽約 2 萬通來電,約 70% 無需人工介入即可解決,單個智能體可獨立完成身份覈驗、故障排查、退款和設備補發。 電話銷售轉化:約四分之一的銷售通話在客戶掛斷前即促成下
HelixWorld – Noiz AI 聯合港科大開源的實時交互世界模型
HelixWorld是什麼 HelixWorld 是 Noiz AI 與港科大聯合開源的實時交互式音視頻世界模型。給模型一張起始圖片和文字描述,可通過 WASD 和方向鍵在 AI 生成的世界中行走、轉頭,畫面與立體空間音效同步實時生成,且聲像隨視角自然變化。HelixWorld 基於 LTX-2.3 構建,採用”雙向教師 + 因果蒸餾”訓練,單張 H800 顯卡可實現 768×512 分辨率、24 FPS 的實時生成。配套發佈 HelixBench 基準,專門評估空間聲學一致性。 HelixWorld的主要功能 實時可交互世界生成:輸入起始圖片和文字描述,可在 AI 生成的世界中自由探索。 鍵盤/動作操控:WASD 控制移動、方向鍵調整視角,畫面隨操作即時響應。 原生音視頻聯合生成:視頻與立體聲音頻同步生成,非後期配音。 空間聲學一致性:聲像隨鏡頭轉動自然變化,如左側聲源轉身後面向時聲音方向隨之改變。 三軌解耦提示詞:分別用視頻、音頻、音視頻聯合描述控制生成內容。 實時流暢體驗:單張 H800 顯卡上達到 768×512 分辨率、24 FPS 實時生成。 HelixWorld的技術原理 雙向教師模型預訓練:先訓練一個雙向音視頻擴散模型作爲教師:連續 6-DoF 相機軌跡通過 PRoPE 注入視覺注意力,81 類離散動作經 AdaLN-Zero 調製擴散時間步,跨模態注意力把相機運動傳遞到音頻分支,使聲音自然產生立體聲像變化。 因果蒸餾實現實時化:將教師模型蒸餾爲少步因果學生模型:視頻潛變量與音頻 token 分塊處理,塊內雙向注意力、塊間通過 KV cache 因果連接,配合 ODE 初始化使學生能以 4 步完成去噪,滿足實時推理需求。 在線軌跡蒸餾抑制漂移:針對自迴歸長程生成的誤差累積問題,訓練時用教師 Probability Flow ODE 的終點爲目標監督學生速度場,與分佈匹配損失(DMD)隨機交替使用,兼顧生成多樣性與長程穩定性。 長程流式微調:通過滑窗 KV cache 逐段展開長序列訓練,保留 sink 幀錨點、歷史梯度截斷,配合約一分鐘的長序列微調,進一步減少長時間生成中的畫面漂移與聲音退化。 微信關注回覆“開源”,加入AI開源項目交流羣 如何使用HelixWorld 方式一:在線體驗 打開官網 https://helixworld.org,選擇示例圖片或上傳自己的圖片。 填寫場景的文字描述。 進入世界後用 WASD 移動、方向鍵轉動視角,實時探索生成內容。 運行過程中還可隨時修改提示詞,調整後續生成的場景。 方式二:本地部署 環境準備:Linux 系統、Python 3.11、CUDA 12.x、NVIDIA 顯卡(建議 80GB 顯存)、ffmpeg 和 ffprobe。 下載項目並安裝依賴:git clone https://github.com/NoizAI/HelixWorld.git,創建 conda 環境後 pip install -r requirements.txt。 運行 python download_models.py 下載模型權重。 準備一張起始圖片,通過 ./run.sh 指定圖片、畫面/聲音/聯合提示詞、動作序列等參數,生成 MP4 輸出到 outputs 目錄。 HelixWorld的核心優勢 首個開源實時交互式音視頻世界模型:畫面與空間立體聲在用戶操控下聯合實時生成,代碼和權重完全開放。 真正的”轉頭即變聲”:聲像嚴格跟隨視角轉動,空間一致性得分數倍於同類。 單卡即可實時:單張 H800 實現 24 FPS、RTF 0.77 實時生成,速度是同類的 2.5 倍以上。 長程生成不漂移:在線軌跡蒸餾 + 長程微調,30 秒以上連續生成畫面聲音依然穩定,且多樣性不降反升。 音頻質量全面領先:HelixBench 核心指標全面最優,用戶盲測帶音頻場景下以 67.9% 偏好率碾壓對手。 HelixWorld的項目地址 項目官網:https://helixworld.org/ GitHub倉庫:https://github.com/NoizAI/HelixWorld arXiv技術論文:https://arxiv.org/pdf/2609.38123 HelixWorld的應用場景 沉浸式遊戲原型:無需建模和引擎,輸入圖片即可生成可行走探索的開放世界,大幅縮短遊戲 Demo 開發週期。 VR/AR 虛擬空間:第一人稱視角 + 空間音頻的組合天然適配頭顯設備,可快速生成虛擬展廳、數字孿生環境。 影視與廣告預演:導演上傳概念圖即可”走進”場景試聽音畫效果,在實拍前低成本驗證鏡頭語言和氛圍設計。 AI 視頻通話/虛擬主播背景:根據語音
Scion – Anthropic 推出的源代碼版本控制系統,替代 Git
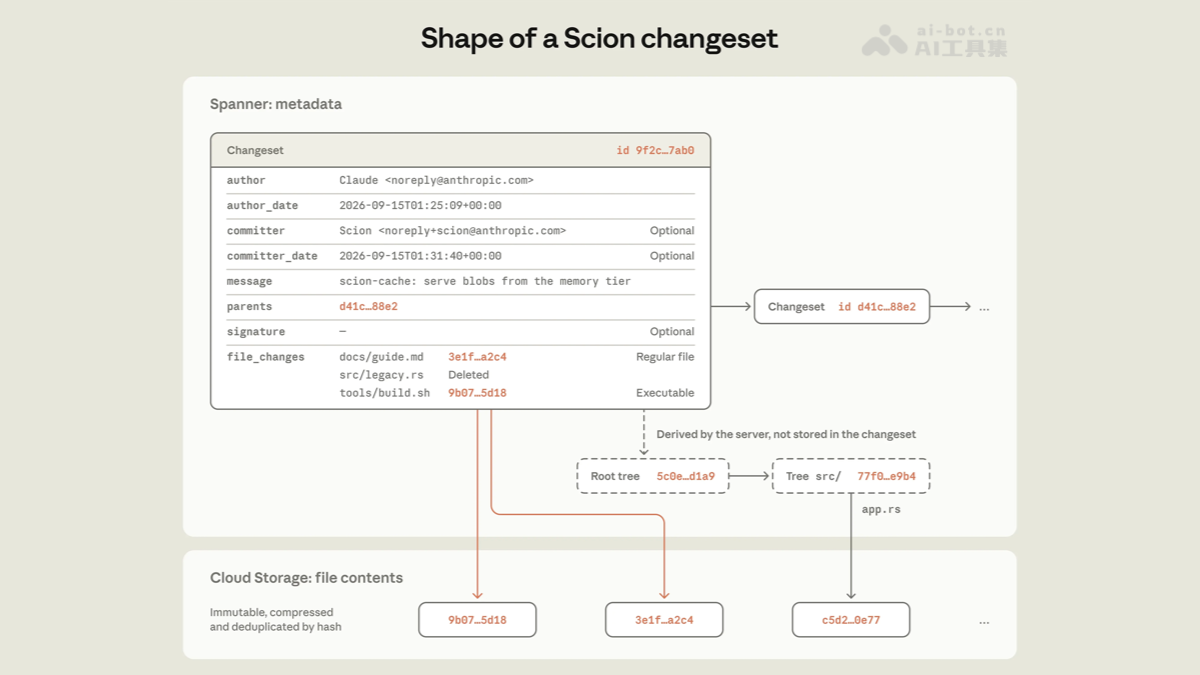
Scion是什麼 Scion是Anthropic自研的版本控制系統,用於替代Git管理其巨型單體倉庫。原因是Claude生成代碼量4個月暴漲12倍,日均合併從2500次到3萬次,Git基礎設施基本無法應對。Scion針對智能體永遠在線重新設計,客戶端按需向服務器取數,提交、合併全在服務端完成,支持全水平擴展與稀疏檢出。遷移後資源佔用降爲Git方案的1/200,檢出提速兩個數量級。 Scion的主要功能 變更集(changeset)替代 commit:用預寫式日誌條目記錄相對父級的文件變更列表,服務器端創建、即時全局可用,無需打包、加鎖或移動引用。 派生數據機制:基於變更集遞歸構建 blame、路徑歷史、提交圖跳錶等索引,可熱插拔新數據類型,支持即時或延遲計算,客戶端無感知。 全 API 化的源碼控制服務:diff、merge base、blame 等查詢全部通過 RPC 暴露,CI 和工具無需維護本地倉庫副本。 分層緩存檢出架構:scion-daemon(節點級)→ scion-cache(區域級)→ scion-server(權威層)逐級緩存,各層命中率超 99%,檢出從幾分鐘縮到幾秒。 稀疏/虛擬化檢出:客戶端只拉取請求目錄的文件,按需實例化,文件內容只在實際讀取時付費。 細粒度權限控制:支持倉庫級和目錄級訪問控制,配合 Antique 評審工具實現語義化的審批約束。 提交低成本、增量、無鎖:創建提交的成本與變更大小而非倉庫大小成正比,引用更新僅爲單條 Spanner 記錄的原子操作。 如何使用Scion Scion 是 Anthropic 內部系統,未公開發布,外部用戶無法下載或部署。 Scion的核心優勢 資源佔用極低:CPU 和內存佔用僅爲原 Git 鏡像基礎設施的 1/200。 檢出速度提升兩個數量級:CI 和研究任務檢出代碼從幾分鐘縮短到幾秒。 顯著節省算力:僅 CI 一項就釋放出 25% 的 CPU 容量。 緩存效率極高:每層緩存命中率超 99%,且無需長期狀態,擴容簡單。 提交吞吐極高:無 packfile、無鎖、無跨服務協同,可高吞吐接收變更集,支撐日均 3 萬次合併。 免本地倉庫:所有源碼控制查詢通過 API 提供,CI 和工具不再需要維護本地副本。 全水平擴展:無倉庫完整實例、無全局狀態瓶頸,每個組件可獨立擴容。 維護成本近零:無 packfile 概念,客戶端和緩存都不需要做倉庫維護。 細粒度安全:支持目錄級權限控制和語義化審批約束,敏感代碼可在大倉庫內得到保護。 Scion的項目地址 項目官網:https://www.anthropic.com/engineering/redesigning-source-control Scion的同類競品對比 對比維度 Scion(Anthropic) Git 設計前提 客戶端永遠在線,幾乎全是 AI 智能體和自動化任務 客戶端面向人類開發者,可離線工作 倉庫副本 客戶端無完整副本,本地僅有界緩存,按需取數 每個克隆都是完整的自包含倉庫 提交方式 服務端創建提交、合併、變基,無需 push,無鎖 本地提交後推送,推送涉及加鎖與協商 工作單元 變更集(changeset),存相對父級的文件變更列表 commit,存指向完整代碼樹的指針 查詢能力 blame、diff、祖先關係等全部經 API 暴露,免本地倉庫 查詢依賴本地倉庫計算或廠商專有 API 擴展方式 全水平擴展,無完整倉庫實例,組件獨立擴容 垂直擴展爲主,巨型倉庫需數百鏡像橫向硬扛 稀疏檢出 協議核心能力:稀疏 + 虛擬化檢出,按實際讀取付費 支持稀疏檢出,但需與淺克隆等能力複雜組合 緩存架構 三層分層緩存(daemon→cache→server),命中率超 99% 無服務端緩存概念,客戶端自行持有對象 倉庫維護 無 packfile 概念,客戶端與緩存均無需維護倉庫 需定期 gc、打包等倉庫維護操作 權限模型 倉庫級 + 目錄級訪問控制,語義化審批約束 無內置目錄級權限,依賴託管平台實現 離線能力 不支持,客戶端必須在線 完整支持,離線可提交、查歷史、切分支 Scion的應用場景 AI 智能體高頻提交代碼:智能體完成編碼任務後直接通過 API 在服務端創建變更集,無需維護本地倉庫,支撐日均數萬次合併。 CI 大規模免檢出運行:CI 作業直接調用 RPC 獲取 diff、blame、merge base,甚至免檢出執行寫入,每天數千萬次檢出不再成爲瓶頸。 大型單體倉庫的多團隊協作:數萬工程師共享同一倉庫時,稀疏檢出讓每個人只拉取自己負責的目錄,目錄級權限保護
Surface Laptop Ultra – 微軟聯合英偉達推出的最強 AI PC
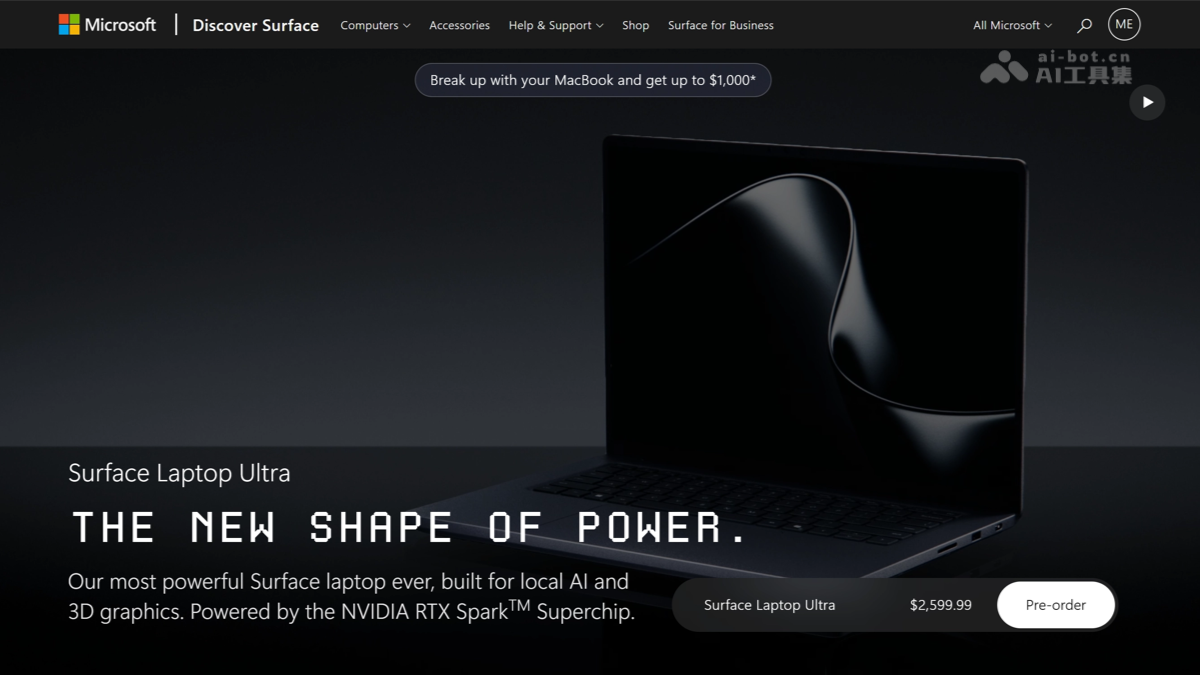
Surface Laptop Ultra是什麼 Surface Laptop Ultra是微軟推出最強Surface PC,搭載英偉達RTX Spark N1X超級芯片,最高20核CPU+6144核GPU+128GB統一內存,本地AI算力達1PFLOPS,可運行超1200億參數大模型。Surface Laptop Ultra採用15英寸PixelSense Ultra觸控屏、磁吸式USB-C充電,續航一整天,專爲AI開發、創意工作與智能體場景打造。 Surface Laptop Ultra的主要功能 本地跑大模型:1PFLOPS算力+128GB統一內存,本地運行超1200億參數模型。 AI編程:本地跑MAI-Code-1.1-Flash,Copilot智能編排本地與雲端任務。 智能體運行:配合MXC沙箱安全運行OpenClaw、Codex等智能體。 視頻創作:支持電影級視頻編輯,AI視頻生成比M5 Pro快6.2倍。 遊戲:光線追蹤+DLSS,《戰爭機器》穩定60幀。 屏幕:15英寸觸控屏,HDR亮度比MacBook Pro M5高25%。 磁吸充電:全球首款內置磁吸式USB-C接口。 擴展性:3個USB-C+HDMI等接口,可驅動3台4K顯示器,存儲可拆卸升級。 續航散熱:散熱提升2.5倍,續航滿足一整天。 Surface Laptop Ultra的規格參數 芯片:英偉達RTX Spark N1X超級芯片,Grace CPU + Blackwell RTX GPU,互聯速度600GB/s CPU:最高20核,入門版爲18核 GPU:最高6144核,入門版爲5120核 AI算力:1 PFLOPS FP4,可本地運行超1200億參數模型 內存:24GB家庭版或32GB~128GB專業版LPDDR5x統一內存 存儲:512GB~1TB固態硬盤,支持用戶自行拆卸、升級和更換 屏幕:15英寸PixelSense Ultra觸控屏,HDR峯值亮度比MacBook Pro M5高25% 機身:厚度不足18mm,重量不足4.5磅 散熱:全新散熱架構,散熱能力爲現有Surface筆記本的2.5倍 電池:續航滿足一整天使用 接口:3個USB-C,含全球首款內置磁吸式充電接口Magnetic Connect),、HDMI、USB-A、SD卡讀卡器、3.5mm耳機插孔,可驅動最多3台4K顯示器 操控:觸控板面積增大30%,配備先進觸覺反饋技術 系統:Windows 11家庭版/專業版 遊戲技術:英偉達光線追蹤、DLSS、Reflex Surface Laptop Ultra的價格配置 入門版2599美元,約17425元,18核CPU+5120核GPU+24GB+512GB 頂配5899.99美元,約39557元,20核CPU+6144核GPU+128GB+1TB Surface Laptop Ultra的購買地址 官方購買地址:https://www.microsoft.com/en-us/store/configure/surface-laptop-ultra/8wg5vqp0x4b8 Surface Laptop Ultra的應用場景 本地AI開發:依託1PFLOPS算力和128GB統一內存,開發者可在本地運行1200億參數大模型及MAI-Code-1.1-Flash,無需聯網即可完成代碼生成與調試。 企業智能體辦公:通過MXC安全沙箱隔離運行OpenClaw、Codex等智能體,自動完成文件整理、郵件歸檔等流程性工作。 影視內容創作:藉助AI圖像生成4.3倍、視頻生成6.2倍於M5 Pro的速度,創作者可本地完成電影級剪輯與AI素材生成。 隱私敏感計算:醫療、法律、金融行業的機密數據全程在本地處理,無需上傳雲端即可滿足合規要求。
LFM2.5-24B-A2B – Liquid AI 開源的端側推理模型
LFM2.5-24B-A2B是什麼 LFM2.5-24B-A2B 是 Liquid AI 推出的開源權重推理模型,屬 LFM2.5 系列旗艦。總參數 24B、每 token 僅激活 2.45B,40 層 MoE 架構,支持 131K 上下文與 16 種語言。LFM2.5-24B-A2B回答前必先生成思維鏈,專爲端側 Agent 優化,LiveClaw 得分 48.09 反超參數量大 50% 的 Qwen3.6-35B-A3B,在 M5 Max 上解碼達 184 tok/s,比同類 MoE 最快 1.7 倍。適合本地私有化部署的推理與工具調用場景,知識密集任務建議搭配檢索使用。 LFM2.5-24B-A2B的主要功能 端側 Agent 推理:專爲在個人設備上本地運行的快速、私密智能體而設計。 純推理模式:回答前自動生成顯式思維鏈,用低激活成本換取答案質量。 函數調用:原生支持四步工具調用流程,可直接接入 OpenClaw、Hermes Agent、Pi、OpenCode 等框架。 多格式部署:提供原生、FP8、GGUF、ONNX、MLX-4bit 等版本,覆蓋 GPU、CPU、Apple Silicon 及邊緣設備。 長上下文處理:支持 131,072 tokens 上下文,可處理長文檔與多輪智能體軌跡。 多語言能力:覆蓋英、中、日、韓、阿拉伯等 16 種語言,128K 詞表優化非拉丁語系分詞。 快速推理:Apple M5 Max 上 184 tok/s,比同類 MoE 最高快 1.7 倍,單卡 B300 超 21K tok/s。 LFM2.5-24B-A2B的技術原理 MoE 稀疏激活架構:模型共 24B 參數,但每個 MoE 塊包含 64 個專家,推理時僅通過 top-4 路由激活其中 4 個,使每 token 實際計算量僅 2.45B 參數。這是”大容量、低算耗”的核心,模型存儲全部知識,但每次前向只動用一小部分,從而實現遠小於同總參數量模型的推理成本。 混合層設計:卷積 + GQA 40 層網絡由 30 個”雙門控短卷積塊”與 10 層 GQA混合構成。短卷積負責高效提取局部序列特徵,注意力層負責長程依賴建模,兩者交替使模型在保持線性層高效計算的同時仍具備長上下文能力,這也是 LFM 架構在邊緣設備上速度快、內存省的結構基礎。 詞表原地擴展與長上下文訓練:在保留上一代 LFM2-24B-A2B 主體架構的前提下,通過原地 tokenizer 擴展將詞表從 65K 翻倍至 128K,顯著改善中文、日文等非拉丁語言的 token 效率;上下文窗口從 32K 擴展至 131K,配合 300B tokens 的長上下文專項中期訓練,使模型獲得穩定的長序列處理能力。 三階段訓練流程:預訓練消耗約 33T tokens;中期訓練先在 32K 上下文用 2T tokens 高質量數據強化推理、數學、代碼與指令遵循能力,在 131K 上下文用 300B tokens 專攻長文本,且兩個階段均注入工具調用與多輪交互數據;後訓練採用 SFT→教師專業化→非 Agent 與 Agent 兩輪多域同策略蒸餾→在 OpenClaw、Hermes 等真實智能體框架內做強化學習的五階段流水線,使模型真正學會在真實工具環境中”思考-調用-驗證”。 微信關注回覆“開源”,加入AI開源項目交流羣 如何使用LFM2.5-24B-A2B 獲取模型:從 Hugging Face 下載 LiquidAI/LFM2.5-24B-A2B,按硬件選擇原生 BF16、FP8、GGUF、ONNX 或 MLX-4bit 版本。 安裝環境:確保 Python 環境裝有 transformers>=5.0.0,或部署 vLLM、SGLang、llama.cpp、LM Studio 等推理框架。 加載模型:用 AutoModelForCausalLM.from_pretrained() 以 bfloat16 精度加載模型。 構造提示:用 tokenizer.apply_chat_template() 自動套用 ChatML 格式模板格式化對話。 參數設置:生成時採用官方推薦參數 temperature=0.1、top_k=50、repetition_penalty=1.05,思維鏈任務可將 max_new_tokens 設爲 4096 以上。 配置工具調用:將工具列表以 JSON 形式寫入 system prompt,模型會用 <|tool_call_start|> 標記輸出函數調用,執行後以 tool 角色返回結果。 接入 Agent 框架:通過 OpenAI 兼容接口在本地啓動服務,再接入 OpenClaw、H