最好用的AI工具
搜尋:Qwen3
17 個結果
LFM2.5-24B-A2B – Liquid AI 開源的端側推理模型
LFM2.5-24B-A2B是什麼 LFM2.5-24B-A2B 是 Liquid AI 推出的開源權重推理模型,屬 LFM2.5 系列旗艦。總參數 24B、每 token 僅激活 2.45B,40 層 MoE 架構,支持 131K 上下文與 16 種語言。LFM2.5-24B-A2B回答前必先生成思維鏈,專爲端側 Agent 優化,LiveClaw 得分 48.09 反超參數量大 50% 的 Qwen3.6-35B-A3B,在 M5 Max 上解碼達 184 tok/s,比同類 MoE 最快 1.7 倍。適合本地私有化部署的推理與工具調用場景,知識密集任務建議搭配檢索使用。 LFM2.5-24B-A2B的主要功能 端側 Agent 推理:專爲在個人設備上本地運行的快速、私密智能體而設計。 純推理模式:回答前自動生成顯式思維鏈,用低激活成本換取答案質量。 函數調用:原生支持四步工具調用流程,可直接接入 OpenClaw、Hermes Agent、Pi、OpenCode 等框架。 多格式部署:提供原生、FP8、GGUF、ONNX、MLX-4bit 等版本,覆蓋 GPU、CPU、Apple Silicon 及邊緣設備。 長上下文處理:支持 131,072 tokens 上下文,可處理長文檔與多輪智能體軌跡。 多語言能力:覆蓋英、中、日、韓、阿拉伯等 16 種語言,128K 詞表優化非拉丁語系分詞。 快速推理:Apple M5 Max 上 184 tok/s,比同類 MoE 最高快 1.7 倍,單卡 B300 超 21K tok/s。 LFM2.5-24B-A2B的技術原理 MoE 稀疏激活架構:模型共 24B 參數,但每個 MoE 塊包含 64 個專家,推理時僅通過 top-4 路由激活其中 4 個,使每 token 實際計算量僅 2.45B 參數。這是”大容量、低算耗”的核心,模型存儲全部知識,但每次前向只動用一小部分,從而實現遠小於同總參數量模型的推理成本。 混合層設計:卷積 + GQA 40 層網絡由 30 個”雙門控短卷積塊”與 10 層 GQA混合構成。短卷積負責高效提取局部序列特徵,注意力層負責長程依賴建模,兩者交替使模型在保持線性層高效計算的同時仍具備長上下文能力,這也是 LFM 架構在邊緣設備上速度快、內存省的結構基礎。 詞表原地擴展與長上下文訓練:在保留上一代 LFM2-24B-A2B 主體架構的前提下,通過原地 tokenizer 擴展將詞表從 65K 翻倍至 128K,顯著改善中文、日文等非拉丁語言的 token 效率;上下文窗口從 32K 擴展至 131K,配合 300B tokens 的長上下文專項中期訓練,使模型獲得穩定的長序列處理能力。 三階段訓練流程:預訓練消耗約 33T tokens;中期訓練先在 32K 上下文用 2T tokens 高質量數據強化推理、數學、代碼與指令遵循能力,在 131K 上下文用 300B tokens 專攻長文本,且兩個階段均注入工具調用與多輪交互數據;後訓練採用 SFT→教師專業化→非 Agent 與 Agent 兩輪多域同策略蒸餾→在 OpenClaw、Hermes 等真實智能體框架內做強化學習的五階段流水線,使模型真正學會在真實工具環境中”思考-調用-驗證”。 微信關注回覆“開源”,加入AI開源項目交流羣 如何使用LFM2.5-24B-A2B 獲取模型:從 Hugging Face 下載 LiquidAI/LFM2.5-24B-A2B,按硬件選擇原生 BF16、FP8、GGUF、ONNX 或 MLX-4bit 版本。 安裝環境:確保 Python 環境裝有 transformers>=5.0.0,或部署 vLLM、SGLang、llama.cpp、LM Studio 等推理框架。 加載模型:用 AutoModelForCausalLM.from_pretrained() 以 bfloat16 精度加載模型。 構造提示:用 tokenizer.apply_chat_template() 自動套用 ChatML 格式模板格式化對話。 參數設置:生成時採用官方推薦參數 temperature=0.1、top_k=50、repetition_penalty=1.05,思維鏈任務可將 max_new_tokens 設爲 4096 以上。 配置工具調用:將工具列表以 JSON 形式寫入 system prompt,模型會用 <|tool_call_start|> 標記輸出函數調用,執行後以 tool 角色返回結果。 接入 Agent 框架:通過 OpenAI 兼容接口在本地啓動服務,再接入 OpenClaw、H
MiniCPM-V 4.7 – 面壁智能等開源的端側多模態大模型
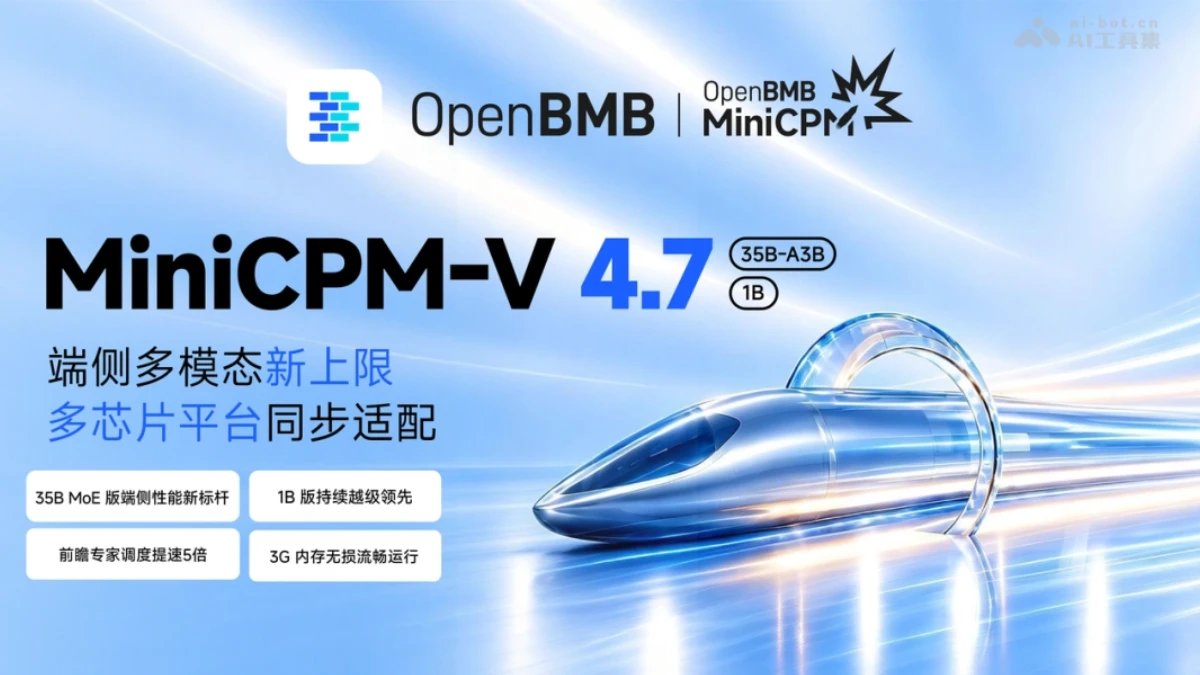
MiniCPM-V 4.7是什麼 MiniCPM-V 4.7 是面壁智能聯合 OpenBMB 開源的端側多模態大模型,含 35B-A3B(MoE)與 1B 兩個版本。旗艦版爲全球首個可在手機端無損流暢運行的開源 MoE 多模態模型,藉助前瞻專家調度技術,約 3GB 內存可在 iPhone 上達 13+ tokens/s,34 項基準全面領先同檔模型;1B 版面向入門級設備。 MiniCPM-V 4.7的主要功能 通用視覺理解:看圖識物、多圖對比、視覺問答,MMBench 91.72 分領先同檔模型。 文檔與 OCR 解析:識別圖片/PDF 中的文字、表格與圖表,OCRBench 91.2 分。 數學與 STEM 推理:解答數學題、科學問題,MMMU 80.22、MathVista 88 分。 長視頻理解:理解長時序視頻內容並回答相關問題,LongVideoBench 68.9 分。 端側流暢運行:35B 模型在 iPhone 上僅佔約 3GB 內存、13+ tokens/s 實時生成。 低成本定製微調:開源自回放微調,學新任務不忘舊能力。 MiniCPM-V 4.7的技術原理 前瞻專家調度(LES):MoE 模型 65.6 GiB 的權重無法全量入內存,大部分專家存於 SSD、用時讀取,但逐層路由依賴上一層結果,導致每層都要停等讀盤。LES 用相鄰層輸入高度相似的特點,用當前層路由特徵提前預測下一層所需專家並後台預取,同時讓已加載且被真實路由選中的專家優先計算,實現邊算邊讀,實測提速 5 倍且輸出零損失。 權重存取優化:通過逐層混合精度量化減少權重的存儲體積與傳輸量;同時重組專家權重在文件中的佈局,將原本分散三處的參數改爲按編號連續存放,使 SSD 一次順序讀取即可取出完整專家,大幅降低加載開銷。 視覺 token 壓縮:基於 LLaVA-UHD v4 在視覺編碼器內部提前壓縮 token,從源頭減少後續計算;支持 4 倍/16 倍兩檔壓縮率切換,16 倍模式下關鍵指標幾乎無損,兼顧畫質細節與實時交互。 DSpark 投機解碼:由輕量草稿模塊一次生成多個候選 token,主模型並行驗證後批量產出,多個 token 分攤 MoE 的專家讀取與調度等固定成本,實測生成速度平均提升 1.17 倍且質量不受影響。 微信關注回覆“開源”,加入AI開源項目交流羣 如何使用MiniCPM-V 4.7 獲取模型:從 GitHub、Hugging Face下載模型權重與代碼。 本地快速體驗:訪問 Hugging Face Spaces 上的官方 Web Demo(MiniCPM-V-4.7-Demo)可免安裝在線試玩。 安裝 App:前往 GitHub 的 MiniCPM-V-Apps 倉庫下載 iOS/Android 客戶端,在手機或平板上直接安裝使用。 選擇推理框架部署:根據硬件平台選用 llama.cpp、Ollama、MLX 或 vLLM/SGLang 之一加載模型,完成本地推理服務部署。 啓用 LES 加速(可選):端側運行 35B-A3B 時,按開源文檔開啓前瞻專家調度,實現 3GB 內存流暢運行。 選擇視覺壓縮模式:根據需求切換 4 倍壓縮或 16 倍壓縮模式。 MiniCPM-V 4.7的項目地址 GitHub倉庫:https://github.com/OpenBMB/MiniCPM-V HuggingFace模型庫:https://huggingface.co/collections/openbmb/minicpm-v-47 MiniCPM-V 4.7的核心優勢 端側 MoE 全球首創:全球首個可在端側無損、流暢運行的開源 MoE 多模態大模型。 極致內存效率:65.6 GiB 權重的 35B 模型僅需約 3GB 內存即可運行,爲 16GB 設備內存的 1/4。 推理速度領先:iPhone 17 Pro Max 實測 13+ tokens/s,iPad Pro M4 達 17+ tokens/s,LES 技術提速 5 倍。 性能全面碾壓同檔:34 項權威基準全面領先 Qwen3.6-35B-A3B,甚至超越體量更大的 Qwen 27B、Gemma-4 31B。 性能與效率帕累托最優:更短推理時間取得更高綜合得分,刷新端側多模態”性能—效率”前沿。 雙版本普惠覆蓋:35B 旗艦拉能力上限,1B 小鋼炮讓入門級設備也能跑高質量多模態。 MiniCPM-V 4.7的同類競品對比 對比維度 MiniCPM-V 4.7 35B-A3B Qwen3.6-35B-A3B 推理速度 iPhone 17 Pro Max 13+ tokens/s,LES 提速 5 倍 較慢(同檔中處於
QwenGyre – 阿里千問推出的在線強化學習框架
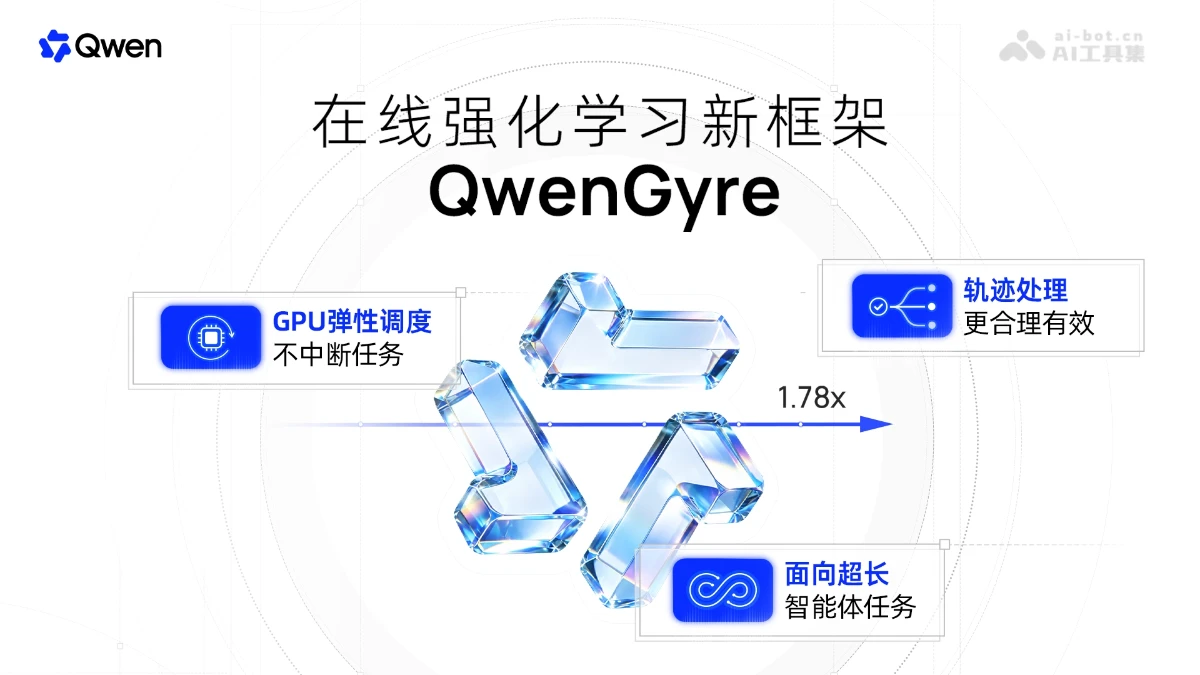
QwenGyre是什麼 QwenGyre 是阿里千問推出的超長程智能體在線強化學習框架,面向單次約 70 萬 token、持續數小時的任務。QwenGyre用彈性調度在任務不中斷時把空閒 GPU 在採樣與訓練間切換,用軌跡處理保留真實上下文、評估部分成果、去重共享前綴以控制成本。在 Qwen3.8-2.4T 上 48 步把 NL2RepoBench 通過率從 52.48% 提至 58.54%,較 Async 端到端加速 1.78×。 QwenGyre的主要功能 超長程智能體在線強化學習:在單次執行長達數小時、累計約百萬 token 的任務上直接做 RL 訓練。 彈性 GPU 調度:任務不中斷的情況下,動態把空閒 GPU 在採樣與訓練間切換。 請求重路由與 KV cache 遷移:切換 GPU 角色時智能體繼續運行,工作區和工具狀態保留,通過 RDMA 遷移 KV cache 減少重複計算。 流式訓練與新節點中途加入:核心 cell 保存權威參數,衛星 cell 可隨時拉取快照加入正在進行的批次,按進度領取微批次。 軌跡樹與真實上下文保留:用 Token-in Token-out 記錄每次調用的精確輸入輸出,按共享前綴組織成軌跡樹,輸出始終對應生成時的上下文。 部分評分(Partial Scoring):超時未完成的任務若產出可檢驗成果,仍按任務規則評分並用於訓練。 軌跡預算與損失均衡:每個執行最多保留 Jmax 條軌跡,共享前綴只計一次損失,避免分支多的任務權重過大。 QwenGyre的技術原理 彈性調度(Elastic Scheduler):將 GPU 劃分爲若干同構計算單元,每個 cell 能用 SGLang 提供採樣服務,也能用 Megatron 承載完整訓練副本。調度器跟蹤”水位”,未完成任務量,只要剩餘採樣容量足以支撐在跑任務且訓練數據供應充足,就按序把 cell 逐個切入訓練;切換時由代理把模型請求重定向到新推理引擎並重試未完成請求,後端進程和通信組無需重建。核心 cell 持有權威權重與優化器狀態,衛星 cell 通過 RDMA 拉取參數快照後加入當前批次的梯度累計,最後由核心統一彙總更新,實現訓練隨數據就緒逐步擴容、採樣與訓練高度重疊。 軌跡處理(Trajectory Processor):QwenGyre 通過代理記錄每次模型調用的精確輸入/輸出 token ID 和行爲策略對數概率,把共享前綴複用、分叉處建分支,組織成軌跡樹,保證每條輸出始終對應其生成時的原始上下文。訓練准入階段按角色優先級爲每個執行選取不超過 Jmax 條軌跡,僅策略模型生成的 token 參與損失、共享目標只計一次;損失先在執行內對選中 token 取平均、再對執行取平均,使執行權重與其分支數量解耦。配合 Partial Scoring 對超時任務的已完成部分評估打分,最大化利用超長程執行中稀疏而昂貴的有效信號。 如何使用QwenGyre 目前 QwenGyre 用論文形式發佈,阿里尚未公開代碼與安裝包。 QwenGyre的核心優勢 首次實現旗艦模型超長程在線 RL:在 Qwen3.8-2.4T 上完成單次約 70 萬 token 任務的在線強化學習,48 步將 NL2RepoBench 通過率從 52.48% 提升至 58.54%。 訓練效率大幅提升:相同 GPU 預算下端到端加速最高達 1.78×(對 Async)、1.85×(對 Colocate),48 步訓練耗時從 134.55 小時縮短至 75.42 小時。 任務零中斷的彈性調度:GPU 在採樣與訓練間動態切換時,智能體執行、工作區和工具狀態完全保留,切換耗時僅數秒,相對數小時的執行可忽略。 GPU 利用率最大化:細粒度 cell 級資源分配消除了 Colocate 模式的長尾等待空轉和 Async 模式的固定分區僵化,訓練可被採樣完全隱藏。 真實上下文保真訓練:TITO 機制保證每條輸出都對應其生成時的原始上下文,避免歷史壓縮、子智能體上下文拼接導致的”虛假上下文”訓練信號。 QwenGyre的項目地址 arXiv技術論文:https://arxiv.org/pdf/2609.33848 QwenGyre的應用場景 自然語言生成完整代碼倉庫:根據自然語言規格從零構建多包軟件倉庫,單次執行約 70 萬 token、長達數小時。 已有倉庫的長程軟件工程:在現有代碼庫中完成功能開發、缺陷修復與跨文件改造等複雜任務。 多輪終端自動化操作:智能體在命令行環境中連續執行數百輪工具調用,完成系統配置與運維任務。 大規模代碼庫重構遷移:跨倉庫技術棧升級、整體重構等需要數小時連續規劃執行的工程任務。 多智能體協作任務:主智能體委派子智能體的層級執行場景,
Qwen3.8-LiveTranslate – 阿里通義推出的實時同聲傳譯模型
Qwen3.8-LiveTranslate是什麼...
Qwen3.8-Omni-Flash – 阿里千問推出的原生全模態模型
Qwen3.8-Omni-Flash是什麼 Qw...
Qwen3.8-Flash – 阿里通義推出的多模態 MoE 模型
Qwen3.8-Flash是什麼 Qwen3.8...
Qwen3.8-27B-DFlash2 – Inco AI 開源的投機解碼草稿模型
Qwen3.8-27B-DFlash2是什麼 Q...
Qwen3.8-27B – 阿里千問團隊開源的新一代 AI 大模型
Qwen3.8-27B是什麼 Qwen3.8-2...
Qwen3.8-Max-Preview – 阿里通義推出的最新一代基座模型
Qwen3.8-Max-Preview是什麼 Q...
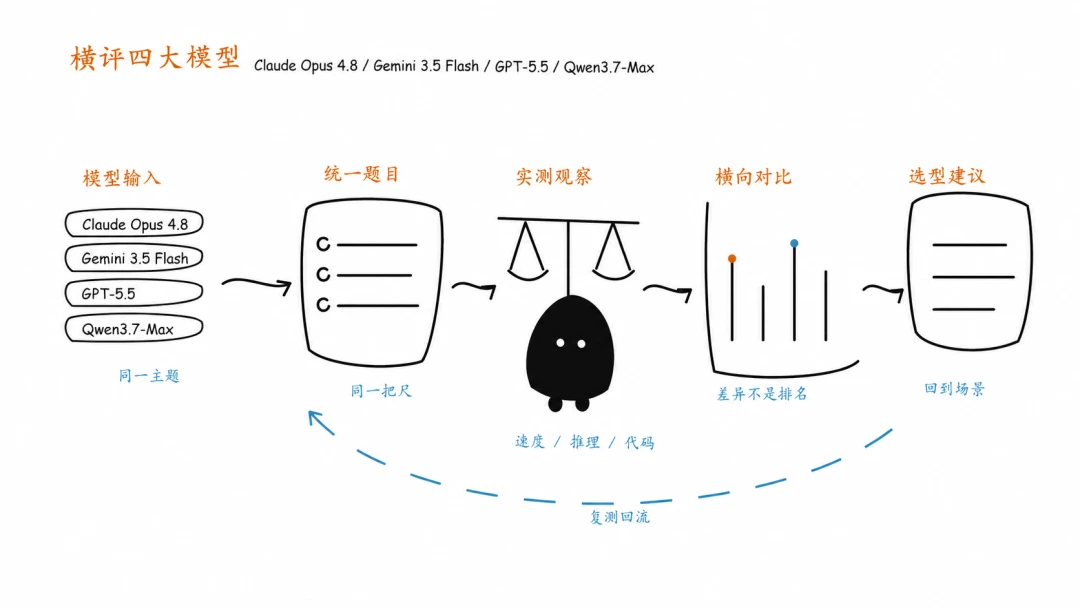
7大真實任務實測 Opus 4.8、Gemini 3.5 Flash、GPT-5.5、Qwen3.7-Max
最近大模型更新真的有點密,...
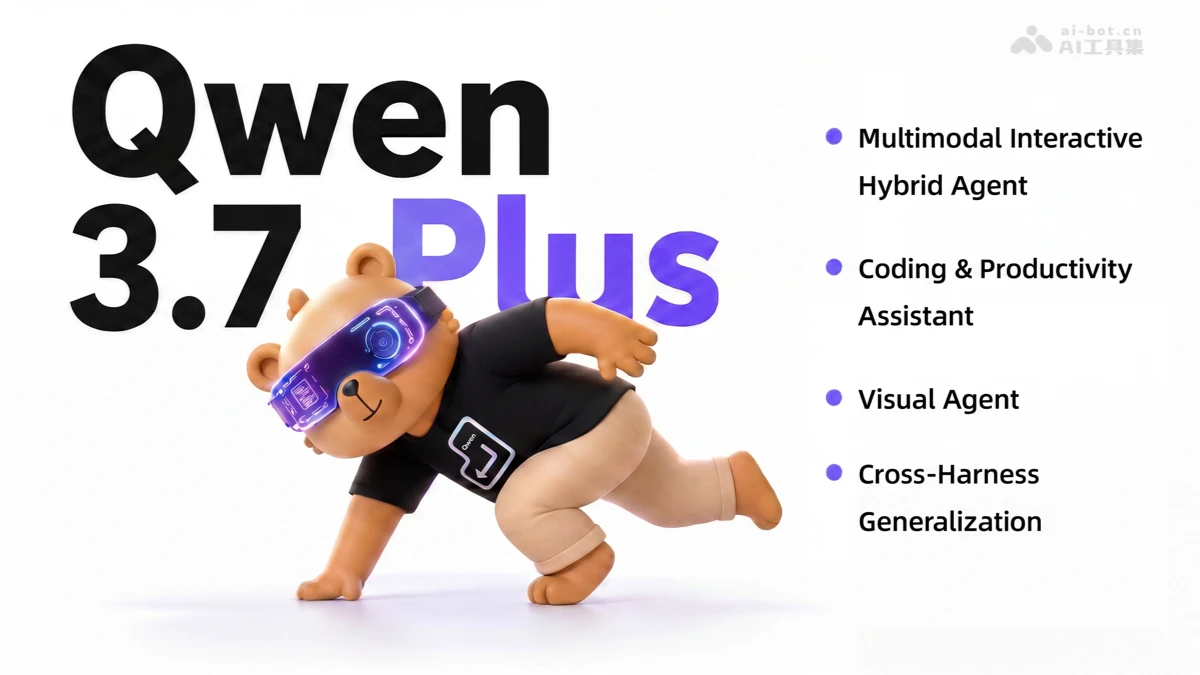
Qwen3.7-Plus – 阿里通義推出的智能體多模態大模型
Qwen3.7-Plus是什麼 Qwen3.7-...
Qwen3.6-27B – 阿里通義開源的稠密多模態模型
Qwen3.6-27B是什麼 Qwen3.6-2...
Qwen3.6-Max-Preview – 阿里通義推出的下一代旗艦模型
Qwen3.6-Max-Preview是什麼 Q...
Qwen3.6-35B-A3B – 阿里通義開源的混合專家 MoE 模型
Qwen3.6-35B-A3B是什麼 Qwen3...
Qwen3.6-Plus – 阿里通義推出的 Agent 編程模型
Qwen3.6-Plus是什麼 Qwen3.6-...
Qwen3.5-Omni – 阿里通義推出的全模態大模型
Qwen3.5-Omni 是什麼 Qwen3.5...
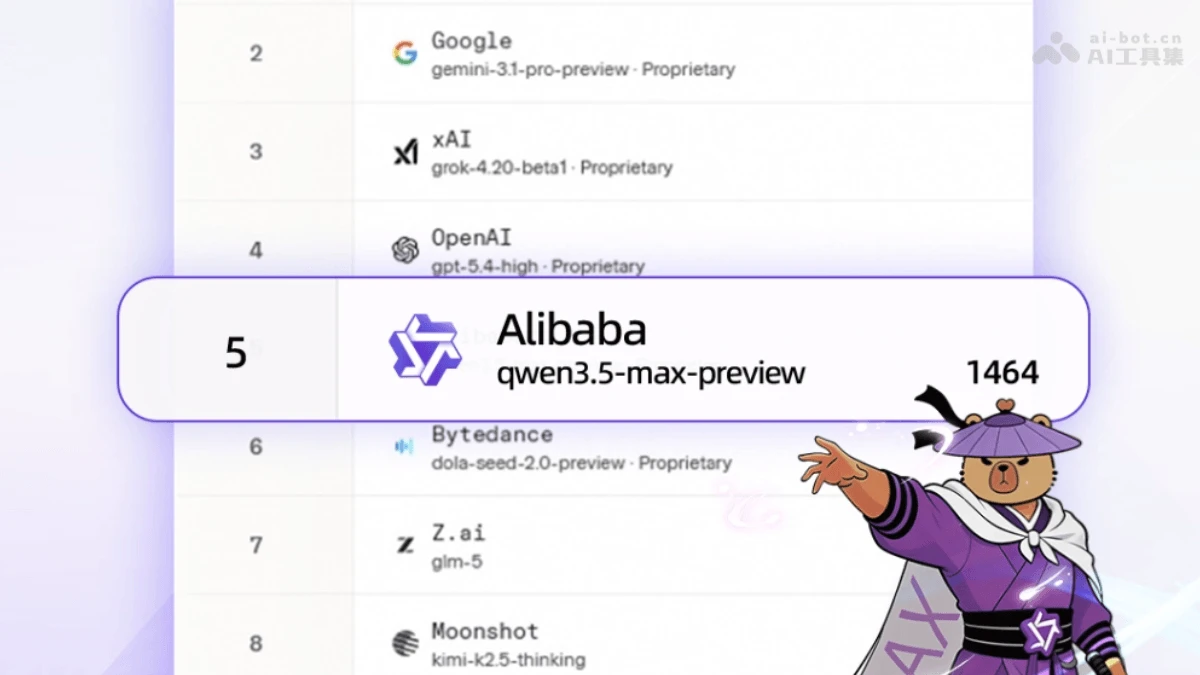
Qwen3.5-Max-Preview – 阿里通義推出的新一代旗艦模型
Qwen3.5-Max-Preview是什麼 Q...