最好用的AI工具
搜尋:DiT
19 個結果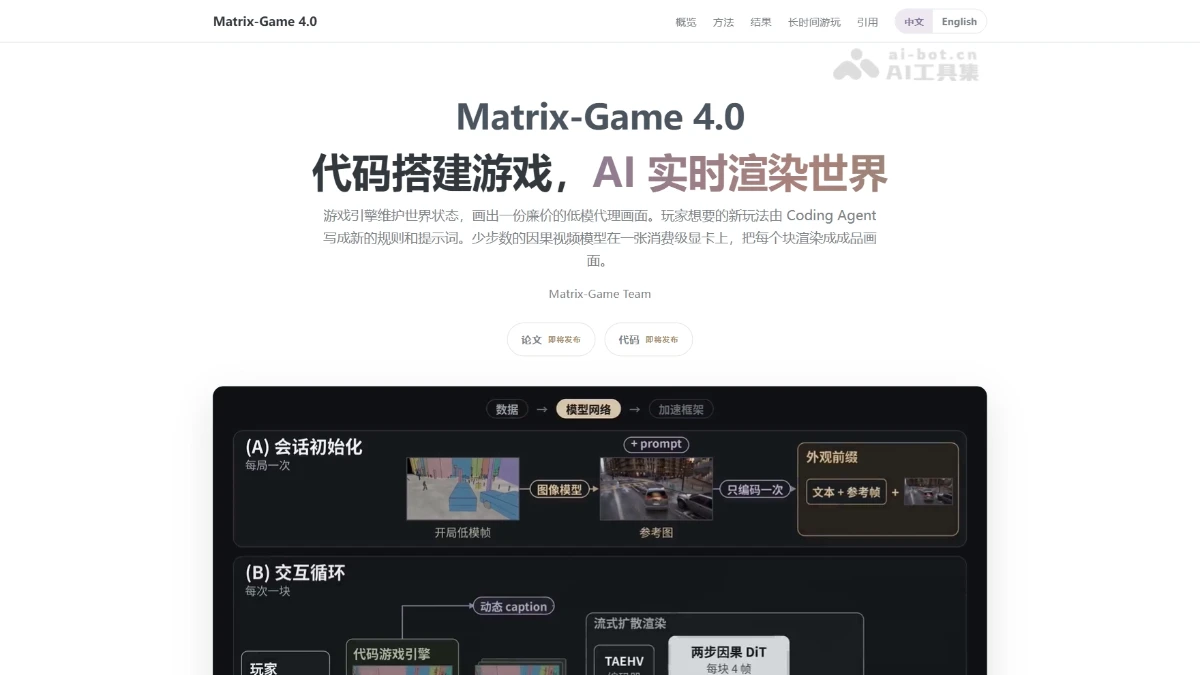
Matrix-Game 4.0 – 崑崙萬維開源顯卡運行的視頻大模型遊戲
Matrix-Game 4.0是什麼 Matrix-Game 4.0是崑崙萬維推出的全球首款運行在單張消費級顯卡上的視頻大模型遊戲,採用”Harness”新範式,遊戲引擎作爲裁判維護世界狀態與規則,Coding Agent 用自然語言改寫玩法,視頻模型作爲畫師實時渲染精細畫面。Matrix-Game 4.0單張 RTX 5090 可實現 480p、60 FPS、延遲低於150毫秒的遊戲體驗,讓小團隊能搭世界成爲現實。 Matrix-Game 4.0的主要功能 單卡實時運行:單張 RTX 5090 即可實現 480p、60 FPS、延遲低於 150 毫秒的可玩遊戲體驗。 自然語言改玩法:通過 Coding Agent 用一句指令調整地形、NPC 行爲或設計全新玩法規則。 世界狀態顯式管理:遊戲引擎以代碼維護血量、揹包、碰撞、勝負等狀態,物體離開視野仍持續演化。 低模轉精細畫面:視頻模型把引擎輸出的幾何結構畫面實時重渲染爲帶光影材質的 3A 級畫面。 長時間一致遊玩:支持 54-99 秒不間斷遊玩,場景、角色身份與交互結果保持穩定不漂移。 Matrix-Game 4.0的技術原理 Harness 架構:系統給視頻模型套上由 Coding Agent 和遊戲引擎組成的Harness,引擎負責規則之內的狀態演化並輸出結構畫面,Coding Agent 把用戶意圖轉成新規則與細化提示詞,視頻模型只專注渲染,三者分工解耦。 結構-精細畫面對齊數據:基於 UE5 構建跨域數據集,用輕量化幾何抽象採集管線將複雜場景抽象爲保留空間拓撲的低模結構表徵,與高模畫面逐幀像素級對齊,同步捕獲實例 ID 與因果事件元數據。 動態 Caption:系統將物體 ID 與語義描述關聯,運行時從引擎讀取當前可見對象及實時狀態填入提示詞模板,與結構畫面配合,共同提供畫什麼、畫在哪的條件約束。 可控 V2V 生成:基於 Wan2.2 5B 改造,結構畫面與待生成視頻以 148 通道拼接輸入 30 層因果 DiT,自注意力讀取空間記憶與歷史 KV 緩存,交叉注意力讀取文本條件,用自迴歸方式逐塊生成。 微信關注回覆“開源”,加入AI開源項目交流羣 如何使用Matrix-Game 4.0 消費級單卡實時:單張 RTX 5090 跑出 480p、60 FPS、112ms 延遲,首次讓視頻模型遊戲走出實驗室的多卡集羣。 世界狀態顯式可管:遊戲引擎以代碼維護世界規則,狀態可讀取、可修改、可驗證,根治了上一代世界只存在模型記憶裏的漂移問題。 一句話改玩法:Coding Agent 將自然語言指令直接轉爲遊戲規則與代碼,創意迭代不再受 3D 資產生產線拖累。 長時間穩定一致:空間記憶 + 參考幀 + 動態 Caption 機制,保障長時段遊玩中場景結構和物體身份不崩壞。 性能斷層領先:延遲約爲 Code World Model 的 1/90、StreamRender-H3 的 1/5,且對端是唯一消費級方案。 Matrix-Game 4.0的核心優勢 消費級單卡實時:單張 RTX 5090 跑出 480p、60 FPS、112ms 延遲,首次讓視頻模型遊戲走出實驗室的多卡集羣。 世界狀態顯式可管:遊戲引擎用代碼維護世界規則,狀態可讀取、可修改、可驗證。 一句話改玩法:Coding Agent 將自然語言指令直接轉爲遊戲規則與代碼,創意迭代不再受 3D 資產生產線拖累。 長時間穩定一致:空間記憶 + 參考幀 + 動態 Caption 機制,保障長時段遊玩中場景結構和物體身份不崩壞。 性能斷層領先:延遲約爲 Code World Model 的 1/90、StreamRender-H3 的 1/5,且對端是唯一消費級方案。 Matrix-Game 4.0的項目地址 項目官網:https://matrix-game-v4-0.github.io/page/ GitHub倉庫:https://github.com/SkyworkAI/Matrix-Game.git HuggingFace模型庫:https://huggingface.co/Skywork/Matrix-Game-4.0 Matrix-Game 4.0的同類競品對比 對比維度 Matrix-Game 4.0 StreamRender-H3 端到端延遲 112ms(實時可玩) 約 545ms 硬件要求 單張 RTX 5090(消費級,32GB) 8× GB200(數據中心級) 分辨率/幀率 480p @ 60 FPS 未達消費級實時標準 世界狀態管理 引擎顯式維護,可讀取/修改/驗證 主要依賴模型內部表示 玩法定製
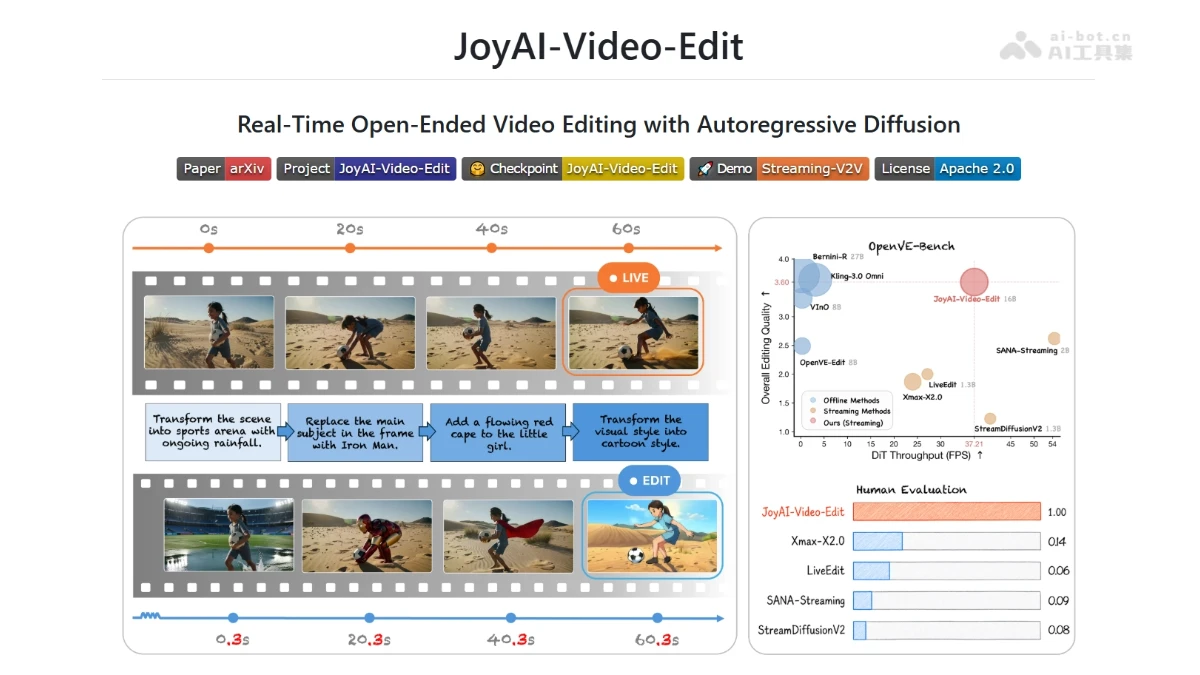
JoyAI-Video-Edit – 京東開源的實時流式視頻編輯模型
JoyAI-Video-Edit是什麼 JoyA...
Step Image Edit 2 – 階躍星辰推出的圖像生成編輯模型
Step Image Edit 2是什麼 Ste...
JoyAI-Image-Edit – 京東開源的指令引導圖像編輯模型
JoyAI-Image-Edit是什麼 JoyA...
LongCat-AudioDiT – 美團開源的文本轉語音模型
LongCat-AudioDiT是什麼 Long...
Pascal Editor – 開源 3D 建築編輯工具,在瀏覽器直接運行
Pascal Editor是什麼 Pascal ...

Ming-omni-tts – 螞蟻集團開源的統一音頻生成模型
Ming-omni-tts是什麼 Ming-omni-tts 是螞蟻集團開源的統一音頻生成模型,採用自迴歸架構實現語音、音樂和音效的聯合生成。模型支持通過自然語言指令對語速、音調、音量、情感和方言進行細粒度控制,粵語方言控制準確率達93%,情感控制準確率46.7%,超越CosyVoice3。技術上採用統一連續音頻Tokenizer和Diffusion Transformer架構,以12.5Hz幀率處理多模態音頻,通過”Patch-by-Patch”壓縮策略將LLM推理幀率降至3.1Hz,在降低延遲的同時保持音質。16.8B參數版本在Seed-tts-eval中文測試集上WER僅0.83%,超越SeedTTS和GLM-TTS。模型內置100+優質音色,支持零樣本聲音設計,提供Docker鏡像和Gradio演示,適用於有聲書、播客、多語言內容創作等場景。 Ming-omni-tts的主要功能 統一多模態音頻生成:業界首個自迴歸模型,可在單通道中聯合生成語音、環境音和音樂,實現”身臨其境”的聽覺體驗。 細粒度語音控制:支持通過簡單指令精確控制語速、音調、音量、情感和方言,粵語方言控制準確率高達93%,情感控制準確率達46.7%。 智能聲音設計:內置100+優質音色,支持通過自然語言描述進行零樣本聲音設計。 高效推理優化:採用”Patch-by-Patch”壓縮策略,將LLM推理幀率降至3.1Hz,顯著降低延遲。 專業文本歸一化:準確解析和朗讀複雜數學表達式、化學方程式等專業格式,內部測試集CER僅1.97%。 多語言支持:支持中文、英文等多種語言的語音合成與跨語言遷移。 零樣本TTS:僅需3-10秒參考音頻即可克隆任意音色,在Seed-tts-eval上WER低至0.83%。 Ming-omni-tts的技術原理 統一連續音頻Tokenizer:基於VAE的連續Tokenizer,以12.5Hz幀率將語音、音樂和通用音頻整合到統一潛空間,支持多模態音頻的聯合建模。 Diffusion Transformer (DiT) Head:採用擴散頭架構增強音頻生成質量,提升音質細膩度和自然度。 Patch生成策略:採用patch大小爲4、回溯歷史爲32的生成策略,在局部聲學細節和長期結構連貫性之間取得平衡。 自迴歸生成架構:業界首個在單通道中聯合生成語音、音樂和音效的自迴歸模型,實現統一音頻生成。 “Patch-by-Patch”壓縮機制:通過壓縮策略將LLM推理幀率從原始頻率降至3.1Hz,大幅降低計算延遲和推理成本。 指令微調對齊:通過指令微調實現對語速、音調、音量、情感和方言的細粒度控制,支持自然語言指令解析。 Ming-omni-tts的項目地址 GitHub倉庫:https://github.com/inclusionAI/Ming-omni-tts Hugging Face模型庫: https://modelscope.cn/models/inclusionAI/Ming-omni-tts-16.8B-A3B https://huggingface.co/inclusionAI/Ming-omni-tts-0.5B Ming-omni-tts的應用場景 有聲書與播客製作:支持長文本語音合成,Podcast TTS任務CER僅1.84%,適合有聲讀物、新聞播報和播客內容生成。 多語言內容創作:支持中文、英文等多語言語音合成與跨語言音色遷移,滿足全球化內容生產需求。 遊戲音效設計:可聯合生成語音、環境音和音樂,爲遊戲場景提供沉浸式音頻體驗。 教育培訓領域:準確朗讀複雜數學表達式、化學方程式等專業內容,適用於在線教育課件和學術講解。 智能客服與助手:內置100+優質音色,支持零樣本聲音克隆,可快速定製品牌專屬語音助手。 廣告與營銷配音:通過情感控制和方言支持,生成富有感染力的廣告配音和本地化營銷內容。
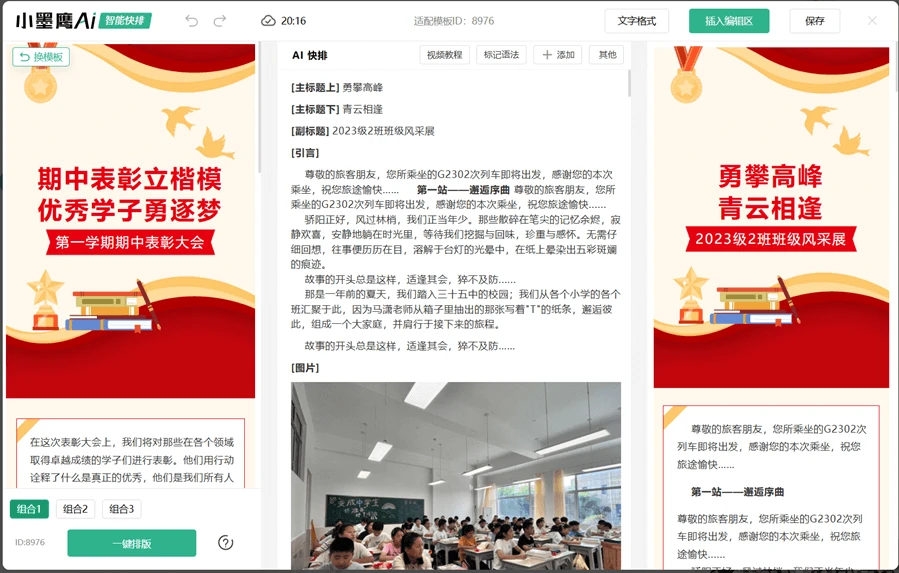
微信編輯器哪個好用?新手TOP級公衆號排版工具用這個就夠了
“一篇推文寫了2小時,排版卻花了半天!” “老闆要求精美動效,可我連SVG代碼都不懂…” “明天要發5條推文,今晚又要通宵改格式了…” 如果你也是公衆號運營者,這些哭訴一定不陌生。傳統排版工作佔用了內容創作者60%以上的時間——找模板、調格式、對齊圖片、設置動效、反覆預覽,一套流程下來早已精疲力盡。 市場上微信編輯器琳琅滿目,各自的功能差異明顯,究竟哪款更適合新手或者自己呢? 今天,小墨鷹編輯器用AI徹底改變了這個現狀。經過10年技術深耕,服務500萬用戶,能讓30秒完成專業級排版,效率直接提升300%。 下面,我將結合數據和實際測評,詳細解析爲什麼小墨鷹編輯器成爲最值得推薦的新手公衆號排版工具。 01. 極致排版體驗 AI快排:30秒完成3小時工作量 這是行業內首創的AI全自動排版功能。你只需: 導入Word文檔或直接撰寫內容 AI自動識別標題層級、段落結構、圖文關係(準確率達96%) 30秒內自動匹配模板、配色、配圖方案 實測案例:某企業市場專員導入一份產品手冊,AI自動拆解出”大標題+引言+3個賣點+對比表格+二維碼”結構,全程0手動操作,直接生成商務風精美排版。 25萬+模板庫,冷門行業也有專屬設計 市面上編輯器模板往往只有幾千套,小墨鷹擁有25萬+單素材: 45大行業全覆蓋:教育、醫療、政務、科技、母嬰、金融… 每日更新:連”世界廁所日”這種冷門節日都有專屬模板 一鍵秒刷換色:選中模板後,一鍵切換企業品牌色 傻瓜式SVG動效:無需代碼,替換文字即可 想做出點擊展開、圖片輪播、滑動切換的效果? 傳統方式:學習SVG代碼,調試3小時起步 小墨鷹方式:選擇3000+現成動效素材 → 彈窗中替換文字和圖片 → 直接發佈 某幼兒園老師反饋:”用輪播SVG展示孩子們的活動照片,家長閱讀量提升了200%!” 安全合規雙認證,大企業都在用 不同於市面上”三無”排版工具,小墨鷹已完成: 《互聯網信息服務算法備案》(網信算備號可查) 微信開發平台官方認證 02. 實操指南:新手5分鐘完成專業推文 第一步:快速註冊登錄 訪問官網:https://www.xmyeditor.com,支持PC端+手機端跨設備操作,雲端自動保存草稿。 第二步:選擇創作方式 有現成文檔:直接導入Word/PPT/PDF,AI自動識別結構 從零撰寫:在編輯區寫作,實時使用”AI續寫”功能輔助創作 熱點跟進:使用內置”熱點日曆”查看今日可借勢話題 第三步:AI一鍵排版,點擊【AI快排】按鈕,系統會: 分析文章類型(活動通知/產品介紹/政策解讀) 自動推薦3-5套匹配模板 完成字體、配色、間距、配圖的全局優化 第四步:添加互動效果(可選),在【素材庫】→【SVG動效】中選擇: 點擊展開:適合放置活動詳情或優惠碼 自動輪播:展示多張產品圖或團隊照片 滑動解鎖:增加閱讀趣味性 操作:選中素材 → 彈窗提示替換文字/圖片 → 確認即可,全程鼠標點擊,零代碼。 第五步:多平台分發 同步公衆號:一鍵授權至微信後台,支持定時羣發 導出長圖:生成最高10萬像素長圖,適合朋友圈傳播 導出PDF:直接打印成宣傳手冊 03. 案例分享 案例1:幼師張女士(教育行業) 背景:幼兒園需要每週發佈3篇活動推文,之前找設計師外包,單篇成本200元,耗時2天。 使用小墨鷹後: 直接導入活動策劃Word文檔 → AI快排30秒生成 使用”卡通可愛”風格模板+SVG照片輪播 單篇製作時間從2天縮短至15分鐘 家長閱讀量提升200%,園方決定取消外包,全部自營 案例2:某政務新媒體(政府宣傳) 背景:需要發佈政策解讀類文章,要求紅色政務風格+嚴肅排版+版權安全。 使用小墨鷹後: 選用”紅色政務”專題模板,確保視覺規範 利用正版商用字體,避免法律風險 通過AI快排快速響應熱點,從撰稿到發佈縮短至1小時內 案例3:連鎖餐飲品牌(商業營銷) 背景:管理5個區域公衆號賬號,需要統一品牌風格但內容不同。 使用小墨鷹後: 綁定多賬號(支持3-20個號),切換自如 設置品牌專屬模板庫,加盟商直接調用 參數二維碼功能追蹤各門店推廣效果 04. FAQ:新手最關心的問題 Q:完全沒有設計基礎,能上手嗎? A:小墨鷹定位就是“新手TOP級工具”,86%的用戶推薦率來自零基礎用戶。AI快排全程自動,SVG動效也是傻瓜式操作,官網有3分鐘視頻教程包教包會。 Q:免費版和付費版有什麼區別? A:免費版已包含大量基礎模板和AI快排功能,足夠個人使用;付費版(價格親民)解鎖25萬+全行業模板、AI去水印、多賬號管理等進階功能,
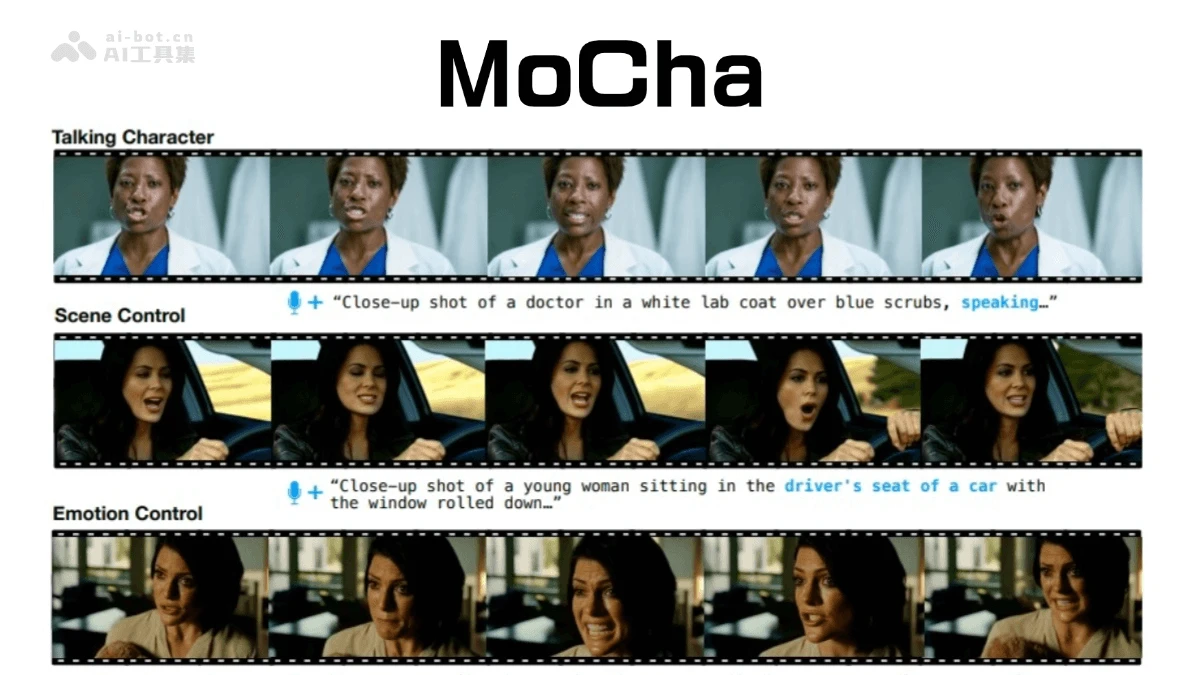
MoCha – Meta 聯合滑鐵盧大學推出的端到端對話角色視頻生成模型
MoCha是什麼 MoCha AI 是 Meta 和滑鐵盧大學聯合開發的端到端對話角色視頻生成模型。能根據文本或語音輸入生成帶有同步語音和自然動作的完整角色動畫。MoCha 採用語音-視頻窗口注意力機制,解決了視頻壓縮時音頻分辨率不匹配以及脣部動作錯位的問題。支持多角色輪換對話,能生成具有情感表達和全身動作的角色動畫。 MoCha的主要功能 語音驅動角色動畫生成:用戶輸入語音,MoCha 可以生成與語音內容同步的角色嘴型、面部表情、手勢及身體動作。 文本驅動角色動畫生成:用戶僅輸入文本腳本,MoCha 會先自動合成語音,再驅動角色進行完整的口型和動作表現。 全身動畫生成:與傳統僅生成面部表情或嘴型的模型不同,MoCha 能生成全身的自然運動,涵蓋嘴脣同步、手勢以及多角色之間的互動。 多角色輪番對話生成:MoCha 提供結構化提示模板與角色標籤,能自動識別對話輪次,實現角色間“你來我往”的自然對話呈現。在多角色場景中,用戶只需定義一次角色信息,可以通過簡單的標籤(如“人物1”“人物2”)在不同的場景中引用這些角色,無需重複描述。 MoCha的技術原理 擴散變壓器(DiT)架構:MoCha 基於擴散變壓器(Diffusion Transformer)架構,通過將文本和語音條件依次通過交叉注意力機制融入模型,有效捕捉語義和時間動態。能生成逼真且富有表現力的全身動作,同時確保角色動畫與輸入語音的精確同步。 語音-視頻窗口注意力機制:爲了解決視頻壓縮和並行生成帶來的語音-視頻對齊問題,MoCha 引入了語音-視頻窗口注意力機制。限制每個視頻標記只能關注與其時間上相鄰的音頻標記,提高口型同步的準確性和語音-視頻對齊效果。模擬了人類語音的運作方式,使角色的口型與對話內容精準匹配。 聯合訓練策略:MoCha 採用了聯合訓練策略,同時基於語音標註和文本標註的視頻數據進行訓練。增強了模型在多樣化角色動作上的泛化能力,通過自然語言提示實現對角色表情、動作、互動和環境的精細控制。 結構化提示模板:爲了簡化多角色對話的文本描述,MoCha 設計了結構化提示模板,通過爲每個角色分配唯一標籤在文本中使用這些標籤來描述角色的動作和互動。減少了冗餘,提高了模型在多角色場景中的生成效果。 多階段訓練框架:MoCha 採用了多階段訓練框架,根據鏡頭類型(如特寫鏡頭、中景鏡頭)對數據進行分類,逐步引入更復雜的任務。確保了模型在不同難度任務上的表現,同時提高了訓練效率。 MoCha的項目地址 項目官網:https://congwei1230.github.io/MoCha/ arXiv技術論文:https://arxiv.org/pdf/2503.23307 MoCha的應用場景 虛擬主播:MoCha 可以自動生成日常 Vlog、角色問答等內容。通過語音或文本輸入,生成與語音內容同步的角色嘴型、面部表情、手勢及身體動作,使虛擬主播更加生動自然。 動畫影視創作:MoCha 支持 AI 自動配音和自動動畫生成,能降低動畫影視創作的製作成本。能生成全身動畫,讓角色動作更加自然,接近電影級數字人演出。 教育內容創作:MoCha 可以作爲 AI 老師角色進行講課或互動。通過文本驅動的方式,生成與教學內容匹配的角色動畫,提高教育內容的趣味性和吸引力。 數字人客服:MoCha 可以用於擬人化企業客服、諮詢角色。通過語音或文本輸入,生成自然流暢的客服對話動畫,提升用戶體驗。
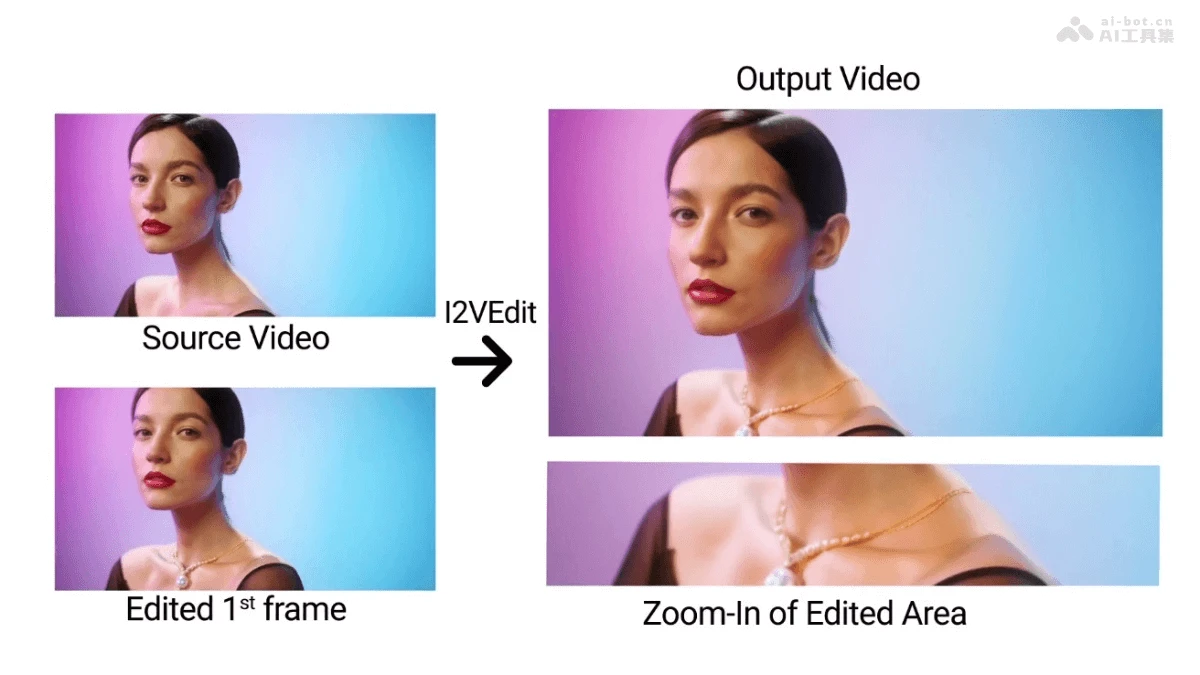
I2VEdit – AI視頻編輯技術,基於擴散模型實現首幀編輯引導
I2VEdit是什麼 I2VEdit是一個...
豆包PixelDance – 字節跳動推出的AI視頻生成大模型,基於DiT結構
豆包PixelDance是什麼 豆包Pi...
AIEditor – 面向AI的下一代富文本編輯器
AIEditor是什麼 AIEditor是面...
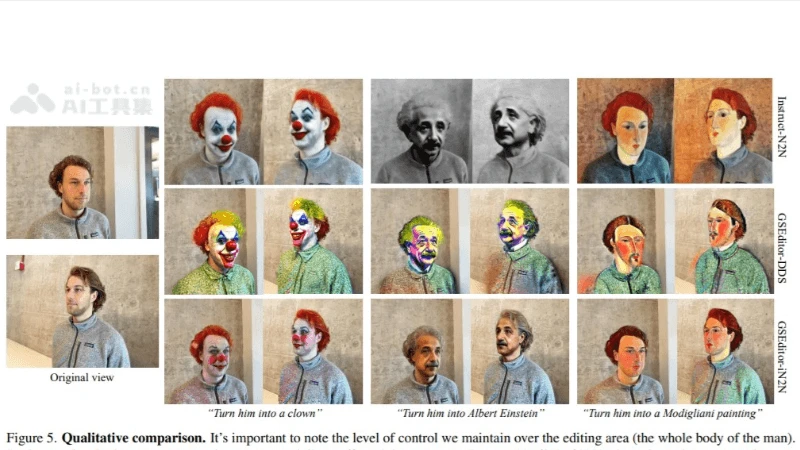
GaussianEditor – 一種3D編輯算法,支持快速且精確地修改3D場景
GaussianEditor是什麼 Gaussi...
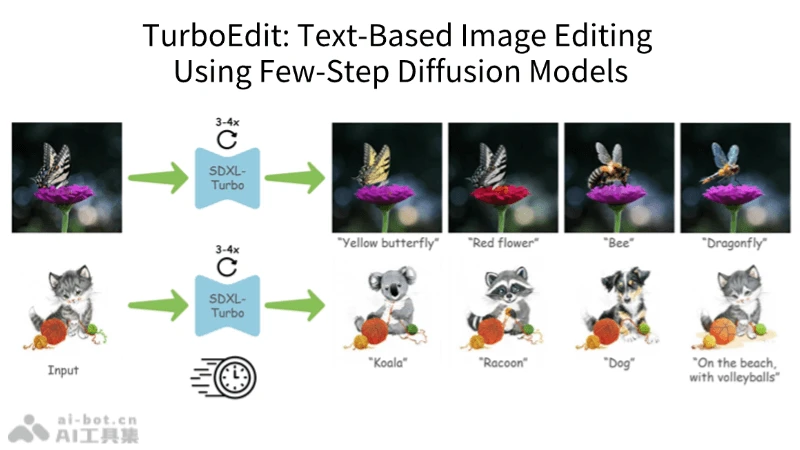
TurboEdit – Adobe推出的AI即時圖像編輯模型
TurboEdit是什麼 TurboEdit是...
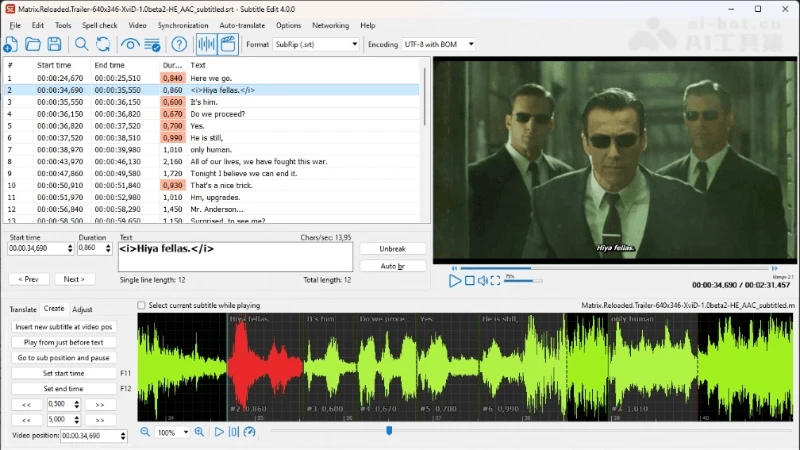
Subtitle Edit – 免費開源的多功能字幕編輯器
Subtitle Edit是什麼 Subtitl...
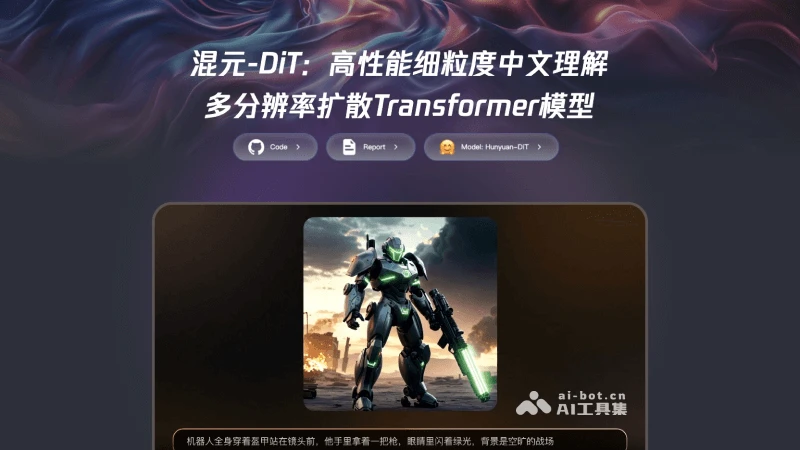
混元DiT - 騰訊混元開源的文生圖擴散模型Hunyuan-DiT
混元DiT是什麼 混元DiT(Huny...
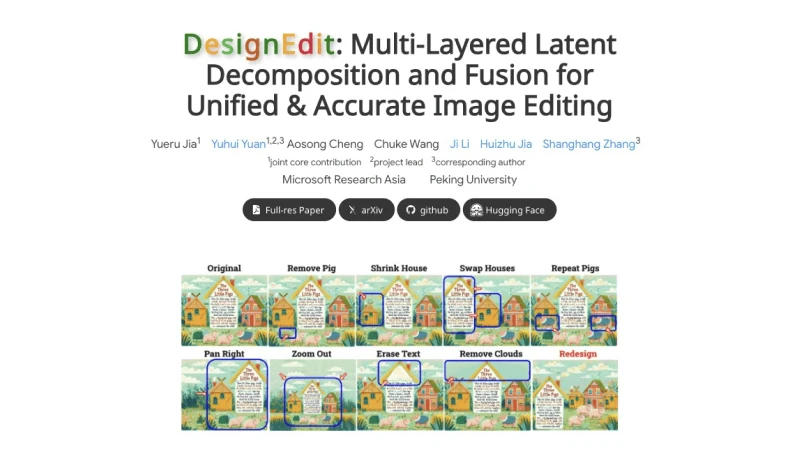
DesignEdit - 微軟等開源的AI圖像分層處理編輯框架
DesignEdit是什麼 DesignEdit...
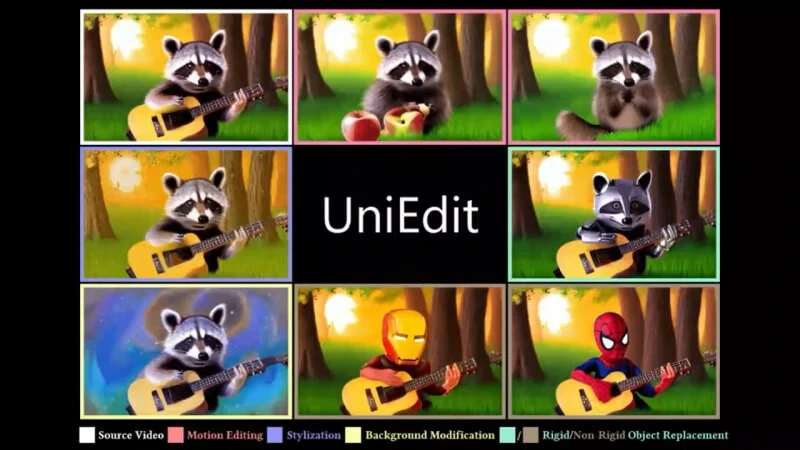
UniEdit - 免訓練調優的統一視頻編輯框架
UniEdit是什麼 UniEdit是由浙...
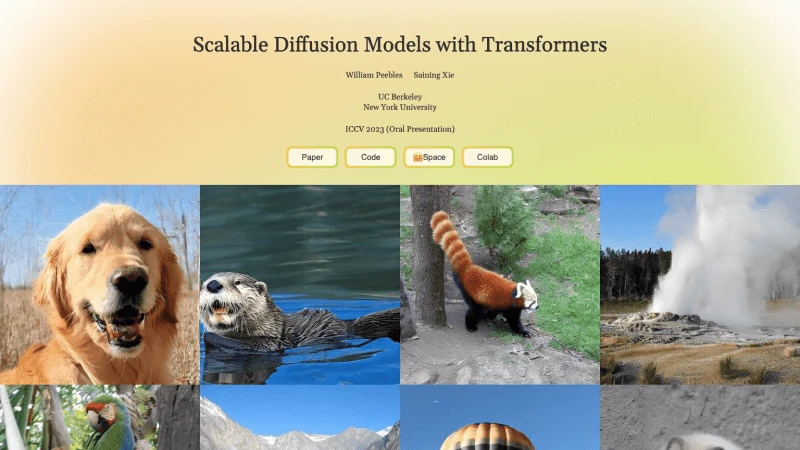
DiT - 基於Transfomer架構的擴散模型
DiT是什麼 DiT(Diffusion Tr...