最好用的AI工具
搜尋:DeepSeek
29 個結果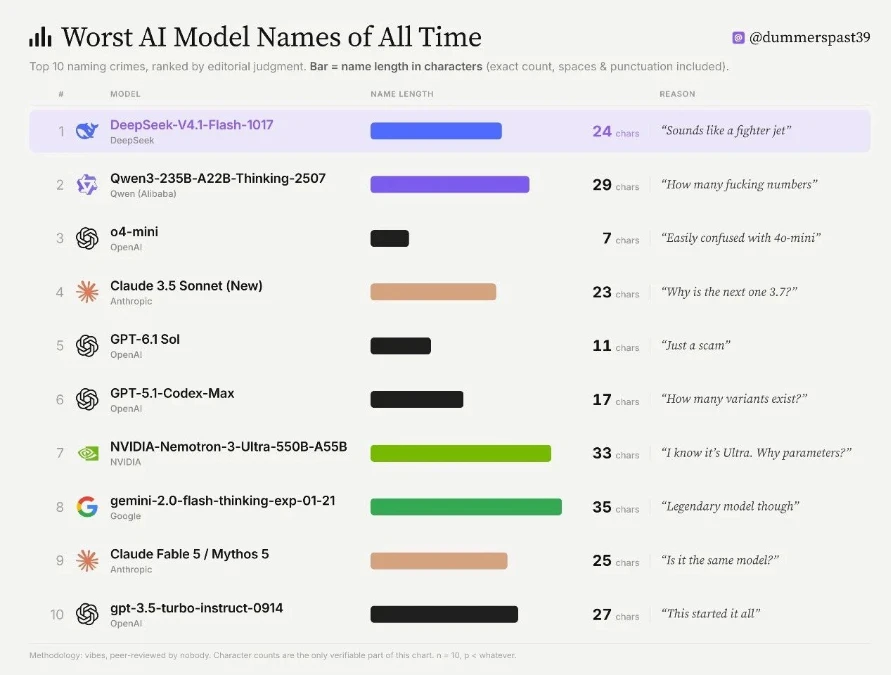
DeepSeek V4.1 Flash 1017 實測 – 幾句話生成完整項目
最近 DeepSeek 更了新模型,DeepSeek-V4.1-Flash-1017,一更新就登上了兩大排行榜榜首。 名字拉跨模型榜首: 開源模型榜首: 這次DeepSeek-V4.1-Flash-1017 官方打的是許願式編程的旗號,那是不是真的能幾句話出項目呢?實測一波不就知道了。 01. 模型實測 官方說 DeepSeek V4.1 Flash 1017 通過基於自反饋的強化學習(RL)訓練技術,提升了在遊戲開發、3D 建模等方面從零開始構建完整項目的能力,能夠支持實現更多許願式編程任務及項目開發請求。 說人話就是有了少量提示詞出完整項目對的能力,我們今天就用幾句話的提示詞來試試。 case 1 超光速穿梭網頁 提示詞:製作一個名爲 HYPERSPEED 的全屏交互網頁,使用 Three.js 實時繪製穿梭於霓虹高速公路的第一人稱場景。黑色背景,青色與洋紅色燈帶沿道路兩側延伸,車輛燈軌不斷經過鏡頭。按住鼠標或手機屏幕時,行進速度逐漸提高,燈軌拉長,鏡頭視野擴大;鬆開後平滑恢復。提供三種可切換配色,以及速度和光軌密度控制。頁面只保留簡潔標題、操作提示和底部控制欄。動畫由代碼實時生成,不使用背景視頻。 長按加速時,燈軌、視野、速度讀數和操作提示都會跟着變化,三種配色及參數調節也能正常使用,畫面的空間感已經出來了。 case 2 產品爆炸拆解 提示詞: 製作一個機械鍵盤的交互式產品展示網頁,使用 Three.js,通過基礎幾何體生成鍵盤模型。 初始顯示完整鍵盤,採用深灰色外殼、米白色鍵帽和橙色 Esc 鍵。滾動頁面時固定展示區域,讓鍵帽、軸體、定位板、電路板、消音棉和底殼依次分離,形成清晰的立體爆炸圖。 各層分離時出現名稱與引導線。繼續滾動,所有部件重新組裝;反向滾動時動畫能夠連續倒放。提供鼠標拖動觀察角度的功能,整體採用簡潔的工業產品展示風格。 滾動拆解完成得比較完整。六層結構依次展開,名稱和引導線跟着部件移動,繼續滾動還能重新組裝。鍵帽字符、定位板開孔和電路板走線也有體現。 case 3 3D 懸浮銀行卡輪播 提示詞: 製作一個全屏 3D 銀行卡展示網頁,純黑背景,五張不同材質的虛構銀行卡圍繞一個不可見的橫向圓柱排列。 中央卡片正對觀衆,其餘卡片沿圓柱向後旋轉,呈現透視和遮擋關係。支持拖動切換,鬆手後帶慣性並自動吸附到最近一張。鼠標移動時,中央卡片輕微傾斜;點擊可翻到背面,再次點擊恢復。 卡片有可見厚度、金屬芯片、虛構卡號和背面磁條。用 CSS 漸變生成鐳射、磨砂和金屬質感,不使用視頻或卡片截圖。 銀行卡輪播的細節完成得比較好。五張卡片各有不同紋理,翻面後也有完整的磁條和簽名欄。拖動時能感受到慣性與自動吸附,快速甩動和停頓後鬆手會得到不同結果。 case 4 鼠標探照燈 提示詞: 製作一個名爲「地層之下」的全屏交互網頁。 默認畫面是一片安靜的山地景觀。鼠標移動時,一個邊緣柔和的圓形探照燈跟隨光標,光圈內顯示對應位置的地下剖面,包括岩層、晶體和化石,光圈外仍然顯示地表。 地表與地下畫面使用 SVG 或 Canvas 繪製,空間位置保持對應。光圈帶少量跟隨延遲,滾輪可調整大小。前景加入簡潔標題、說明和探索按鈕,手機端支持手指拖動探照燈。 探索過程做得比較完整。移動光圈能揭開山體內部的岩層,靠近化石和晶洞時會出現對應標註,按鈕還能自動帶着瀏覽三處標本,山巒、薄霧和儀器刻度形成了統一的視覺風格。 case 5 海報風動態首頁 提示詞: 製作一個名爲 BEYOND 的創意工作室首頁,採用橙色背景、超大白色標題,以及淺綠和淺藍的錯位文字疊層,呈現復古立體海報效果。 首屏中央繪製一個原創 SVG 抽象角色,讓角色遮住部分標題,形成前後層次。頁面兩側排列大號關鍵詞,滾動時從兩側逐漸向中央移動,同時提高透明度。 下一屏是一條白底橙字的無縫滾動文字帶。 桌面端構圖大膽,手機端重新安排文字與角色的位置,保持標題清楚可讀。 海報風格比較鮮明。橙色背景、錯位大字和獨眼角色形成了統一構圖,滾動時兩側關鍵詞向內移動,接着進入白底橙字的跑馬燈區域,視覺演示已經比較完整。 case 6 液態漸變首頁 提示詞: 製作一個名爲 FLUID 的全屏交互首頁。 背景由五個緩慢運動的彩色色團組成,採用深藍、青色、珊瑚橙和少量紫紅。色團接近時像黏稠液體一樣融合,分離時自然拉伸。增加一個跟隨鼠標的色團,讓用戶能用光標影響畫面。 使用 SVG 濾鏡、CSS 或 Canvas 實現實時效果。提供暫停、運動速度和配色切換功能。前景放置清晰的大標題、簡短介紹及兩個按鈕,背景運動時仍保持文字可讀。 液態背景和控制面板都做出來了。鼠標能作爲額外的色團參與畫面,暫停、調速、換色和擾動按鈕也都有實際反饋。說明彈窗還能保留原先的播放狀態,細節比較完整。 實測總結:
DeepInfer – DeepSeek 開源的生產級推理框架
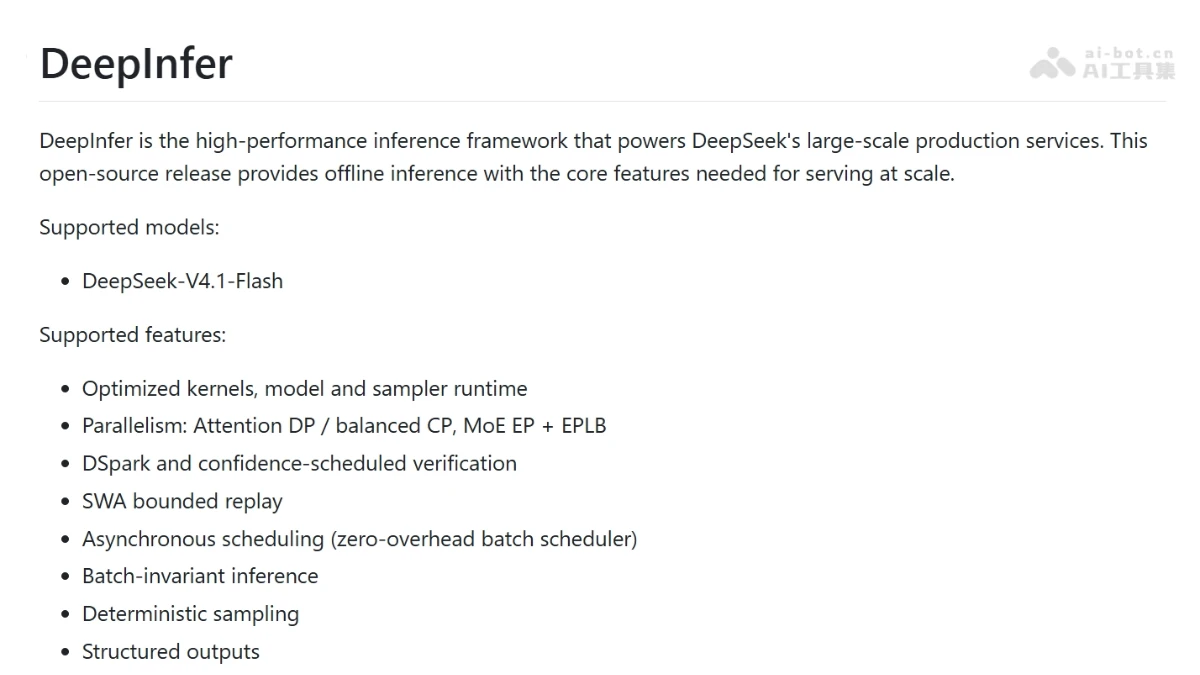
DeepInfer是什麼 DeepInfer 是 DeepSeek 開源的生產級推理框架,源自 vLLM,支持 V4.1 Flash,可運行於英偉達 SM100 與華爲昇騰 950。DeepInfer 採用 PD 分離部署,靠 3FS 緩存集羣實現 96% 輸入命中、Prefill 提效 25 倍,SWA Bounded Replay 令 Prefill 計算量減半,DSpark 投機解碼再提吞吐 6%,線上單集羣日處理 155 萬億 Token。同步開源的 deepseek-recipe是生產級 Token 編解碼組件,負責統一 Chat Completions、Responses、Messages 三種 API 格式,處理注入防護、並行分詞與流式輸出,使自部署模型的接口表現與官方 API 完全一致。 DeepInfer的主要功能 分佈式推理:支持注意力數據並行、上下文並行及 MoE 專家並行,支撐單集羣日處理 155 萬億 Token 的大規模生產服務。 跨硬件平台兼容:同時支持英偉達 SM100 GPU 與華爲昇騰 950 NPU,覆蓋兩大算力生態。 長上下文高效處理:通過 SWA Bounded Replay 將緩存未命中的重算成本壓縮到固定 128 個 Token,與上下文長度和層數解耦。 推測解碼加速:集成自研 DSpark 與置信度驗證調度,讓模型一次推進多個 Token,顯著提升生成吞吐。 負載均衡調度:動態均衡專家與請求的分佈,線上最繁忙的卡僅高出平均負載 9%。 緩存複用:依託 3FS 存儲集羣實現 96% 的輸入緩存命中率,Prefill 吞吐提升約 25 倍。 DeepInfer的技術原理 PD 分離部署:推理分爲 Prefill 與 Decode 兩個階段:Prefill 一次性處理數萬 Token 的輸入,是計算密集型;Decode 逐 Token 生成,受限於顯存帶寬讀取。DeepInfer 將兩者部署在不同硬件上,Prefill 用常規 8 卡服務器,Decode 用 64–128 卡超節點,兩類機器數量按約 1:1 配置,使各自按最優硬件特性運行。 前綴緩存體系:Agent 場景下每次工具調用都會重發完整歷史,其中大部分內容已計算過。系統只緩存從首 Token 起完全一致的前綴,命中部分直接複用 KV Cache,僅計算新增部分。緩存存放於獨立的 3FS 分佈式存儲集羣,用 128 Token 爲塊寫入,Agent 流量保留 3 天、聊天流量保留 7 天。 SWA Bounded Replay:V4.1 Flash 的部分層採用滑動窗口注意力,每個 Token 只關注最近 128 個 Token,這部分 KV Cache 不寫入硬盤、僅駐留在計算機器的內存中。未命中時舊方案需按”層數 × 窗口長度”精確重算,V4.1 改爲只重算最後 128 個 Token、且注意力僅在這 128 個內計算,得到近似窗口緩存,重算成本固定。 DSpark 推測解碼與異步調度:由輕量草稿模塊先連續猜測 5 個 Token,再由目標模型批量驗證,猜對的直接採用、首個猜錯處由大模型糾正,一步計算即可推進多個 Token。置信度頭預估各猜測被接受的概率,低可能性的不再驗證、把算力讓給其他請求,相比固定驗證 5 個的方案線上吞吐提升 6%。同時 CPU 調度第 N+1 步與 GPU 計算第 N 步重疊執行,消除 GPU 在調度間隙的空轉。 微信關注回覆“開源”,加入AI開源項目交流羣 如何使用DeepInfer 確認環境前置條件:Linux 系統,GCC ≥ 13.0、Python 3.12,NVIDIA 平台需 CUDA 13,昇騰平台需 CANN 9.2。 克隆倉庫:git clone https://github.com/deepseek-ai/DeepInfer 並進入目錄。 創建乾淨環境:新建並激活一個空的 Python 3.12 虛擬環境,避免依賴衝突。 選擇硬件平台並編譯:運行 export DEEPINFER_ACCELERATOR=nvidia(昇騰用 ascend)後執行 ./build.sh 從源碼構建,注意該環境變量需在後續運行環境中保持生效。 準備模型權重:默認首次運行會自動從 Hugging Face 下載 deepseek-ai/DeepSeek-V4.1-Flash-1017,或用 export DEEPINFER_HF_MODEL_DIR=/path/to/DeepSeek-V4.1-Flash-1017 指向本地副本。 運行離線推理示例:執行 python examples/offline_inference.py 啓動推理,更多用法參考倉庫 examples 目錄。
MiniMax M3.1 Flash – MiniMax 推出的新一代 Flash 模型
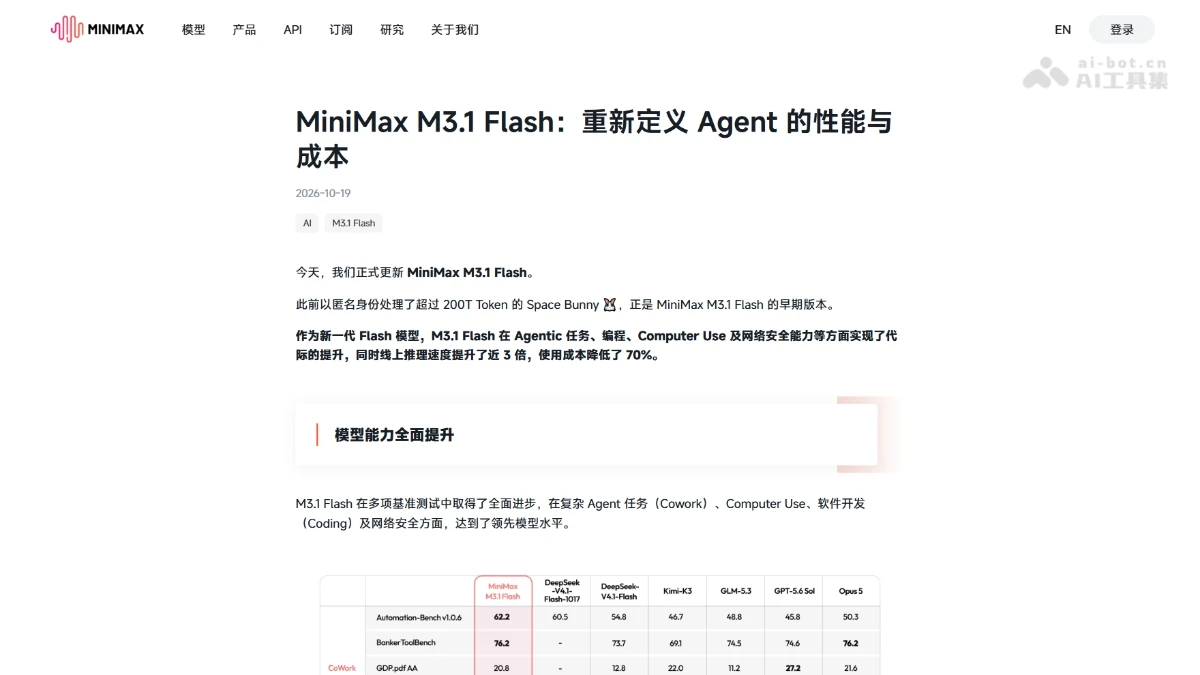
MiniMax M3.1 Flash是什麼 MiniMax M3.1 Flash 是 MiniMax 推出的新一代 Flash 模型,是匿名”Space Bunny“模型,處理超200T Token。MiniMax M3.1 Flash在 Agentic 任務、編程、Computer Use 及網絡安全方面達頂尖水平,DeepSWE 73.7%、OSWorld V2 61.7、CyberGym 82%。MiniMax M3.1 Flash已上線 MiniMax API、MPlan 和 MiniMax Code,權重稍後開源。 MiniMax M3.1 Flash的主要功能 複雜任務與自動化:在 AutomationBench-AA 位居最前列,可跨 SaaS 系統完成銷售、營銷、運營、客服、財務、HR 等企業真實業務流;BankerToolBench 得 76.2 分,擅長多步驟規劃與工具鏈式調用。 編程與軟件工程:DeepSWE v1.1 達 73.7%,能獨立完成代碼理解、功能開發、問題修復與測試驗證的長鏈路開發任務。 Computer Use:OSWorld V2 得 61.7 分、ALE 得 29.6 分,均列國產第一,可從理解任務走向真實電腦操作與交付。 網絡安全:CyberGym 達 82%,覆蓋代碼審計、漏洞修補、滲透測試、惡意代碼分析與逆向工程。 高速推理:日常使用輸出速度達 200+ TPS(P50 穩定 170+ TPS),較前代提升近 3 倍。 MiniMax M3.1 Flash的技術原理 稀疏注意力架構:M3.1 Flash 採用更激進的稀疏注意力設計,通過減少注意力計算中的冗餘交互,在保證模型對長上下文理解能力的同時顯著降低計算開銷,這是其實現 200+ TPS 高速輸出和推理速度近 3 倍提升的核心機制,也使單位 Token 的推理成本大幅下降。 Agentic 長鏈路任務執行:模型針對多步驟規劃與工具調用進行了強化訓練,使其在跨 SaaS 工作流、金融合規、軟件開發等場景中,能夠把複雜任務拆解爲連續可執行的步驟,並在執行過程中保持跨文檔、跨文件的信息一致性,在 AutomationBench、DeepSWE 等考驗真實任務閉環能力的基準上達到頂尖水平。 真實環境交互能力(Computer Use):模型通過與真實操作系統、跨應用環境的交互訓練,獲得感知屏幕、操作軟件、調用工具並驗證結果的閉環能力,使其在 OSWorld V2 和 ALE 這類衡量”實際操作與交付。 微信關注回覆“開源”,加入AI開源項目交流羣 如何使用MiniMax M3.1 Flash API 調用:訪問 MiniMax 開放平台(https://www.minimax.cn/)註冊登錄,獲取 API Key 後按文檔將模型指向 M3.1 Flash 可調用。 訂閱 MPlan:前往 https://www.minimax.cn/m-plan 選擇套餐訂閱,適合以固定預算大量使用模型的用戶。 安裝 MiniMax Code:訪問 MiniMax Code 下載桌面端,安裝後可在編程場景中直接使用 M3.1 Flash。 MiniMax M3.1 Flash的核心優勢 Agentic 能力頂尖:在 AutomationBench-AA、BankerToolBench(76.2 分)等複雜 Agent 任務評測中位居最前列,能獨立完成跨 SaaS 的真實企業業務流。 編程能力對標旗艦:DeepSWE v1.1 達 73.7%,具備長鏈路代碼理解、開發、修復與測試驗證能力,成本遠低於同級模型。 Computer Use 國產第一:OSWorld V2(61.7)與 ALE(29.6)雙榜國產第一。 網絡安全領先:CyberGym 達 82%,低成本覆蓋代碼審計、滲透測試、逆向工程等專業安全場景。 速度快 3 倍:激進稀疏注意力架構帶來 200+ TPS 輸出速度,P50 穩定 170+ TPS,交互體驗大幅升級。 MiniMax M3.1 Flash的項目地址 項目官網:https://www.minimax.cn/blog/minimax-m31f MiniMax M3.1 Flash的同類競品對比 維度 MiniMax M3.1 Flash DeepSeek V4.1 Flash 架構 稀疏注意力(參數未公佈) 552B MoE,輸入激活 8B / 輸出 16B,Encoder-Decoder 輸入價格 1 元/百萬(固定) 閒時 1 元 / 高峯 2 元 輸出價格 4 元/百萬(固定) 閒時 4 元 / 高峯 8 元 緩存命中 0.1 元/百萬 0.02
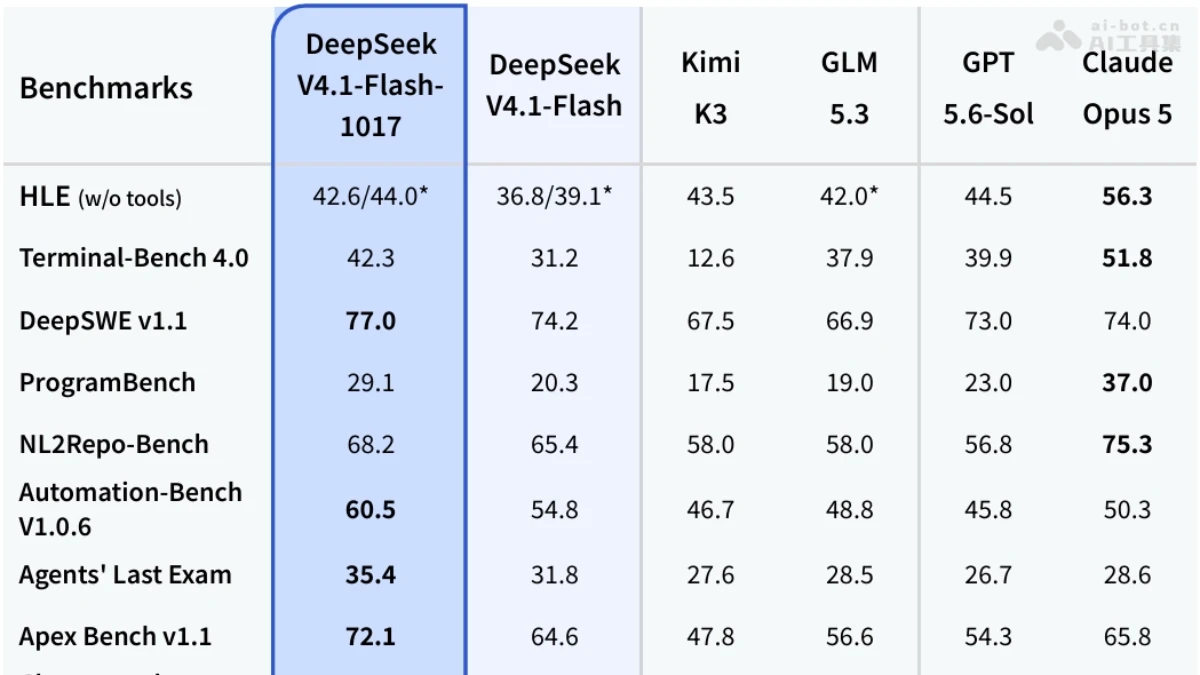
DeepSeek-V4.1-Flash-1017 – DeepSeek推出的最新優化版
DeepSeek-V4.1-Flash-1017是...
GLM-5.3-FlashX – 智譜推出的高速推理模型
GLM-5.3-FlashX是什麼 GLM-5.3-FlashX 是智譜推出的高速推理模型,輸出速度最高 200 tokens/s,較 GLM-5.3-Flash 提速 5 倍、提價 2.5 倍,API 已開放。模型基於 10 萬張國產芯片算力,推理基礎設施由 GLM-5.3 驅動的 Agent 在兩週內自動構建完成,端到端吞吐達初始基線 3 倍。模型主打同尺寸最強智能、極高性價比,形成智能、價格、速度的全面競爭力,適用於對延遲敏感的實時交互與 Agent 高頻調用場景。 GLM-5.3-FlashX的主要功能 高速文本生成:輸出速度最高 200 tokens/s,較 GLM-5.3-Flash 提速 5 倍。 對話補全 API:通過 bigmodel.cn 開放標準 API,Model Key 爲 GLM-5.3-FlashX。 在線體驗:官網體驗中心提供可視化試用入口,無需部署即可測試。 實時 Agent 交互:低延遲特性適配高頻調用、流式輸出的智能體應用場景。 高性價比推理:在保持同尺寸最強智能的同時,以 2.5 倍價格提供 5 倍速度。 GLM-5.3-FlashX的技術原理 國產芯片推理算力底座:模型運行在 10 萬張國產芯片組成的推理集羣上,通過 Infra 側的持續投入與推理優化,保障大規模併發下的高速穩定輸出。 Agent 驅動的 Infra 構建:整套推理系統由 GLM-5.3 驅動的 Agent 自動構建,人類負責定目標、設邊界和審覈關鍵修改,Agent 自主完成測試、日誌分析、Trace 排查與代碼優化,形成「稠密反饋」閉環,不到兩週即實現端到端吞吐 3 倍提升。 精度修復保障長上下文穩定:針對 KDA 的 CP 路徑,修復了 FP32 輸入默認走 TF32 計算導致的誤差累積問題,通過顯式設置 input_precision="tf32x3" 提升長上下文精度,修復已回饋至 Flash Linear Attention 上游。 KV Transfer 併發優化:定位到 DeepEP v1.2.1 的 C++ 調用未釋放 GIL、阻塞 Python 側 Mooncake Transfer 線程的問題,修復後 Prefill 加傳輸與單獨 Prefill 的性能差距從 20% 以上降至 1% 以內。 KDA Decode 算子去冗餘:將沿 V 維度分塊導致的四遍重複 FP32 歸一化與門控計算合併到同一線程塊,批量預計算並共享中間結果,算子性能提升至優化前的 1.71 倍。 如何使用GLM-5.3-FlashX 註冊賬號:API調用網址 https://docs.bigmodel.cn/api-reference/,註冊並登錄賬號。 獲取 API Key:在控制檯創建並複製你的 API 密鑰。 確認模型名稱:調用時使用 Model Key GLM-5.3-FlashX。 API 調用:參考官方文檔(對話補全接口),將請求中的 model 字段設爲 GLM-5.3-FlashX 併發送請求。 在線體驗(可選):訪問體驗中心 https://www.bigmodel.cn/trialcenter/modeltrial/visual?modelCode=glm-5.3-flashx,免部署直接試用。 接入應用:將 API 集成到你的應用或 Agent 工作流中,利用其 200 tokens/s 的高速輸出處理實時交互場景。 GLM-5.3-FlashX的核心優勢 極致速度:輸出速度最高 200 tokens/s,較 GLM-5.3-Flash 提速 5 倍。 智能不妥協:長期保持同尺寸最強智能水平,提速不以犧牲模型能力爲代價。 高性價比:以 2.5 倍價格換取 5 倍速度,單位智能成本反而更低。 國產算力底座:基於 10 萬張國產芯片推理集羣,供應鏈自主可控。 Agent 構建的 Infra:推理系統由 GLM-5.3 驅動的 Agent 不到兩週自動建成,端到端吞吐達基線 3 倍,迭代效率遠超傳統人工優化。 工程深度優化:通過修復 TF32 精度偏差、GIL 阻塞、重複計算等問題,實現算子級性能躍升(KDA Decode 算子提升 1.71 倍)。 GLM-5.3-FlashX的同類競品對比 維度 GLM-5.3-FlashX DeepSeek-V4-Flash 輸出速度 200 tokens/s(顯式標稱,主打賣點) 官方未標稱具體數值,實測爲高吞吐檔 價格 Flash 的 2.5 倍(絕對價未公佈,按 GLM-5 系定價推算居中檔) $0.14 / $0.28 每百萬 tokens(約 ¥1 / ¥2),爲 Flash 檔價格屠
DeepSeek V4.1 Flash – DeepSeek推出的中間內測版本模型
DeepSeek V4.1 Flash是什麼 D...
Cocode – 開源DeepSeek Harness發行版,提供GUI與TUI雙入口
Cocode是什麼 Cocode 是 Deep...
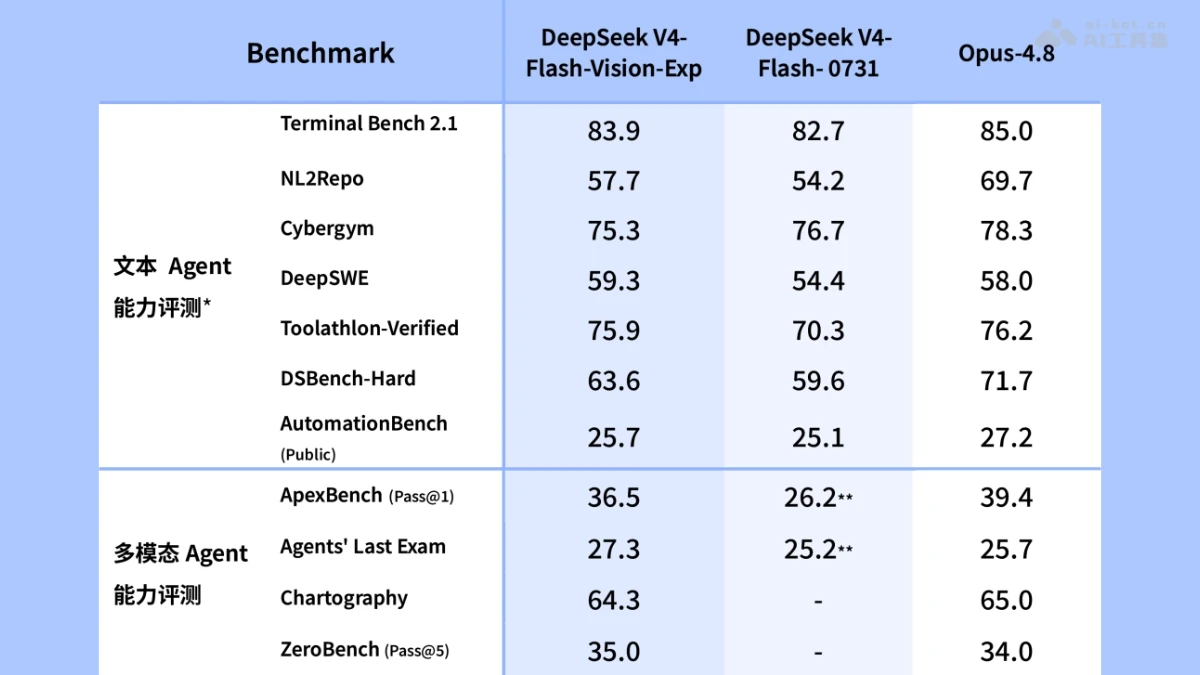
DeepSeek-V4-Flash-Vision-Exp – DeepSeek 推出的多模態視覺理解模型
DeepSeek-V4-Flash-Vision-Ex...
DeepSeek V4 Pro 與 GLM-5.3 深度實測,誰是國產大模型一哥?
今天發點新模型對抗測評相關...
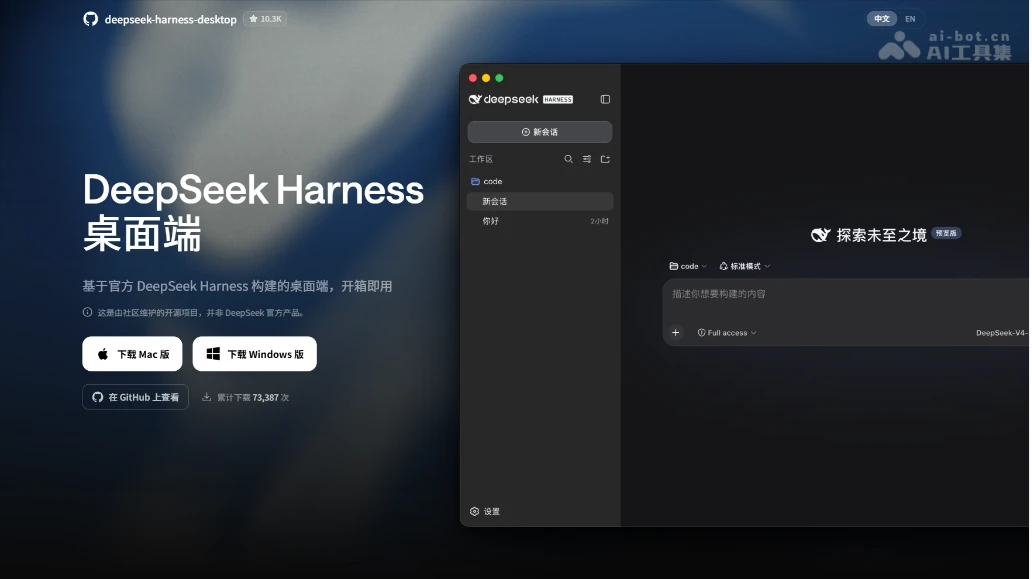
DeepSeek Harness Desktop – 開源的 DeepSeek Harness 桌面端
DeepSeek Harness Desktop是...
DeepSeek Harness 保姆級教程,附4種使用途徑和必裝插件
今天發點 DeepSeek Harness ...
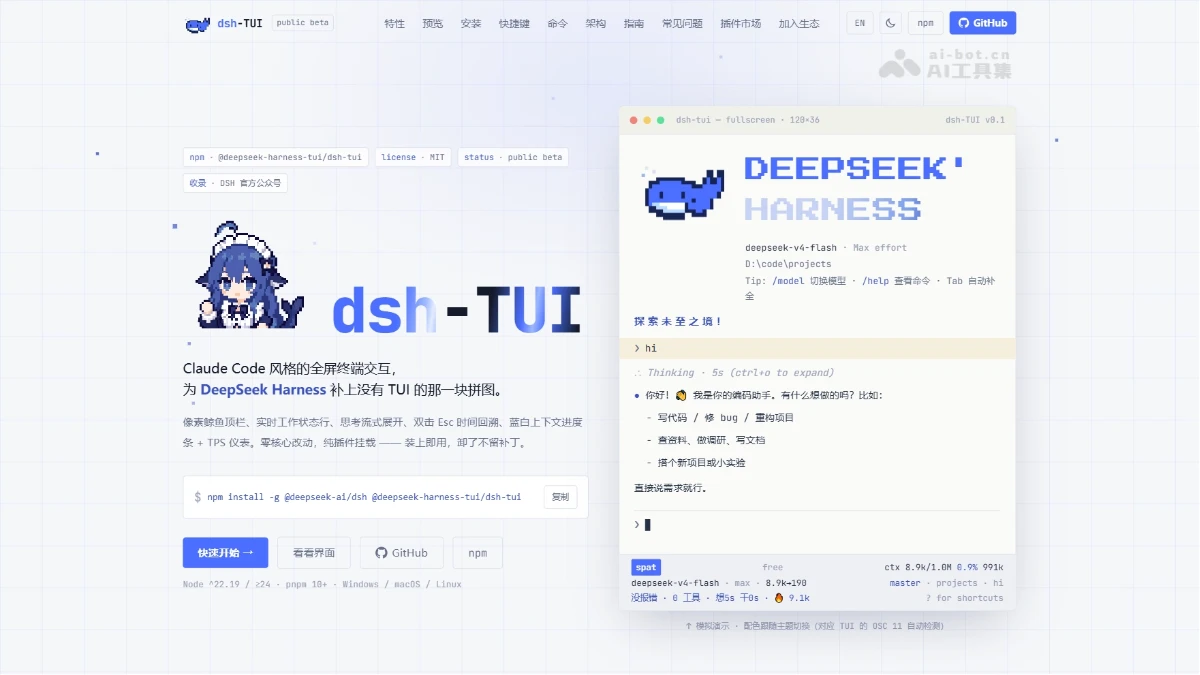
dsh-TUI – 開源的 DeepSeek Harness 終端界面插件
dsh-TUI是什麼 dsh-TUI 是 De...
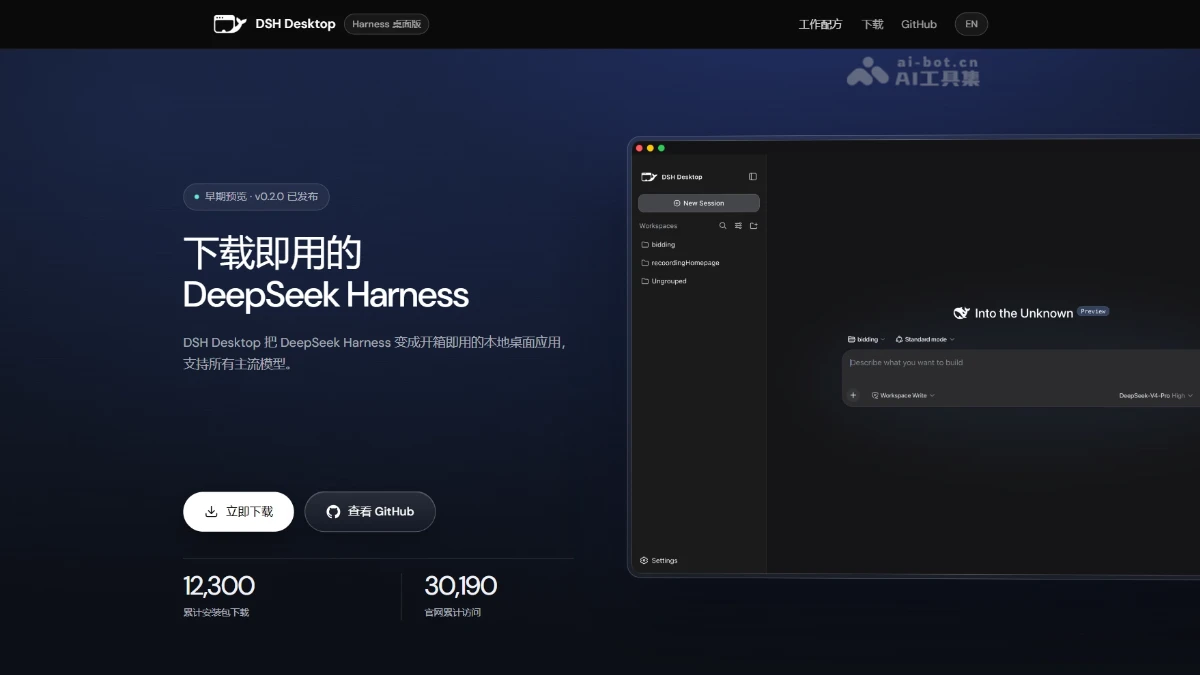
DSH Desktop – 開源的 DeepSeek Harness 本地桌面應用
DSH Desktop是什麼 DSH Deskt...
DeepSeek Harness 安裝教程,全新Agent模式一文看懂
DeepSeek V4 Pro 剛發完,自...
DeepSeek Harness – DeepSeek 推出的 AI 智能體運行框架
DeepSeek Harness是什麼 Deep...
騰訊混元 Hy3 實測 – 與 GLM 5.1、DeepSeek V4 Pro 橫向對比
最近騰訊的混元 Hy3出了,Wor...
Reasonix – 專爲 DeepSeek 推出的開源終端編程 Agent
Reasonix是什麼 Reasonix 是...
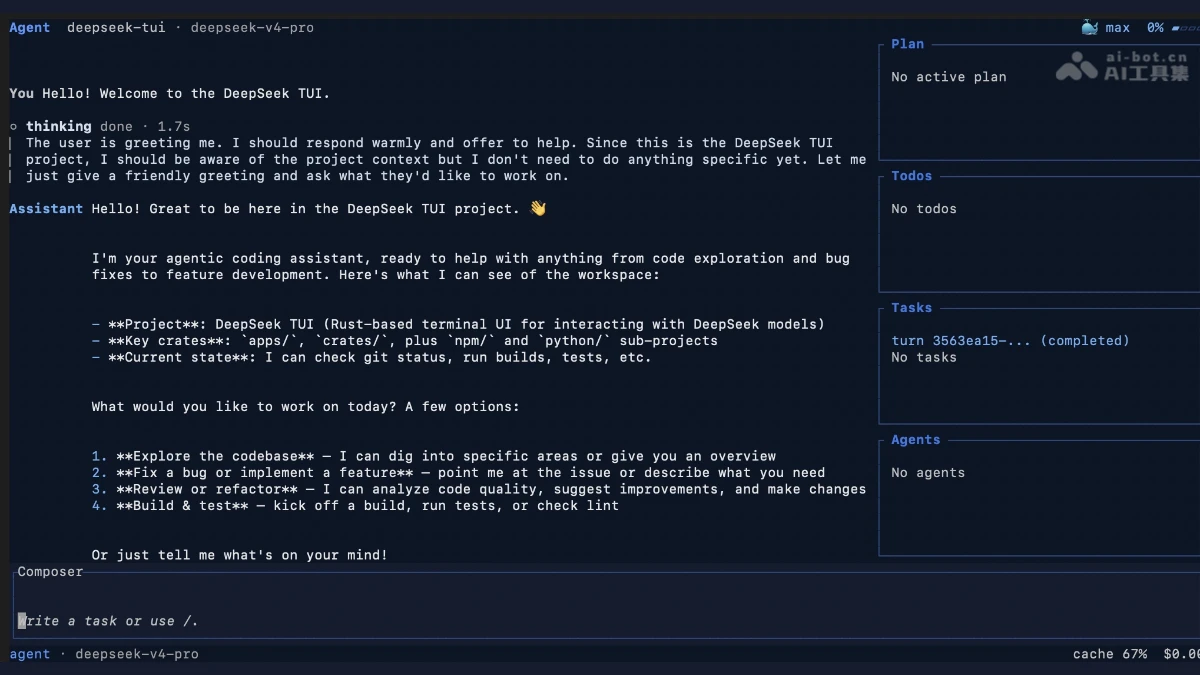
DeepSeek-TUI – 開源終端編程智能體,適配DeepSeek V4
DeepSeek-TUI是什麼 DeepSeek...
國產大模型Vibe Coding橫評:DeepSeek V4和GLM-5.1實測對比
DeepSeek V4 系列模型預覽版...
DeepSeek-V4 – DeepSeek推出的新一代大語言模型系列
DeepSeek-V4是什麼 DeepSeek-...