最好用的AI工具
搜尋:圖像
153 個結果
GenEvolve – 美團等推出的自演進圖像生成 Agent
GenEvolve是什麼 GenEvolve ...
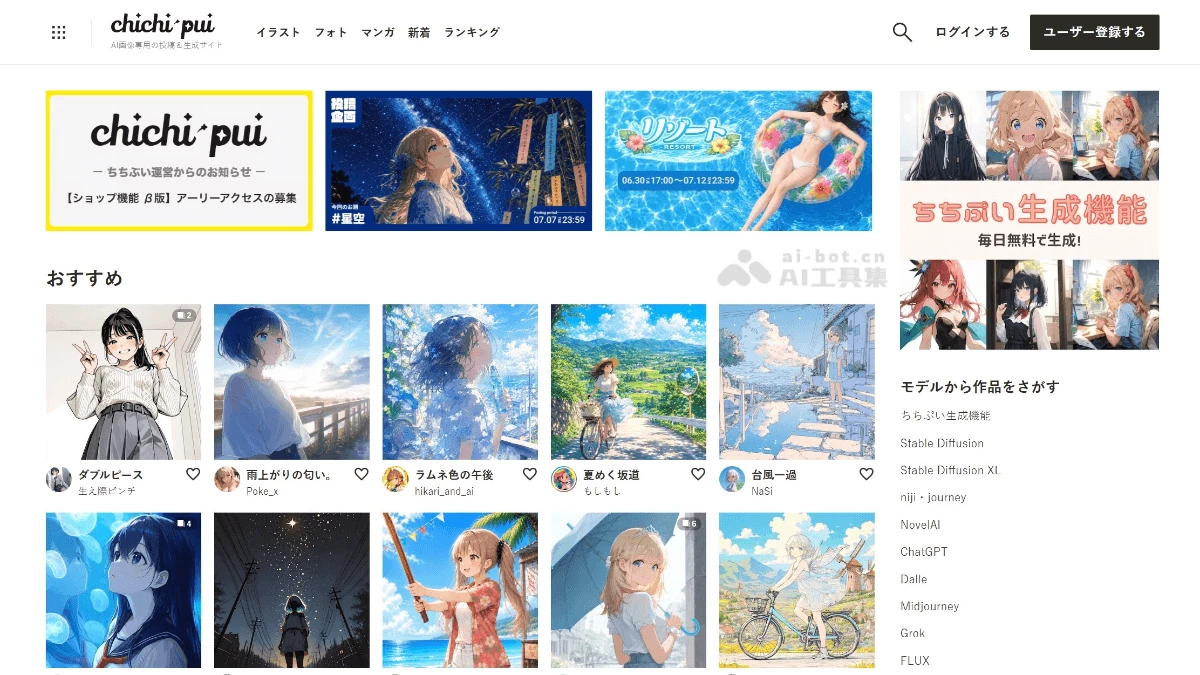
Chichi-pui – AI圖像生成與分享平台,專注日系風格
Chichi-pui是什麼 Chichi-pui...
EvoQuality – 字節跳動開源的圖像質量評估模型
EvoQuality是什麼 EvoQuality...
Agnes AI 免費 API 實測 – 文本/圖像/視頻模型全免費開放
前兩天凌晨,我刷到一條消息...
HiDream-O1-Image-1.5 – 智象未來推出的商用圖像生成模型
HiDream-O1-Image-1.5是什麼 ...
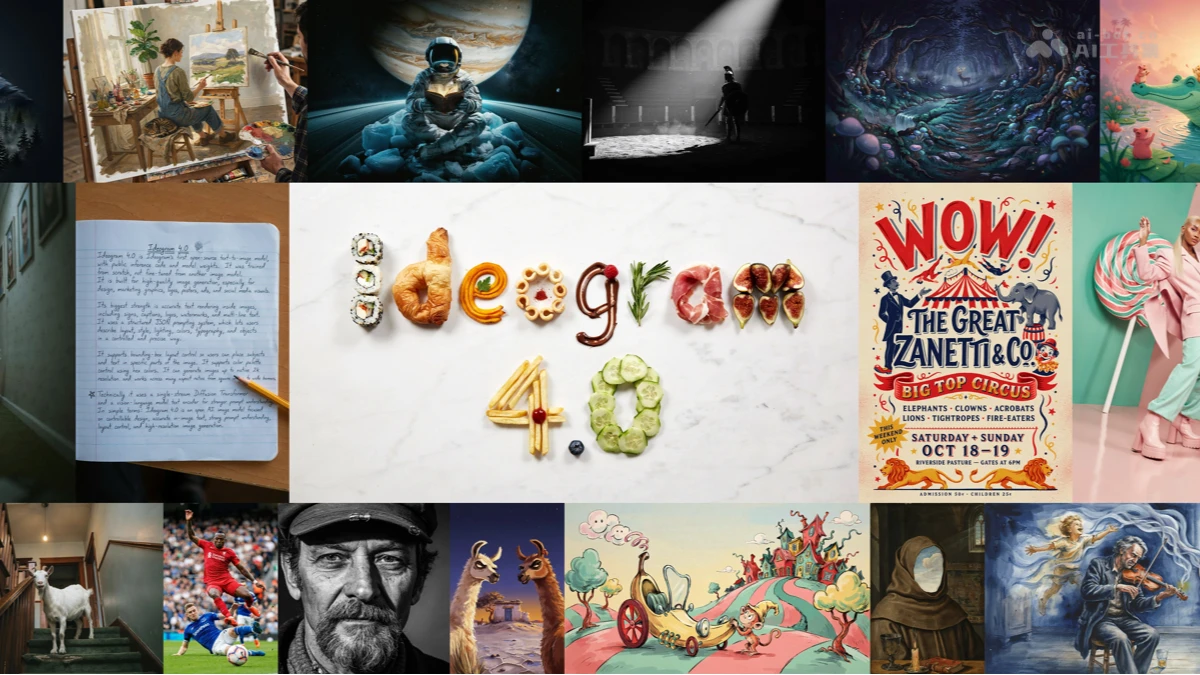
Ideogram 4 – Ideogram 開源的文本到圖像生成模型
Ideogram 4是什麼 Ideogram 4...
Uni-1.1 – Luma AI 推出的新一代圖像生成模型
Uni-1.1是什麼 Uni-1.1是Luma...
Step Image Edit 2 – 階躍星辰推出的圖像生成編輯模型
Step Image Edit 2是什麼 Ste...
GPT-image-2 – OpenAI推出的下一代原生圖像生成模型
GPT-image-2是什麼 GPT-image...
JoyAI-Image-Edit – 京東開源的指令引導圖像編輯模型
JoyAI-Image-Edit是什麼 JoyA...
Wan2.7-Image – 阿里通義推出的 AI 圖像生成與編輯模型
Wan2.7-Image是什麼 Wan2.7-I...
Uni-1 – Luma AI推出的統一圖像理解與生成模型
Uni-1是什麼 Uni-1 是 Luma A...

InstanceAssemble – 小紅書聯合復旦推出的圖像生成框架
InstanceAssemble是什麼 Inst...

T5Gemma 2 – 谷歌開源的長上下文編碼器-解碼器模型
T5Gemma 2是什麼 T5Gemma 2 是谷歌開源的新型端側多模態長上下文編碼器 – 解碼器模型。模型迴歸優化了經典 Transformer 架構,引入綁定詞嵌入和合併注意力機制等創新,參數規模有 270M – 270M、1B – 1B 和 4B – 4B 等多種版本。模型在多模態性能、長上下文處理以及通用能力上均優於對應規模的 Gemma 3,支持超 140 種語言,適用手機等設備的快速實驗與部署,爲端側 AI 應用開闢了新道路。 T5Gemma 2的主要功能 多模態理解與生成 :同時處理文本和圖像信息,可執行視覺問答、多模態推理等任務,比如根據圖像內容回答相關問題,將圖像信息與文本描述相結合進行生成。 長上下文處理 :具備強大的長上下文能力,能處理長達 128K 個標記的上下文窗口,適合需要長文本理解和生成的場景,如長篇文檔的總結、長故事的續寫等。 編碼 – 解碼功能 :作爲編碼器 – 解碼器模型,將輸入的文本或圖像編碼成向量,通過解碼器生成目標文本,用於翻譯、文本改寫、摘要生成等多種自然語言處理任務。 多語言支持 :支持超過 140 種語言,滿足不同語言環境下的應用需求,實現跨語言的文本處理和生成。 端側高效部署 :模型參數緊湊,適合在手機、瀏覽器等端側設備上快速部署和運行,爲端側應用提供強大的 AI 能力支持。 T5Gemma 2的技術原理 編碼器 – 解碼器架構:T5Gemma 2 採用經典的編碼器 – 解碼器架構,編碼器負責處理輸入(如文本或圖像),生成語義向量;解碼器基於向量生成目標輸出(如文本描述)。 多模態能力:T5Gemma 2 集成一個高效的視覺編碼器(如 SigLIP),將圖像轉換爲 256 個嵌入向量,向量被輸入到編碼器中進行視覺理解。通過將視覺特徵和文本特徵融合,模型能同時處理文本和圖像信息,支持多模態任務,如視覺問答(VQA)和圖像描述生成。 長上下文處理:T5Gemma 2 採用交替局部和全局注意力機制,能處理長達 128K 的上下文窗口,顯著提升長上下文任務的性能。通過調整位置編碼的頻率,模型在處理長序列時能更好地捕捉局部和全局信息。 模型適配技術:T5Gemma 2 的參數初始化來自預訓練的純解碼器模型(如 Gemma 3),通過 UL2 預訓練目標進行適配,繼承預訓練模型的語言理解能力。這種適配策略不僅適用於文本任務,還擴展到了多模態和長上下文任務,證明了其通用性和高效性。 效率優化:T5Gemma 2 將編碼器和解碼器的詞嵌入層綁定在一起,共享參數,顯著減少模型的總參數量,提高模型的效率。將解碼器中的自注意力和交叉注意力合併爲一個統一的模塊,減少模型參數和架構複雜性,同時提高推理效率。 T5Gemma 2的項目地址 項目官網:https://blog.google/technology/developers/t5gemma-2/ HuggingFace模型庫:https://huggingface.co/collections/google/t5gemma-2 arXiv技術論文:https://arxiv.org/pdf/2512.14856 T5Gemma 2的應用場景 視覺問答:通過結合圖像和文本信息,爲用戶提供準確的視覺問答服務,適用於教育、智能客服等領域。 圖像描述生成:自動生成圖像描述文本,幫助用戶快速理解圖像內容,可用於社交媒體和輔助視障人士。 多模態推理:結合圖像和文本進行推理,判斷場景是否符合描述,應用於智能安防和自動駕駛等領域。 跨語言翻譯:將一種語言的文本翻譯成另一種語言,廣泛應用於在線翻譯服務和國際商務溝通。 手機語音助手:在手機上運行,提供語音交互功能,支持語音搜索和指令執行。
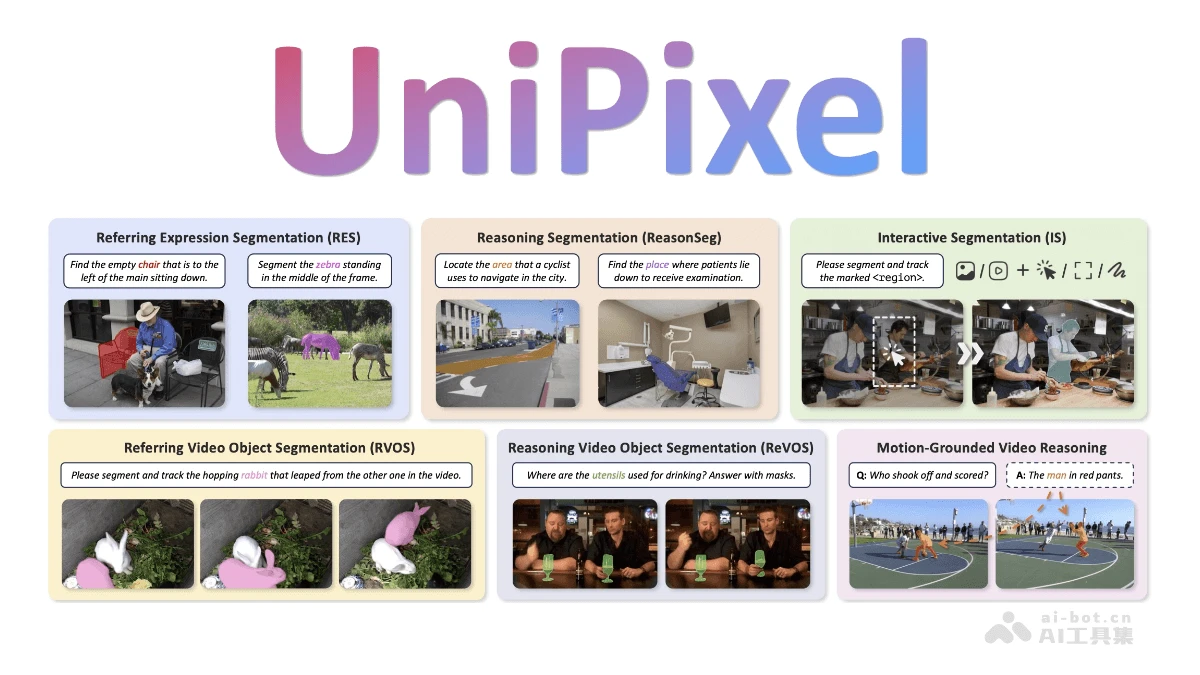
UniPixel – 香港理工聯合騰訊推出的像素級多模態大模型
UniPixel是什麼 UniPixel是香港理工大學和騰訊ARC Lab團隊開發的首個統一像素級多模態大模型,專注於圖像/視頻的精細理解與交互。能在單個模型中完成對象指代、像素級分割和區域推理三大任務,通過創新設計的”對象記憶機制”和統一視覺編碼方式,實現了對視頻中目標的精準追蹤與語義理解。模型基於Qwen2.5-VL框架,支持點、框、掩碼三種交互方式,在9項視覺任務基準測試中超越72B參數的傳統模型,開源了代碼和在線Demo。核心突破在於將視覺分割與語言推理深度融合,解決了傳統模型無法處理複雜指代和動態區域理解的問題。 UniPixel的主要功能 像素級視覺語言理解:專注於像素級視覺語言理解,能實現視覺信號與語言語義之間的像素級對齊,支持多種細粒度任務,包括圖像/視頻分割、區域理解以及PixelQA任務。 統一對象指代與分割:模型將對象指代和分割能力無縫集成,能根據視覺提示輸入生成相關的掩碼,並在推理過程中基於這些中間指針進行後續推理,實現細粒度的像素級推理。 多任務支持:在多個基準測試中表現出色,包括ReVOS推理分割基準、MeViS、Ref-YouTube-VOS、RefCOCO/+/g等數據集,設計了新的PixelQA任務,要求模型聯合進行對象指代、分割和問答。 靈活的視覺提示處理:能靈活處理視覺提示輸入,生成掩碼並進行推理,支持單幀和多幀的視頻區域理解,以及基於掩碼的問答任務。 UniPixel的技術原理 統一框架設計:UniPixel採用統一框架,將對象指代和分割能力整合到一個模型中,實現從粗粒度場景理解到細粒度像素推理的跨越,爲複雜視覺推理提供基礎。 對象記憶庫:模型包含對象記憶庫,存儲從指代任務中提取的對象特徵,爲後續的分割和推理任務提供上下文信息,增強模型在像素級任務上的性能。 多階段訓練策略:採用預訓練、指代任務微調和分割任務微調的多階段訓練策略,逐步提升模型在像素級任務上的性能,適應不同任務需求。 端到端掩碼生成:模型能根據語言描述直接生成像素級掩碼,實現語言與視覺的深度融合,支持多種細粒度任務,如圖像/視頻分割和區域理解。 靈活的視覺提示處理:能靈活處理視覺提示輸入,生成掩碼並進行推理,支持單幀和多幀的視頻區域理解,以及基於掩碼的問答任務,適應不同場景需求。 強大的推理能力:在VideoRefer-Bench-Q問答任務中,UniPixel-7B模型取得了74.1%的準確率,超越了包括GPT-4o在內的多個強大基準模型,顯示出其在複雜視覺推理任務中的強大能力。 模型權重與數據集提供:提供了UniPixel-3B和UniPixel-7B兩個版本的模型權重,以及23個指代/分割/QA數據集的原始圖像/視頻和預處理註釋,爲研究和應用提供豐富資源。 訓練與評估支持:代碼庫支持在23個數據集和基準測試上進行訓練和評估,支持靈活的硬件設置、高效的訓練技術、自定義基礎LLM和對話模板,以及通過Tensorboard/Wandb監控訓練過程,方便用戶使用和優化。 UniPixel的項目地址 項目官網:https://polyu-chenlab.github.io/unipixel/ Github倉庫:https://github.com/PolyU-ChenLab/UniPixel HuggingFace數據:https://huggingface.co/datasets/PolyU-ChenLab/UniPixel-SFT-1M arXiv技術論文:https://arxiv.org/pdf/2509.18094 在線體驗Demo:https://huggingface.co/spaces/PolyU-ChenLab/UniPixel UniPixel的應用場景 圖像分割:UniPixel能根據語言描述生成圖像中特定對象的像素級掩碼,適用於需要精確圖像分割的場景,如醫學圖像分析、自動駕駛中的目標分割等。 視頻分割:在視頻處理領域,UniPixel可以對視頻中的對象進行實時分割,支持視頻編輯、視頻監控和增強現實等應用。 區域理解:通過理解語言描述來識別和分割視頻中的特定區域,可用於視頻內容分析、智能監控系統和視頻會議中的背景分割等。 問答任務:UniPixel支持PixelQA任務,能夠根據語言描述和視覺信息回答問題,適用於教育、智能客服和信息檢索等場景。 多模態交互:在需要結合視覺和語言信息進行交互的場景中,如智能助手、虛擬現實和遊戲開發等,UniPixel能夠提供更自然和準確的交互體驗。 智能監控:在安防監控領域,UniPixel可以實時識別和分割監控視頻中的特定對象或區域,提高監控系統的智能化水平。
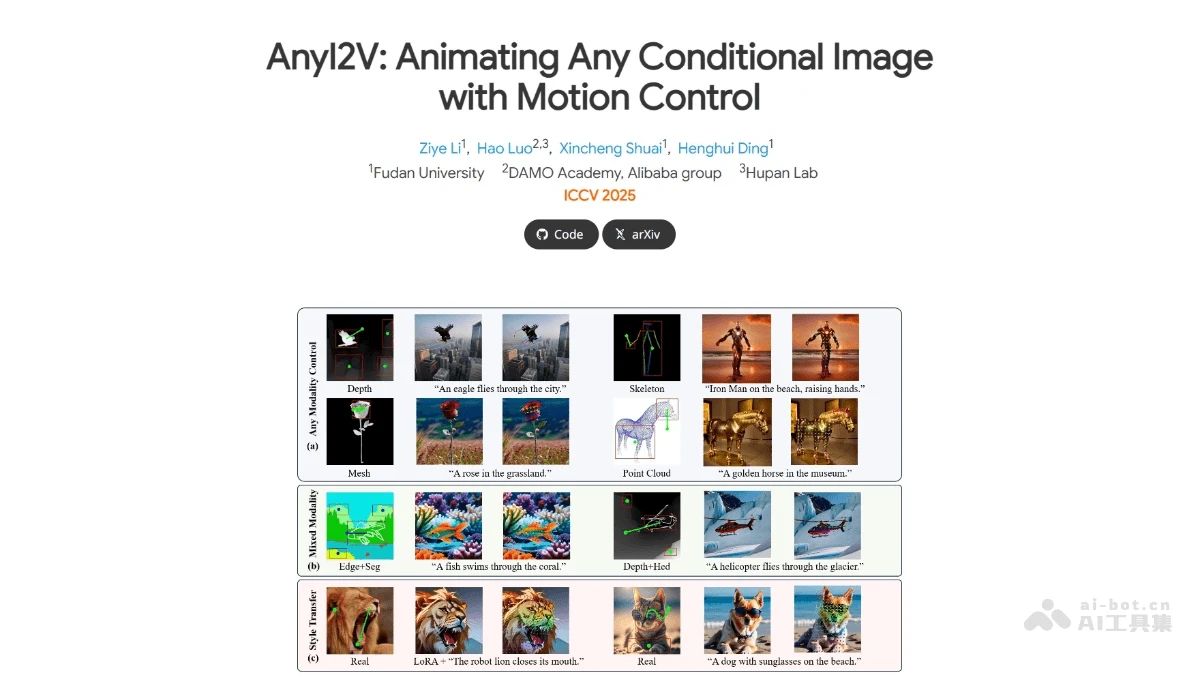
AnyI2V – 復旦聯合阿里達摩院等推出的圖像動畫生成框架
AnyI2V是什麼 AnyI2V 是復旦...
ChatPs – AI Photoshop 插件,通過聊天方式進行圖像編輯
ChatPs是什麼 ChatPs 是創新...
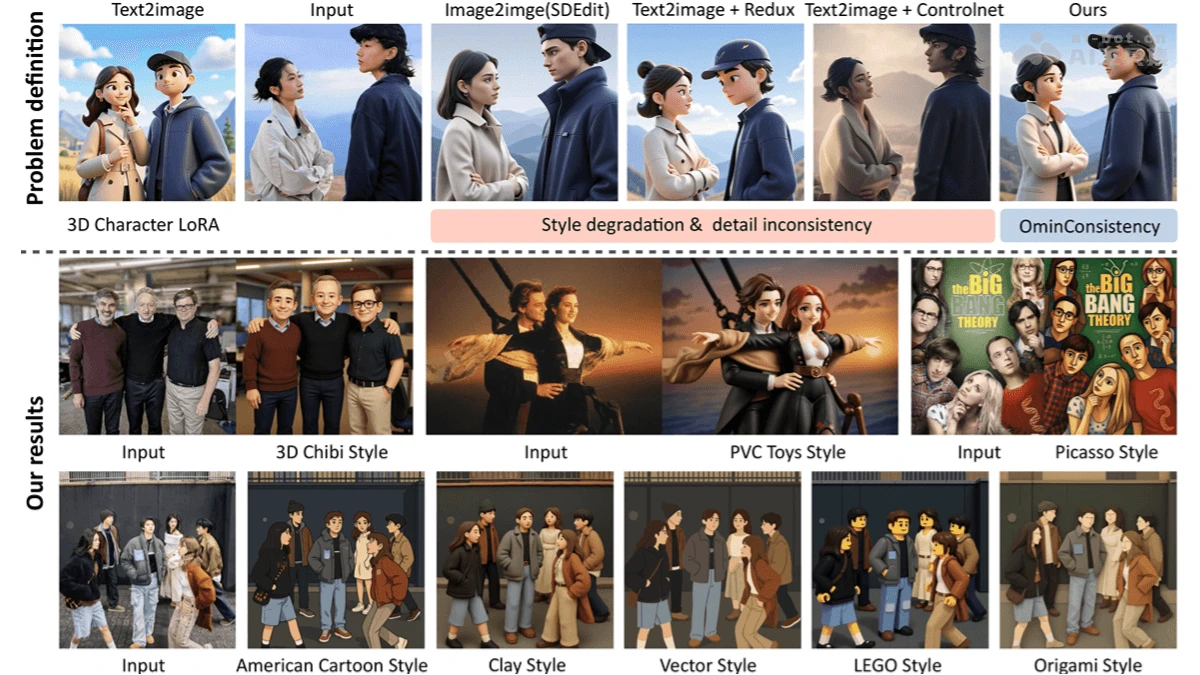
OmniConsistency – 新加坡國立大學推出的圖像風格遷移模型
OmniConsistency是什麼 OmniC...
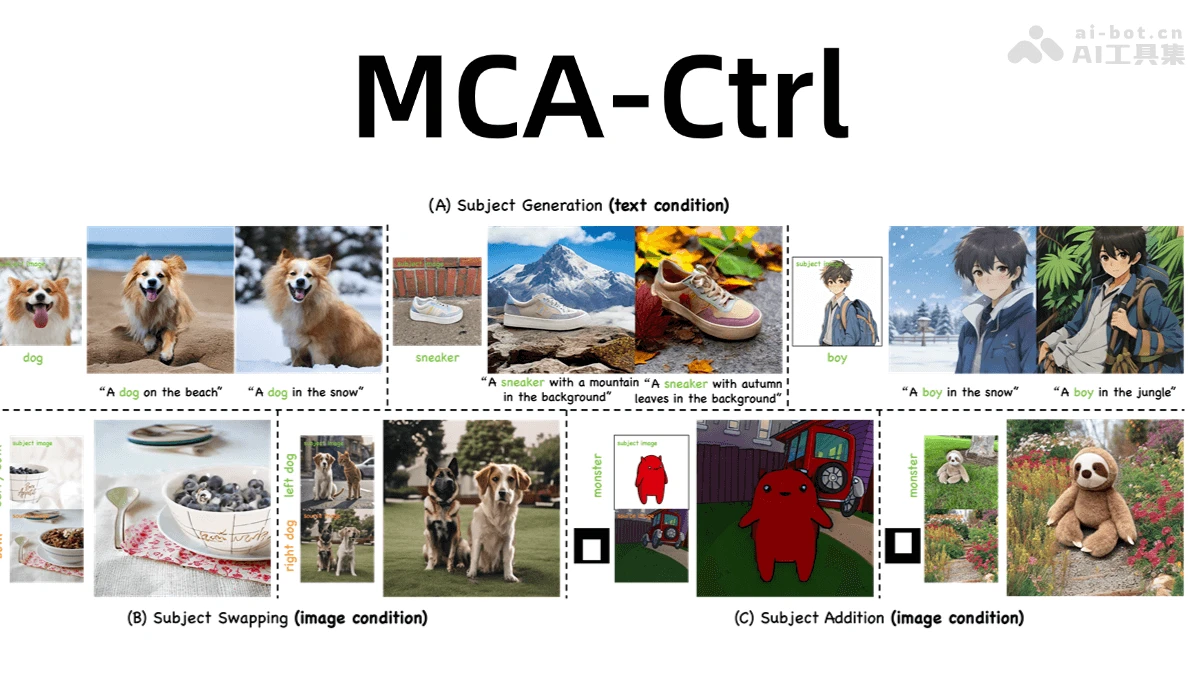
MCA-Ctrl – 中科院和中科大推出的圖像定製生成框架
MCA-Ctrl是什麼 MCA-Ctrl(Multi-party Collaborative Attention Control)是中科院計算所和中國科學院大學的推出的圖像定製生成框架,基於文本和複雜視覺條件實現高質量的圖像生成。MCA-Ctrl引入兩種注意力控制策略,Self-Attention Global Injection(SAGI)和Self-Attention Local Query(SALQ),及一個主體定位模塊(SLM),解決背景不一致、主體混淆等問題。MCA-Ctrl在零樣本圖像定製方面優於現有方法,能有效保持主體特徵和條件信息的一致性。 MCA-Ctrl的主要功能 高質量圖像定製:在文本或圖像條件下生成高質量的定製圖像,保持與條件輸入的語義一致性。 主體特徵保持:在複雜的視覺場景中,準確捕捉特定主體的外觀和內容,同時避免主體泄漏和混淆問題。 背景一致性:在圖像條件生成中,保持背景的一致性。 零樣本生成:支持直接在零樣本條件下生成高質量的圖像。 多種任務支持:支持多種圖像定製任務,包括主體生成、主體替換和主體添加等。 MCA-Ctrl的技術原理 多主體協同擴散過程:基於三個並行的擴散過程,主體擴散過程(Bsub)、條件擴散過程(Bcon)和目標擴散過程(Btgt)。主體擴散過程負責處理主體圖像,條件擴散過程處理條件圖像或文本,目標擴散過程生成最終的定製圖像。 自注意力層操作:Self-Attention Global Injection(SAGI)將主體和條件圖像的全局自注意力特徵注入到目標擴散過程中,增強目標圖像的細節真實性和內容一致性。SAGI操作有助於糾正由局部查詢引起的特徵混淆。目標擴散過程基於查詢主體和條件圖像的局部特徵,獲取主體的外觀和背景內容。SALQ操作確保生成的圖像在主體和背景上與條件圖像保持高度一致性。 主體定位模塊(SLM):爲在複雜視覺場景中準確識別和定位主體,引入主體定位模塊。SLM結合目標檢測模型(如DINO)和分割模型(如SAM),處理多模態指令,輸出精確的主體圖像層和可編輯圖像層,減少特徵混淆和僞影。 無調優框架:MCA-Ctrl不需要對每個主體進行單獨的微調訓練,基於注意力控制策略和主體定位模塊,在零樣本條件下實現高質量的圖像定製。 MCA-Ctrl的項目地址 GitHub倉庫:https://github.com/yanghan-yh/MCA-Ctrl arXiv技術論文:https://arxiv.org/pdf/2505.01428 MCA-Ctrl的應用場景 數字內容創作:快速生成遊戲、動畫中的角色和場景。 廣告與營銷:製作個性化廣告圖像和品牌推廣素材。 娛樂與社交媒體:生成個性化頭像、圖片和社交媒體內容。 教育與培訓:輔助教學材料製作,創建虛擬實驗室場景。 藝術與設計:提供藝術創作靈感,輔助室內設計預覽。
Ghiblio.art – 免費AI圖像生成平台,支持文字和圖片轉化爲吉卜力風格
Ghiblio.art是什麼 Ghiblio.a...