最好用的AI工具
搜尋:圖像生成
60 個結果
DMAD – 字節聯合德州農工開源的擴散模型少步蒸餾技術
DMAD是什麼 DMAD(Distribution Matching as Adversarial Distillation)是字節跳動與德州農工大學聯合開源的少步蒸餾框架,用於加速擴散模型生成。DMAD訓練二分類判別器直接學習目標分佈與學生分佈的差異,省去輔助擴散模型,將50步教師模型蒸餾爲4步學生模型。已支持ImageNet、SDXL、Wan2.1及MiniMax-H3-33B,8GB顯存可生成約5秒1344×768有聲視頻。 DMAD的主要功能 少步圖像生成:將 ImageNet-64 的 EDM 模型蒸餾至 1 步採樣,FID 低至 1.04,SDXL 僅需 4 步可文生圖。 少步文生視頻:把 Wan2.1-T2V-14B 蒸餾爲 4 步學生模型,VBench 達 85.15。 聯合音視頻生成:將 MiniMax-H3-33B 的 50 步教師模型蒸餾爲 4 步,輸出 1344×768 視頻與 32kHz 原生立體聲音頻。 消費級硬件支持:提供 8GB 顯存 ComfyUI 工作流與低顯存命令行推理,8GB 顯卡可生成約 5 秒、12GB 約 15 秒有聲視頻。 訓練與推理全開源:發佈蒸餾方法、訓練代碼、推理腳本及多模型 LoRA 權重,覆蓋命令行與 ComfyUI 兩種使用方式。 DMAD的技術原理 分佈匹配即對抗蒸餾:DMAD 爲訓練二分類判別器區分目標樣本與學生樣本,最優判別器的 logit 等於兩分佈的對數密度比,對其輸入求梯度即得 score 差,直接給出學生的修正方向,省掉輔助 score 擬合模型。 共享骨幹、雙頭判別器:判別器採用單一共享特徵骨幹、兩個判別頭,教師頭區分教師樣本與學生樣本,真實數據頭區分真實樣本與學生樣本,均用二元交叉熵訓練;學生用兩個 logit 的加權線性損失更新,更新時凍結判別器參數但保留梯度回傳。 噪聲區間動態加權:教師樣本與真實數據的分佈差異隨噪聲水平變化,DMAD 用真實數據頭在兩類樣本上的平均 logit 差作爲經驗信號,以 0.99 衰減的指數移動平均追蹤各噪聲區間,差距小的區間獲得更高教師權重,歸一化後參與學生損失。 離線教師樣本加速訓練:教師只提供預生成並緩存的樣本,訓練時無需在線調用教師。4 卡 H200、MiniMax-H3 rank-128 LoRA 配置下,每次學生更新及關聯判別器更新耗時從 818.1 秒降至 233.3 秒,實現約 3.51 倍訓練加速。 微信關注回覆“開源”,加入AI開源項目交流羣 如何使用DMAD 克隆倉庫:git clone https://github.com/Yzmblog/DMAD.git 並進入項目目錄。 創建環境:用 conda 創建 Python 3.12 環境並激活。 安裝依賴:按官方固定版本安裝 PyTorch 2.11.0(cu126)、torchvision、torchaudio,再執行 pip install -r requirements.txt 和 pip install -U modelscope-hub。 準備硬件:確保有支持 CUDA 的 NVIDIA 顯卡,並預留約 64GB 系統內存與 170GB 磁盤空間。 下載基礎模型:通過 modelscope download MiniMax/MiniMax-H3 下載 MiniMax-H3 基礎模型。 下載蒸餾權重:從魔搭下載 DMAD 的 4 步 LoRA。 命令行推理:運行 inference.py,指定模型路徑、LoRA、提示詞文件、--steps 4、--height 768 --width 1344,按顯存選擇 --low-vram 8或 --low-vram 12。 查看輸出:輸出目錄包含 0000.mp4、提示詞 txt 和 settings.json,跑通後可替換爲自己的提示詞文件。 DMAD的核心優勢 推理大幅提速:將 50 步教師模型蒸餾爲 4 步學生模型,去噪迭代減少 92% 以上,同時保持接近教師的生成質量。 訓練效率更高:判別器直接學習分佈差異,省去輔助擴散模型,4 卡 H200 上訓練更新加速約 3.51 倍。 生成質量領先:ImageNet-64 一步生成 FID 達 1.04,優於 DMD2、SiDA 等方法;人類評估中對 DMD2 總體偏好率 79.1%、對 rCM 達 84.6%。 覆蓋多模態全場景:同一框架統一支持圖像、文生視頻和聯合音視頻生成。 DMAD的項目地址 項目官網:https://yzmblog.github.io/projects/DMAD/ GitHub倉庫:https://github.com/Yzmblog/DMAD Huggin
Surface Laptop Ultra – 微軟聯合英偉達推出的最強 AI PC
Surface Laptop Ultra是什麼 Surface Laptop Ultra是微軟推出最強Surface PC,搭載英偉達RTX Spark N1X超級芯片,最高20核CPU+6144核GPU+128GB統一內存,本地AI算力達1PFLOPS,可運行超1200億參數大模型。Surface Laptop Ultra採用15英寸PixelSense Ultra觸控屏、磁吸式USB-C充電,續航一整天,專爲AI開發、創意工作與智能體場景打造。 Surface Laptop Ultra的主要功能 本地跑大模型:1PFLOPS算力+128GB統一內存,本地運行超1200億參數模型。 AI編程:本地跑MAI-Code-1.1-Flash,Copilot智能編排本地與雲端任務。 智能體運行:配合MXC沙箱安全運行OpenClaw、Codex等智能體。 視頻創作:支持電影級視頻編輯,AI視頻生成比M5 Pro快6.2倍。 遊戲:光線追蹤+DLSS,《戰爭機器》穩定60幀。 屏幕:15英寸觸控屏,HDR亮度比MacBook Pro M5高25%。 磁吸充電:全球首款內置磁吸式USB-C接口。 擴展性:3個USB-C+HDMI等接口,可驅動3台4K顯示器,存儲可拆卸升級。 續航散熱:散熱提升2.5倍,續航滿足一整天。 Surface Laptop Ultra的規格參數 芯片:英偉達RTX Spark N1X超級芯片,Grace CPU + Blackwell RTX GPU,互聯速度600GB/s CPU:最高20核,入門版爲18核 GPU:最高6144核,入門版爲5120核 AI算力:1 PFLOPS FP4,可本地運行超1200億參數模型 內存:24GB家庭版或32GB~128GB專業版LPDDR5x統一內存 存儲:512GB~1TB固態硬盤,支持用戶自行拆卸、升級和更換 屏幕:15英寸PixelSense Ultra觸控屏,HDR峯值亮度比MacBook Pro M5高25% 機身:厚度不足18mm,重量不足4.5磅 散熱:全新散熱架構,散熱能力爲現有Surface筆記本的2.5倍 電池:續航滿足一整天使用 接口:3個USB-C,含全球首款內置磁吸式充電接口Magnetic Connect),、HDMI、USB-A、SD卡讀卡器、3.5mm耳機插孔,可驅動最多3台4K顯示器 操控:觸控板面積增大30%,配備先進觸覺反饋技術 系統:Windows 11家庭版/專業版 遊戲技術:英偉達光線追蹤、DLSS、Reflex Surface Laptop Ultra的價格配置 入門版2599美元,約17425元,18核CPU+5120核GPU+24GB+512GB 頂配5899.99美元,約39557元,20核CPU+6144核GPU+128GB+1TB Surface Laptop Ultra的購買地址 官方購買地址:https://www.microsoft.com/en-us/store/configure/surface-laptop-ultra/8wg5vqp0x4b8 Surface Laptop Ultra的應用場景 本地AI開發:依託1PFLOPS算力和128GB統一內存,開發者可在本地運行1200億參數大模型及MAI-Code-1.1-Flash,無需聯網即可完成代碼生成與調試。 企業智能體辦公:通過MXC安全沙箱隔離運行OpenClaw、Codex等智能體,自動完成文件整理、郵件歸檔等流程性工作。 影視內容創作:藉助AI圖像生成4.3倍、視頻生成6.2倍於M5 Pro的速度,創作者可本地完成電影級剪輯與AI素材生成。 隱私敏感計算:醫療、法律、金融行業的機密數據全程在本地處理,無需上傳雲端即可滿足合規要求。
Qwen-Image-2.1 – 阿里千問團隊開源的圖像生成模型
Qwen-Image-2.1是什麼 Qwen-I...
ChatGPT Images 2.5 – OpenAI 推出的新一代圖像生成模型
ChatGPT Images 2.5是什麼 Ch...
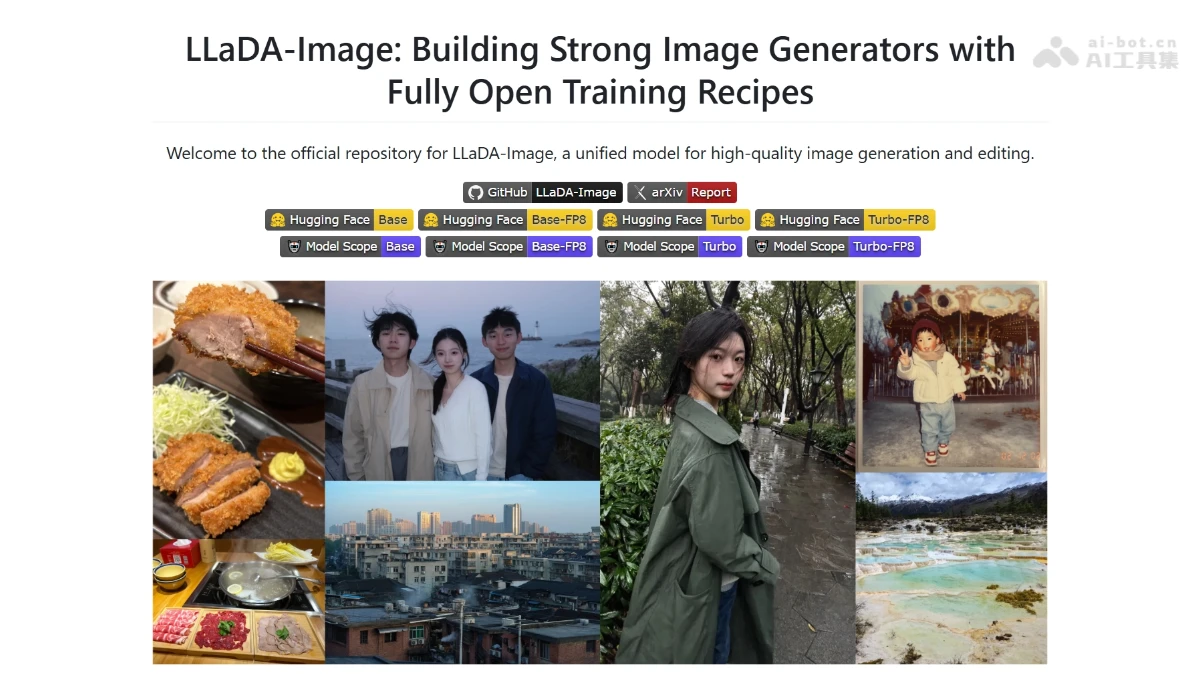
LLaDA-Image – 螞蟻集團開源的統一圖像生成與編輯模型
LLaDA-Image是什麼 LLaDA-Ima...
MAI-Image-2.5-Pro – 微軟推出的高精度圖像生成模型
MAI-Image-2.5-Pro是什麼 MAI...
Mage-Flow – 微軟開源的輕量級多模態圖像生成模型系列
Mage-Flow是什麼 Mage-Flow ...
Qwen-Image-3.0 – 阿里通義推出第三代圖像生成基礎模型
Qwen-Image-3.0是什麼 Qwen-I...
Muse Image – Meta 超級智能實驗室推出的AI圖像生成模型
Muse Image是什麼 Muse Image...
GenEvolve – 美團等推出的自演進圖像生成 Agent
GenEvolve是什麼 GenEvolve ...
Chichi-pui – AI圖像生成與分享平台,專注日系風格
Chichi-pui是什麼 Chichi-pui...
HiDream-O1-Image-1.5 – 智象未來推出的商用圖像生成模型
HiDream-O1-Image-1.5是什麼 ...
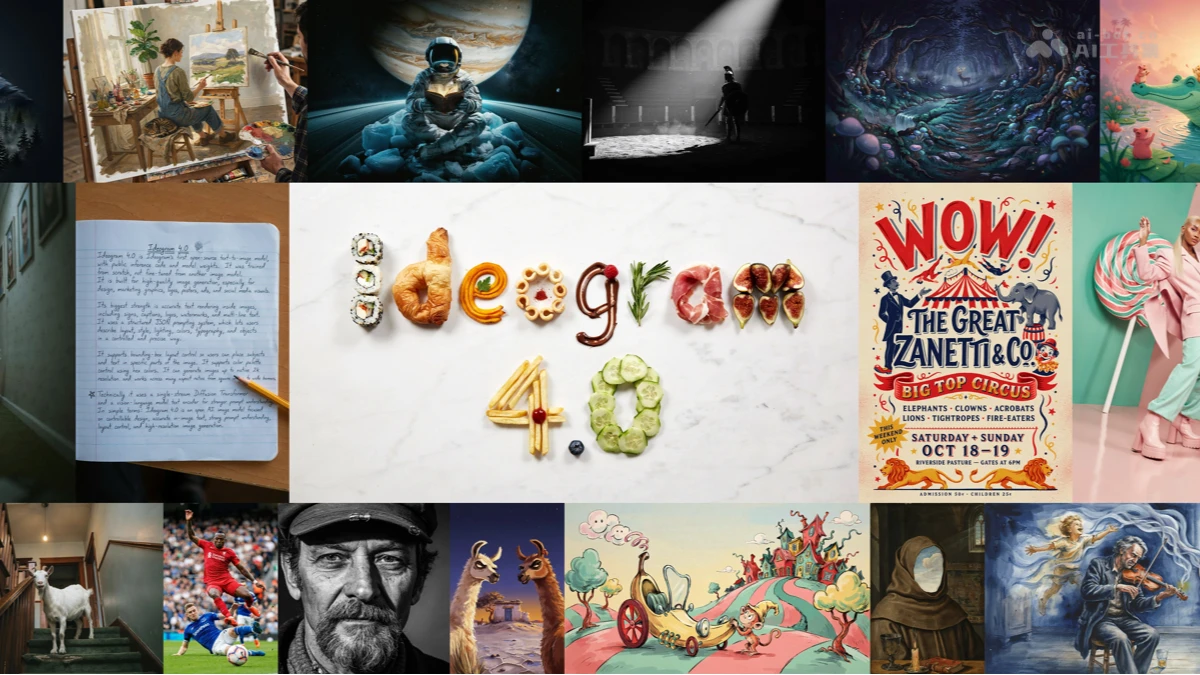
Ideogram 4 – Ideogram 開源的文本到圖像生成模型
Ideogram 4是什麼 Ideogram 4...
Uni-1.1 – Luma AI 推出的新一代圖像生成模型
Uni-1.1是什麼 Uni-1.1是Luma...
Step Image Edit 2 – 階躍星辰推出的圖像生成編輯模型
Step Image Edit 2是什麼 Ste...
GPT-image-2 – OpenAI推出的下一代原生圖像生成模型
GPT-image-2是什麼 GPT-image...
Wan2.7-Image – 阿里通義推出的 AI 圖像生成與編輯模型
Wan2.7-Image是什麼 Wan2.7-I...

InstanceAssemble – 小紅書聯合復旦推出的圖像生成框架
InstanceAssemble是什麼 Inst...
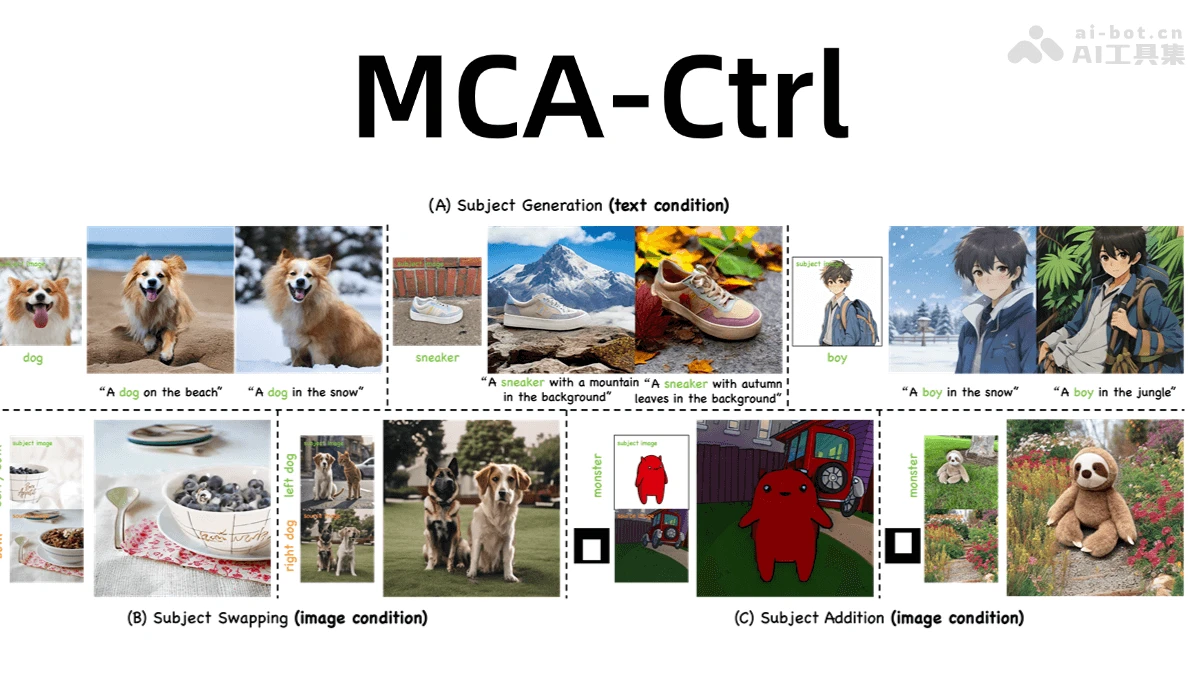
MCA-Ctrl – 中科院和中科大推出的圖像定製生成框架
MCA-Ctrl是什麼 MCA-Ctrl(Multi-party Collaborative Attention Control)是中科院計算所和中國科學院大學的推出的圖像定製生成框架,基於文本和複雜視覺條件實現高質量的圖像生成。MCA-Ctrl引入兩種注意力控制策略,Self-Attention Global Injection(SAGI)和Self-Attention Local Query(SALQ),及一個主體定位模塊(SLM),解決背景不一致、主體混淆等問題。MCA-Ctrl在零樣本圖像定製方面優於現有方法,能有效保持主體特徵和條件信息的一致性。 MCA-Ctrl的主要功能 高質量圖像定製:在文本或圖像條件下生成高質量的定製圖像,保持與條件輸入的語義一致性。 主體特徵保持:在複雜的視覺場景中,準確捕捉特定主體的外觀和內容,同時避免主體泄漏和混淆問題。 背景一致性:在圖像條件生成中,保持背景的一致性。 零樣本生成:支持直接在零樣本條件下生成高質量的圖像。 多種任務支持:支持多種圖像定製任務,包括主體生成、主體替換和主體添加等。 MCA-Ctrl的技術原理 多主體協同擴散過程:基於三個並行的擴散過程,主體擴散過程(Bsub)、條件擴散過程(Bcon)和目標擴散過程(Btgt)。主體擴散過程負責處理主體圖像,條件擴散過程處理條件圖像或文本,目標擴散過程生成最終的定製圖像。 自注意力層操作:Self-Attention Global Injection(SAGI)將主體和條件圖像的全局自注意力特徵注入到目標擴散過程中,增強目標圖像的細節真實性和內容一致性。SAGI操作有助於糾正由局部查詢引起的特徵混淆。目標擴散過程基於查詢主體和條件圖像的局部特徵,獲取主體的外觀和背景內容。SALQ操作確保生成的圖像在主體和背景上與條件圖像保持高度一致性。 主體定位模塊(SLM):爲在複雜視覺場景中準確識別和定位主體,引入主體定位模塊。SLM結合目標檢測模型(如DINO)和分割模型(如SAM),處理多模態指令,輸出精確的主體圖像層和可編輯圖像層,減少特徵混淆和僞影。 無調優框架:MCA-Ctrl不需要對每個主體進行單獨的微調訓練,基於注意力控制策略和主體定位模塊,在零樣本條件下實現高質量的圖像定製。 MCA-Ctrl的項目地址 GitHub倉庫:https://github.com/yanghan-yh/MCA-Ctrl arXiv技術論文:https://arxiv.org/pdf/2505.01428 MCA-Ctrl的應用場景 數字內容創作:快速生成遊戲、動畫中的角色和場景。 廣告與營銷:製作個性化廣告圖像和品牌推廣素材。 娛樂與社交媒體:生成個性化頭像、圖片和社交媒體內容。 教育與培訓:輔助教學材料製作,創建虛擬實驗室場景。 藝術與設計:提供藝術創作靈感,輔助室內設計預覽。
Ghiblio.art – 免費AI圖像生成平台,支持文字和圖片轉化爲吉卜力風格
Ghiblio.art是什麼 Ghiblio.a...