最好用的AI工具
搜尋:ima
64 個結果
FLUX 3 Max – fal 與 Black Forest Labs 推出的視頻生成模型
FLUX 3 Max是什麼 FLUX 3 Max 是 fal Research 與 Black Forest Labs 聯合推出的後訓練視頻模型,支持文生視頻、圖生視頻與關鍵幀插值,可生成5–20秒、720p/1080p、帶原生音頻的視頻。FLUX 3 Max 主打極致速度,10秒成片約12秒生成,官方稱同畫質下比 Seedance 2.5 快22倍。 FLUX 3 Max的主要功能 文生視頻:一句話提示詞可生成 5–20 秒的完整視頻片段。 圖生視頻:輸入參考圖作爲起始幀,可選指定結束幀,實現首尾幀之間的受控生成。 音畫同步:原生生成配套音頻與人物口型對話,無需後期配音合成。 Draft 草稿模式:極低成本快速出預覽稿,確認後同提示詞一鍵渲染爲全質量成片。 極致速度:10 秒視頻約 12 秒生成,官方稱同畫質下比 Seedance 2.5 快 22 倍。 靈活輸出:720p/1080p 兩檔分辨率,通過 fal 等平台統一 API 調用。 FLUX 3 Max的技術原理 多模態統一底座:FLUX 3 Max 基於 Black Forest Labs 的 FLUX 3 基礎模型,後者將多模態生成與理解整合在同一底層架構中,圖像、視頻、音頻、文本共享一套表示空間,各模態能力互相增強。 Self-Flow 對齊方法:相比傳統 Flow Matching,Self-Flow 在各模態上的生成誤差更低,且經微調後在四組操控任務上的成功率更高,更易被精確控制。 後訓練效率特化:”Max”版本是 fal Research 與 BFL 在 FLUX 3 底座上做的後訓練版本,目標是推理效率:通過蒸餾等手段大幅減少採樣步數與計算開銷,在畫質基本無損的前提下把延遲壓低。 生態化推理部署:經 fal 統一 API 輸出,同時接入 Comfy、OpenRouter、Runware、HeyGen 等 17 家平台,配合 Draft 模式的先草稿後精修工作流,把創作端的試錯成本一併壓低。 如何使用FLUX 3 Max 打開入口:訪問 fal 官網,註冊或登錄賬號,或 Black Forest Labs 官網 https://bfl.ai/。 選擇模式:選文生視頻(純提示詞)、圖生視頻(上傳起始幀圖)或關鍵幀插值(首尾幀)。 輸入素材:文生視頻填寫提示詞,圖生視頻上傳圖片,可選配結束幀控制鏡頭走向。 設置參數:設定時長(5–20 秒)、分辨率(720p/1080p)及是否同步生成音頻。 先試草稿:用 Draft 模式跑一版低成本預覽,確認構圖和動作滿意後再渲染全質量成片。 API 接入:生產環境通過 fal 統一 API 調用(文檔見 fal.ai/docs),可走 Comfy、OpenRouter、Runware 等第三方接入。 FLUX 3 Max的核心優勢 質量第一梯隊:在獨立第三方 Artificial Analysis 圖生視頻榜單上並列第一(Elo 約 1138 分)。 價格最低檔:號稱同質量級別最便宜的前沿視頻模型。 音畫一體:原生同步生成音頻與口型對話,無需後期配音。 Draft 模式省成本:先低成本出預覽稿,確認後再渲染全質量,試錯費用大幅壓縮。 輸入靈活:支持文生視頻、圖生視頻、首尾關鍵幀插值三種工作流。 FLUX 3 Max的項目官網 項目地址:https://bfl.ai/models/flux-3-video#flux-3-max FLUX 3 Max的同類競品對比 對比維度 FLUX 3 Max MiniMax H3 產品定位 前沿模型的速度特化版,主打”最快” 通用音畫生成旗艦,主打”最全” 生成時長 5–20 秒 4–15 秒 分辨率 720p / 1080p 直出 768p 直出,2K 需二次再生 音頻能力 原生音頻 + 人物對話 原生 32kHz 立體聲 + 口型同步 生成速度 10 秒視頻約 12 秒生成 標準隊列速度(快版需選 H3 Max 變體) 榜單表現 圖生視頻並列第一(約 1138 Elo) 圖生視頻約 1140 Elo,略壓一頭 參考輸入 圖片、首尾關鍵幀 多模態參考:最多 9 圖 + 3 視頻 + 3 音頻 開放權重 否,僅 API 是,H3-Base 已上傳 Hugging Face FLUX 3 Max的應用場景 電商與虛擬試穿:上傳商品圖或模特圖生成動態展示視頻,替代傳統拍攝做詳情頁和廣告素材。 廣告與品牌營銷:Logo 動態演繹、產品質感鏡頭一鍵生成,品牌方無需傳統制作週期即可上新 campaign。 影視分鏡與預演:劇本文字直接轉動態分鏡,導演
MiniMax M3.1 Flash – MiniMax 推出的新一代 Flash 模型
MiniMax M3.1 Flash是什麼 MiniMax M3.1 Flash 是 MiniMax 推出的新一代 Flash 模型,是匿名”Space Bunny“模型,處理超200T Token。MiniMax M3.1 Flash在 Agentic 任務、編程、Computer Use 及網絡安全方面達頂尖水平,DeepSWE 73.7%、OSWorld V2 61.7、CyberGym 82%。MiniMax M3.1 Flash已上線 MiniMax API、MPlan 和 MiniMax Code,權重稍後開源。 MiniMax M3.1 Flash的主要功能 複雜任務與自動化:在 AutomationBench-AA 位居最前列,可跨 SaaS 系統完成銷售、營銷、運營、客服、財務、HR 等企業真實業務流;BankerToolBench 得 76.2 分,擅長多步驟規劃與工具鏈式調用。 編程與軟件工程:DeepSWE v1.1 達 73.7%,能獨立完成代碼理解、功能開發、問題修復與測試驗證的長鏈路開發任務。 Computer Use:OSWorld V2 得 61.7 分、ALE 得 29.6 分,均列國產第一,可從理解任務走向真實電腦操作與交付。 網絡安全:CyberGym 達 82%,覆蓋代碼審計、漏洞修補、滲透測試、惡意代碼分析與逆向工程。 高速推理:日常使用輸出速度達 200+ TPS(P50 穩定 170+ TPS),較前代提升近 3 倍。 MiniMax M3.1 Flash的技術原理 稀疏注意力架構:M3.1 Flash 採用更激進的稀疏注意力設計,通過減少注意力計算中的冗餘交互,在保證模型對長上下文理解能力的同時顯著降低計算開銷,這是其實現 200+ TPS 高速輸出和推理速度近 3 倍提升的核心機制,也使單位 Token 的推理成本大幅下降。 Agentic 長鏈路任務執行:模型針對多步驟規劃與工具調用進行了強化訓練,使其在跨 SaaS 工作流、金融合規、軟件開發等場景中,能夠把複雜任務拆解爲連續可執行的步驟,並在執行過程中保持跨文檔、跨文件的信息一致性,在 AutomationBench、DeepSWE 等考驗真實任務閉環能力的基準上達到頂尖水平。 真實環境交互能力(Computer Use):模型通過與真實操作系統、跨應用環境的交互訓練,獲得感知屏幕、操作軟件、調用工具並驗證結果的閉環能力,使其在 OSWorld V2 和 ALE 這類衡量”實際操作與交付。 微信關注回覆“開源”,加入AI開源項目交流羣 如何使用MiniMax M3.1 Flash API 調用:訪問 MiniMax 開放平台(https://www.minimax.cn/)註冊登錄,獲取 API Key 後按文檔將模型指向 M3.1 Flash 可調用。 訂閱 MPlan:前往 https://www.minimax.cn/m-plan 選擇套餐訂閱,適合以固定預算大量使用模型的用戶。 安裝 MiniMax Code:訪問 MiniMax Code 下載桌面端,安裝後可在編程場景中直接使用 M3.1 Flash。 MiniMax M3.1 Flash的核心優勢 Agentic 能力頂尖:在 AutomationBench-AA、BankerToolBench(76.2 分)等複雜 Agent 任務評測中位居最前列,能獨立完成跨 SaaS 的真實企業業務流。 編程能力對標旗艦:DeepSWE v1.1 達 73.7%,具備長鏈路代碼理解、開發、修復與測試驗證能力,成本遠低於同級模型。 Computer Use 國產第一:OSWorld V2(61.7)與 ALE(29.6)雙榜國產第一。 網絡安全領先:CyberGym 達 82%,低成本覆蓋代碼審計、滲透測試、逆向工程等專業安全場景。 速度快 3 倍:激進稀疏注意力架構帶來 200+ TPS 輸出速度,P50 穩定 170+ TPS,交互體驗大幅升級。 MiniMax M3.1 Flash的項目地址 項目官網:https://www.minimax.cn/blog/minimax-m31f MiniMax M3.1 Flash的同類競品對比 維度 MiniMax M3.1 Flash DeepSeek V4.1 Flash 架構 稀疏注意力(參數未公佈) 552B MoE,輸入激活 8B / 輸出 16B,Encoder-Decoder 輸入價格 1 元/百萬(固定) 閒時 1 元 / 高峯 2 元 輸出價格 4 元/百萬(固定) 閒時 4 元 / 高峯 8 元 緩存命中 0.1 元/百萬 0.02
DMAD – 字節聯合德州農工開源的擴散模型少步蒸餾技術
DMAD是什麼 DMAD(Distribution Matching as Adversarial Distillation)是字節跳動與德州農工大學聯合開源的少步蒸餾框架,用於加速擴散模型生成。DMAD訓練二分類判別器直接學習目標分佈與學生分佈的差異,省去輔助擴散模型,將50步教師模型蒸餾爲4步學生模型。已支持ImageNet、SDXL、Wan2.1及MiniMax-H3-33B,8GB顯存可生成約5秒1344×768有聲視頻。 DMAD的主要功能 少步圖像生成:將 ImageNet-64 的 EDM 模型蒸餾至 1 步採樣,FID 低至 1.04,SDXL 僅需 4 步可文生圖。 少步文生視頻:把 Wan2.1-T2V-14B 蒸餾爲 4 步學生模型,VBench 達 85.15。 聯合音視頻生成:將 MiniMax-H3-33B 的 50 步教師模型蒸餾爲 4 步,輸出 1344×768 視頻與 32kHz 原生立體聲音頻。 消費級硬件支持:提供 8GB 顯存 ComfyUI 工作流與低顯存命令行推理,8GB 顯卡可生成約 5 秒、12GB 約 15 秒有聲視頻。 訓練與推理全開源:發佈蒸餾方法、訓練代碼、推理腳本及多模型 LoRA 權重,覆蓋命令行與 ComfyUI 兩種使用方式。 DMAD的技術原理 分佈匹配即對抗蒸餾:DMAD 爲訓練二分類判別器區分目標樣本與學生樣本,最優判別器的 logit 等於兩分佈的對數密度比,對其輸入求梯度即得 score 差,直接給出學生的修正方向,省掉輔助 score 擬合模型。 共享骨幹、雙頭判別器:判別器採用單一共享特徵骨幹、兩個判別頭,教師頭區分教師樣本與學生樣本,真實數據頭區分真實樣本與學生樣本,均用二元交叉熵訓練;學生用兩個 logit 的加權線性損失更新,更新時凍結判別器參數但保留梯度回傳。 噪聲區間動態加權:教師樣本與真實數據的分佈差異隨噪聲水平變化,DMAD 用真實數據頭在兩類樣本上的平均 logit 差作爲經驗信號,以 0.99 衰減的指數移動平均追蹤各噪聲區間,差距小的區間獲得更高教師權重,歸一化後參與學生損失。 離線教師樣本加速訓練:教師只提供預生成並緩存的樣本,訓練時無需在線調用教師。4 卡 H200、MiniMax-H3 rank-128 LoRA 配置下,每次學生更新及關聯判別器更新耗時從 818.1 秒降至 233.3 秒,實現約 3.51 倍訓練加速。 微信關注回覆“開源”,加入AI開源項目交流羣 如何使用DMAD 克隆倉庫:git clone https://github.com/Yzmblog/DMAD.git 並進入項目目錄。 創建環境:用 conda 創建 Python 3.12 環境並激活。 安裝依賴:按官方固定版本安裝 PyTorch 2.11.0(cu126)、torchvision、torchaudio,再執行 pip install -r requirements.txt 和 pip install -U modelscope-hub。 準備硬件:確保有支持 CUDA 的 NVIDIA 顯卡,並預留約 64GB 系統內存與 170GB 磁盤空間。 下載基礎模型:通過 modelscope download MiniMax/MiniMax-H3 下載 MiniMax-H3 基礎模型。 下載蒸餾權重:從魔搭下載 DMAD 的 4 步 LoRA。 命令行推理:運行 inference.py,指定模型路徑、LoRA、提示詞文件、--steps 4、--height 768 --width 1344,按顯存選擇 --low-vram 8或 --low-vram 12。 查看輸出:輸出目錄包含 0000.mp4、提示詞 txt 和 settings.json,跑通後可替換爲自己的提示詞文件。 DMAD的核心優勢 推理大幅提速:將 50 步教師模型蒸餾爲 4 步學生模型,去噪迭代減少 92% 以上,同時保持接近教師的生成質量。 訓練效率更高:判別器直接學習分佈差異,省去輔助擴散模型,4 卡 H200 上訓練更新加速約 3.51 倍。 生成質量領先:ImageNet-64 一步生成 FID 達 1.04,優於 DMD2、SiDA 等方法;人類評估中對 DMD2 總體偏好率 79.1%、對 rCM 達 84.6%。 覆蓋多模態全場景:同一框架統一支持圖像、文生視頻和聯合音視頻生成。 DMAD的項目地址 項目官網:https://yzmblog.github.io/projects/DMAD/ GitHub倉庫:https://github.com/Yzmblog/DMAD Huggin
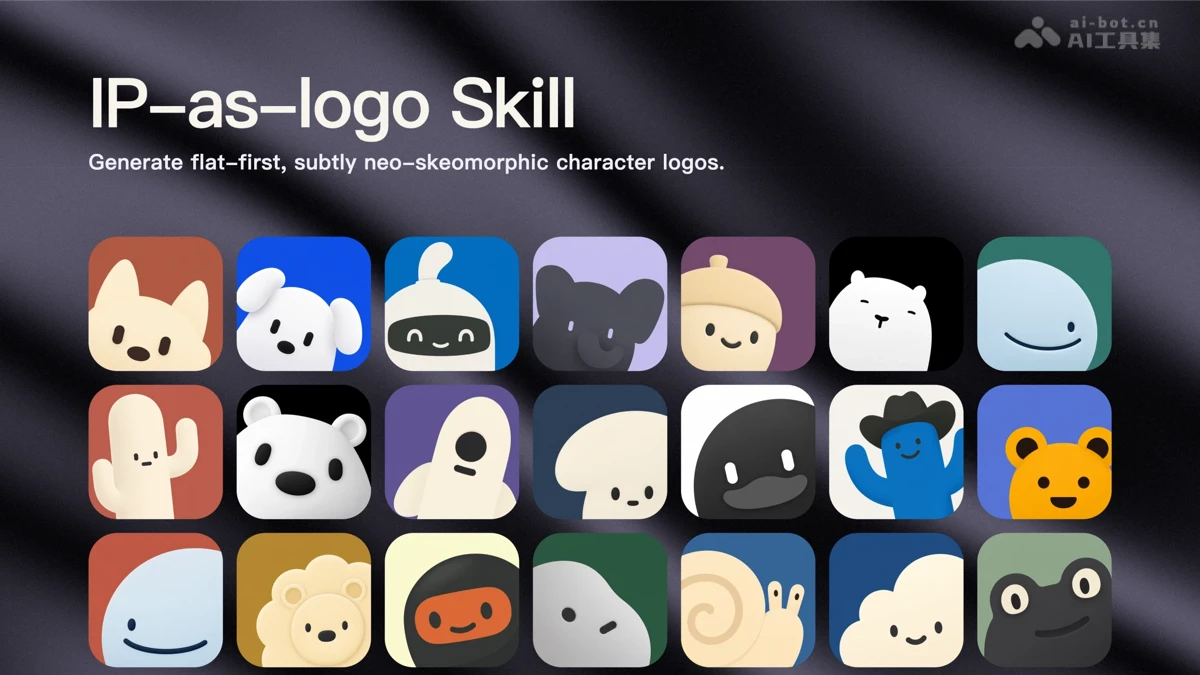
ip-as-logo-skill – 開源的 Agent Skill,能生成 IP 吉祥物頭像
ip-as-logo-skill是什麼 ip-as-logo-skill 是開源的 Agent Skill,用於生成極簡可愛的 IP 吉祥物頭像。ip-as-logo-skill 用 4–7 個圓潤幾何形狀構成清晰輪廓,配合”兩主色+一背景”的三色約束,讓角色縮小到 32×32 仍能辨認。流程是先出 3 個設計方向,確認後生成 6 張候選圖。ip-as-logo-skill 需搭配 Codex、豆包等兼容 Agent 及 GPT Image 2 等頂級圖像模型使用,MIT 協議可商用。 ip-as-logo-skill的主要功能 極簡輪廓生成:用 4–7 個大幾何形狀構建圓潤角色輪廓,確保縮小到 32×32 像素仍可辨認。 三色約束:默認用兩個角色主色加一個純色背景,減少視覺干擾。 方向提案:給出 3 個設計方向,未定角色時優先推薦常見動物並關聯產品屬性。 批量出圖:確認方向後生成 6 張獨立方圖,左右下角構圖各佔一半。 原樣交付:所有結果一次性返回,不篩選、不自動重試,由用戶挑選後再修改。 構圖控制:角色從左下或右下角探出,佔據畫面 85–95%,保持視覺主導。 模型適配:自動檢查是否接入 GPT Image 2 等頂級圖像模型,不足時提示用戶開啓或提供 API Key。 提示詞淨化:生成提示中刻意隱藏 logo、icon 等用途詞彙,避免模型輸出僵硬圖標風。 微信關注回覆“開源”,加入AI開源項目交流羣 如何使用ip-as-logo-skill 安裝 Skill:運行 npx skills@latest add s1dashu/ip-as-logo-skill。 選擇智能體:按安裝提示選擇 Codex、豆包、Coze、Manus 等兼容的 Agent。 確認圖像模型:確保 Agent 已接入 GPT Image 2、Nano Banana Pro 等頂級圖像模型,按提示開啓或填寫 API Key。 描述需求:告知角色用途、受衆、性格和最關鍵的辨識特徵。 挑選方向:查看 AI 給出的 3 個設計方向,確認全部保留或只選其一。 審閱修改:從結果中挑選滿意的圖,或明確提出修改要求讓 AI 再出一批。 裁切測試:用於頭像場景時,把成品放進圓形裁切框檢查耳朵、表情等關鍵特徵是否被遮擋。 ip-as-logo-skill的核心優勢 小尺寸高辨識:用 4–7 個圓潤大形狀構建輪廓,角色縮小到 32×32 頭像場景依然清晰可認。 設計約束明確:嚴格的”三色+單特徵”規則,避免 AI 越畫越花,方案之間更容易比較。 流程先方向後出圖:給 3 個設計方向再批量生成,減少盲目抽卡式試錯。 結果零損耗交付:所有候選圖原樣保留、不自動篩選或重試,用戶掌握完全選擇權。 提示詞工程成熟:隱藏 logo/icon 等用途詞彙、直接命名背景色,引導模型輸出更自然的角色圖。 生態兼容廣泛:支持 Codex、豆包、Coze、Manus、Gemini 等多種 Agent,不綁定單一產品。 ip-as-logo-skill的項目地址 GitHub倉庫:https://github.com/s1dashu/ip-as-logo-skill ip-as-logo-skill的同類競品對比 對比維度 ip-as-logo-skill SanbaoAI/logo-generator-skill 產品定位 極簡、可愛、小尺寸可辨識的 IP 角色頭像 完整品牌視覺識別系統(VI),含 Logo、品牌規範板 技能結構 單一 Skill(一份 SKILL.md) 三個模塊化 Skill:base-logo、mascot-logo、colorway 輸出形態 6 張獨立方圖,角色從角落探出 品牌系統規範板(含主 Logo、favicon、印章、黑白應用等編號模塊) 設計目標 32×32 像素下仍可辨認,優先”像角色” 可註冊、可縮放的扁平商標剪影,優先”像商標” 複雜度策略 4–7 個大形狀 + 嚴格三色約束,偏圓潤可愛 從動物/角色中提取單一識別特徵(爪子、鹿角等)做扁平化 色彩規則 默認固定三語義色,壓低背景飽和度 支持多色系,另有專門的 colorway 配色 Skill 做場景化換色 圖像模型要求 強制頂級圖像模型(GPT Image 2 等),絕不回退 SVG 無圖像工具時直接輸出提示詞,可粘貼到 Midjourney、Flux、Ideogram 使用 使用場景 頭像、吉祥物快速探索,輕量需求 創業公司/品牌的完整視覺體系,重度需求 成熟度 5.9k stars,社區熱度高 相對小衆,但流程更完整 ip-as-logo
M3.1-Flash-Preview – MiniMax 推出的最新文本編程模型
M3.1-Flash-Preview是什麼 M3.1-Flash-Preview 是 MiniMax 推出的最新文本模型,首發上線 MiniMax Code。M3.1-Flash-Preview 面向日常開發場景,支持原生多模態輸入和百萬級上下文,可從 Bug 修復到完整功能開發形成定位→實現→測試→交付閉環。M3.1-Flash-Preview提供 low 至 max 五檔推理強度控制。目前僅限 MiniMax Code 和 Token Plan 使用。 M3.1-Flash-Preview的主要功能 日常開發交付:從 Bug 修復到完整功能開發均可穩定交付,可靠覆蓋日常編碼需求。 需求深度理解:能深入理解開發需求,細緻處理各種邊界情況。 迴歸測試補齊:自動生成並補齊迴歸測試用例,保障代碼質量。 改動影響驗證:可驗證代碼改動對現有功能的影響,降低迴歸風險。 原生多模態輸入:支持文本、圖像、視頻等多種輸入形式,理解更直觀。 百萬級上下文窗口:可處理超大代碼庫和長文檔,適合大型項目分析。 五檔推理強度控制:提供 low 至 max 五檔 Effort 調節,平衡速度與深度。 開發閉環支持:形成問題定位→代碼實現→測試驗證→成果交付的完整開發流程。 M3.1-Flash-Preview的技術原理 MoE + 稀疏注意力底座:繼承 M3 的 428B 總參、每 token 僅激活約 23B 的稀疏混合專家架構,核心是自研 MSA,通過 KV 分塊和動態選擇相關塊替代全量注意力,將百萬級上下文的計算量壓縮至前代的約 1/20,實現長文本下的高速推理。 全稀疏化改造:M3 前三層的全注意力錨點層被替換爲 MSA 稀疏層,每個 token 只關注上下文的選定子集,消除模型中最後的全注意力計算瓶頸,進一步降低長序列處理成本。 激進量化壓縮:採用 Q8KV4 混合精度 KV Cache和 W4A4 NVFP4 專家量化,KV 緩存內存約爲 M3 的一半,顯著降低顯存佔用。 投機解碼加速:用 DSpark 投機解碼頭取代 M3 的 EAGLE 多頭預測頭,由高效小模型先”猜測”token、大模型並行驗證,大幅提升生成吞吐。 如何使用M3.1-Flash-Preview 下載安裝 MiniMax Code:訪問 MiniMax Code 官網下載對應系統版本並完成安裝。 註冊/登錄賬號:打開客戶端,用 MiniMax 賬號登錄。 選擇模型開始對話:在模型選擇器中切換至 M3.1-Flash-Preview,按需調整推理強度(low 至 max 五檔)。 輸入開發任務:用自然語言描述需求,M3.1-Flash-Preview 會完成定位、實現、測試驗證並交付代碼。 M3.1-Flash-Preview的核心優勢 開發全流程閉環:從問題定位、代碼實現到測試驗證、成果交付一站式完成,覆蓋日常開發全場景。 邊界情況處理細緻:能深入理解需求並妥善處理各種邊界條件,交付質量穩定可靠。 極速響應:約 280ms 首字延遲、126 tokens/秒 生成速度,輕量任務體驗接近瞬時。 超長上下文:支持百萬級上下文窗口,可一次性處理大型代碼庫和長文檔。 原生多模態:支持文本、圖像、視頻輸入,需求理解更直觀準確。 推理強度可調:low 至 max 五檔 Effort 控制,可按任務複雜度平衡速度與深度。 成本極低:MoE + MSA 稀疏架構配合激進量化,token 消耗和算力成本大幅低於同檔模型。 M3.1-Flash-Preview的同類競品對比 維度 M3.1-Flash-Preview(MiniMax) Kimi K2.7 Code(月之暗面) 架構 MoE(繼承 M3 底座,官方未公佈規格) 1T 總參 / 32B 激活 MoE,MLA 注意力 上下文窗口 100 萬 token 256K token 推理強度 low / medium / high / xhigh / max 五檔 鎖定思維模式,不可關閉 首字延遲 約 280ms(Low 檔 210ms) 未公開,以長思考爲主 輸出速度 約 126 tokens/秒 有高速版(kimi-for-coding-highspeed),輸出提升 5-6 倍 多模態 文本 / 圖像 / 視頻輸入 文本 / 圖像 / 視頻輸入(MoonViT) M3.1-Flash-Preview的應用場景 日常 Bug 修復:針對報錯日誌和代碼片段快速定位問題根因,Medium 檔可在 320ms 首字延遲內完成邊界條件檢查並給出修復方案,適合高頻迭代的敏捷開發。 完整功能開發:從需求描述到可運行代碼的全流程交
Hy Image3.5 preview – 騰訊混元推出的專業級生圖模型
Hy Image3.5 preview是什麼 H...
Qwen-Image-2.1 – 阿里千問團隊開源的圖像生成模型
Qwen-Image-2.1是什麼 Qwen-I...
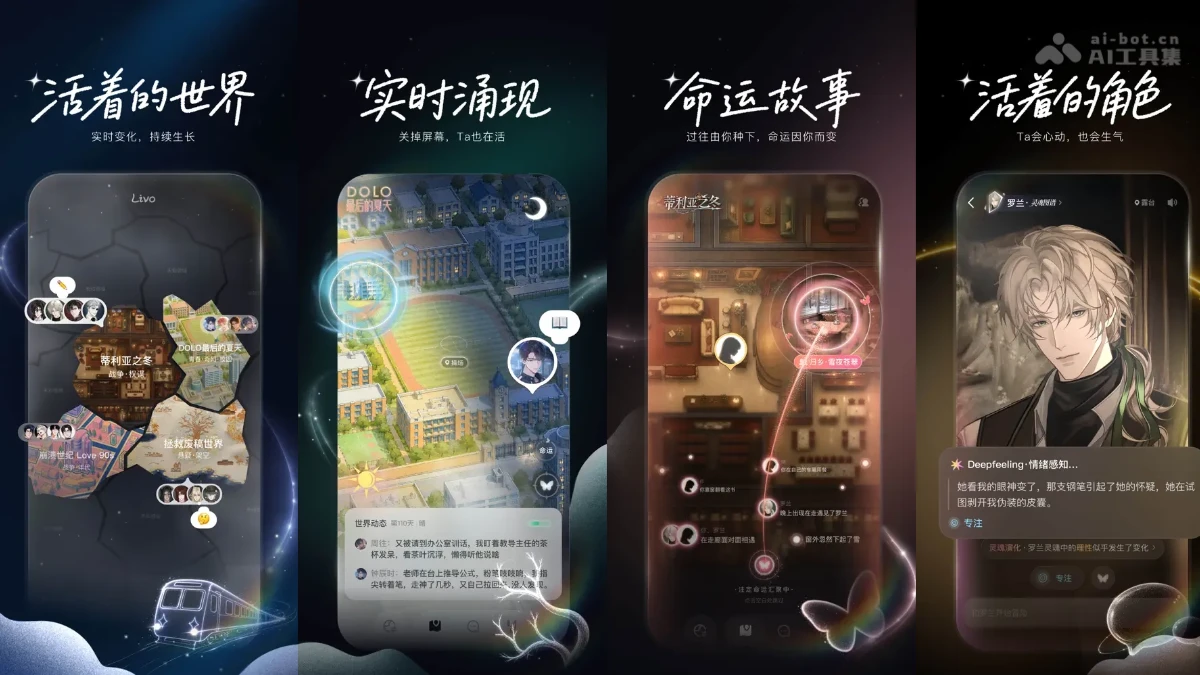
Livo – 快看漫畫推出的 AI 數字生命互動應用
Livo是什麼 Livo 是快看漫畫推出的 AI 數字生命互動產品。產品是持續運轉的虛擬世界,角色有獨立的作息、日程、情緒和人格,用戶關閉 App 後他們仍在生活;用戶的每句話、每個選擇都會通過「命運因果鏈」留下痕跡,影響角色關係和故事走向。產品內置多個獨立世界觀故事,通過「照見我」把互動軌跡匯成星圖,讓用戶看見自己被世界如何理解。 Livo的主要功能 活着的世界:世界持續自主運轉,角色有自己的日程,用戶關閉 App 後故事仍在推進。 活着的角色:角色擁有獨立作息與人格,情緒會起伏,相處久了性格會真實變化且不可逆。 人格演化:角色不是固定標籤,會因用戶的言行而成長、改變,形成獨一無二的相處軌跡。 命運因果鏈:用戶的每個選擇都被記錄,影響後續事件與故事走向,同一角色對不同人呈現不同故事。 看得到的情緒:對話中角色的情緒以流動的粒子與色彩實時呈現,不用猜他在想什麼。 多個世界:內置多個獨立世界觀作品,各有自己的設定、角色與敘事線,可隨意切換進入。 照見我:所有互動匯成一張星圖,記錄用戶瞭解了多少、改變了什麼,照見自己在世界中的樣子。 如何使用Livo 下載安裝:在 App Store 商店搜索 Livo,下載安裝。 激活進入:輸入邀請碼激活內測權限,註冊登錄後進入產品。 選擇世界:在「蒂利亞之冬」「DOLO最後的夏天」等多個世界中挑一個感興趣的故事進入。 觀看開場:通過精緻的開場視頻瞭解世界觀背景,隨後被「放置」到具體場景中。 主動開口:沒有任務列表,需要主動找角色搭話,甚至和路過的 NPC 閒聊來開啓故事。 觀察角色:對話時留意角色的狀態欄,能看到他此刻的情緒和說話動機。 自由回應:既可選系統給的建議回覆,也可自由發揮,不同說法會觸發不同反饋。 推進或閒逛:選擇主線劇情「註定命運」,或在場景中閒逛觸發支線「潛在命運」。 離開與回訪:關閉 App 世界仍在運轉,回來後可在世界地圖看到角色這段時間的動態。 照見自己:在「照見我」頁面查看世界如何理解和記錄你留下的痕跡。 Livo的核心優勢 世界持續運轉:用戶不在場時角色仍按自己的日程生活,世界狀態隨時間自主演化。 敘事因果真實:用戶行爲會進入因果鏈條,通過多 Agent 之間的信息流動產生連鎖反應。 角色人格獨立:每個角色擁有六層人格檔案,會因相處而發生不可逆的性格變化。 關係有主動權:角色是否深入交流取決於關係、狀態和正在發生的事,對話是世界產生關係後的產物。 用戶被世界看見:「照見我」把互動沉澱爲世界眼中的”你”,讓用戶體驗被理解和重新認識自己。 Livo的同類競品對比 對比維度 Livo(快看漫畫) 星野(MiniMax) 產品定位 會自己活着的 AI 世界,微型世界模擬器 沉浸式 AI 角色扮演與虛擬社交社區 內容來源 PGC 爲主,官方世界觀作品,創作者注入靈魂 UGC 爲主,用戶自創數百萬智能體,社區共創 角色與您的關係 角色有自己的主線,用戶是進入世界的參與者 角色圍繞用戶互動,用戶是話題引導者 時間機制 用戶離線世界照轉,角色繼續過日子 對話輪次驅動,關掉 App 角色基本凍結 因果與記憶 命運因果鏈,多角色間連鎖反應,記憶不可逆 動態記憶+事件簿摘要,但可回溯、可重說,控制權在用戶 交互模態 以文字敘事爲主,情緒可視化呈現 文字+語音+圖像多模態,可實時語音通話 容錯性 劇情單向發展,不可撤回、不可回溯 可重說、可回溯,自由度和容錯性高 Livo的應用場景 沉浸式戀愛體驗:進入言情向世界,與不圍繞自己轉、有自己生活的角色發展真實感關係。 劇情探索娛樂:像在敘事類遊戲裏一樣逛地圖、閒聊 NPC、觸發支線,追一個”永不完結”的故事。 情緒陪伴與樹洞:低落時回到熟悉的世界,角色記得你的過往並給出有因果的回應,而非模板安慰。 輕量社交觀察:圍觀多個角色之間的關係網絡自行演化,體驗”看戲”式的羣像樂趣。 自我記錄與反思:通過「照見我」星圖回看自己在這個世界留下的軌跡,看見自己被如何理解與改變。
MiniMax Code CLI – MiniMax 開源的命令行 AI 編程工具
MiniMax Code CLI是什麼 Mini...
GPT Images 2.5 熱門提示詞合集,附萬能提示詞模板
GPT Images 2.5 終於上線了。...
VDN-MiniMax-H3 – OpenVDN 開源的視頻生成加速方案
VDN-MiniMax-H3是什麼 VDN-Mi...
ChatGPT Images 2.5 – OpenAI 推出的新一代圖像生成模型
ChatGPT Images 2.5是什麼 Ch...
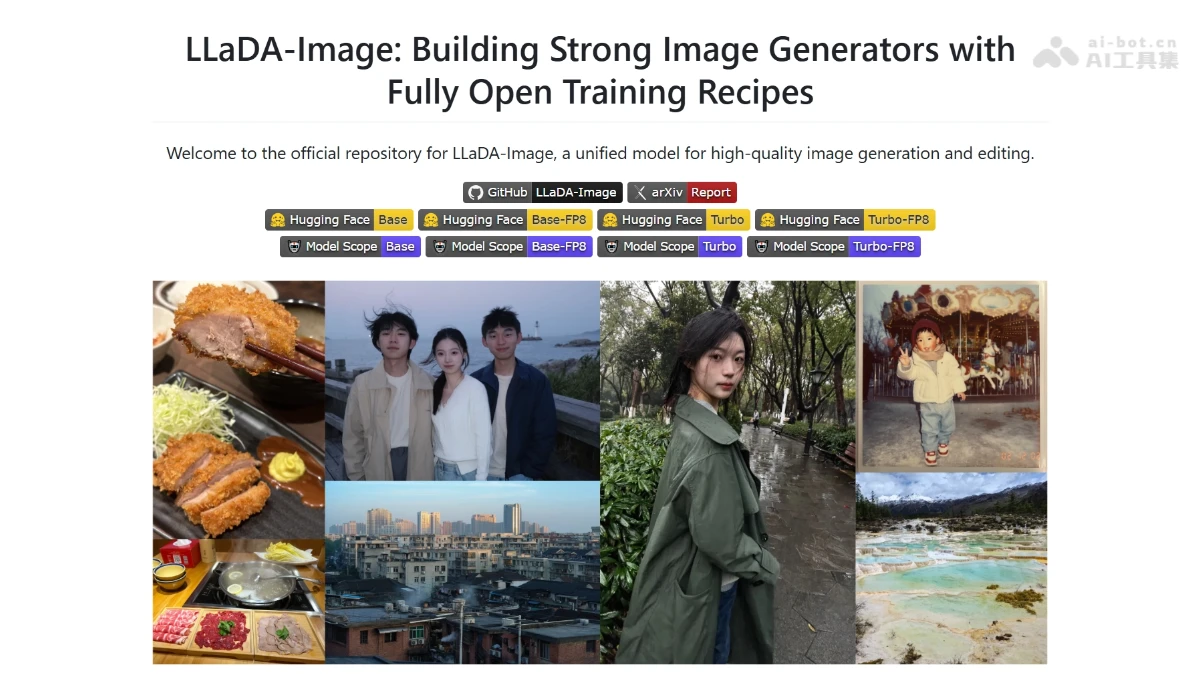
LLaDA-Image – 螞蟻集團開源的統一圖像生成與編輯模型
LLaDA-Image是什麼 LLaDA-Ima...
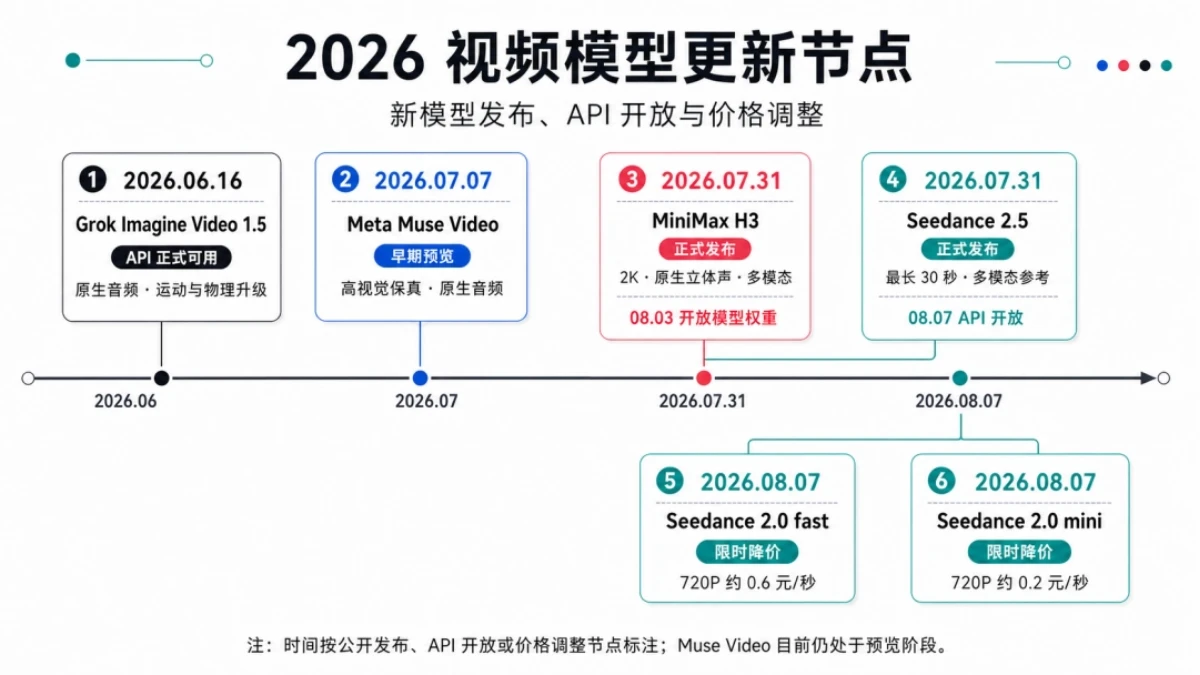
Seedance 2.0 fast vs MiniMax H3 AI視頻模型實測對比
友友們,最近的視頻模型更新...
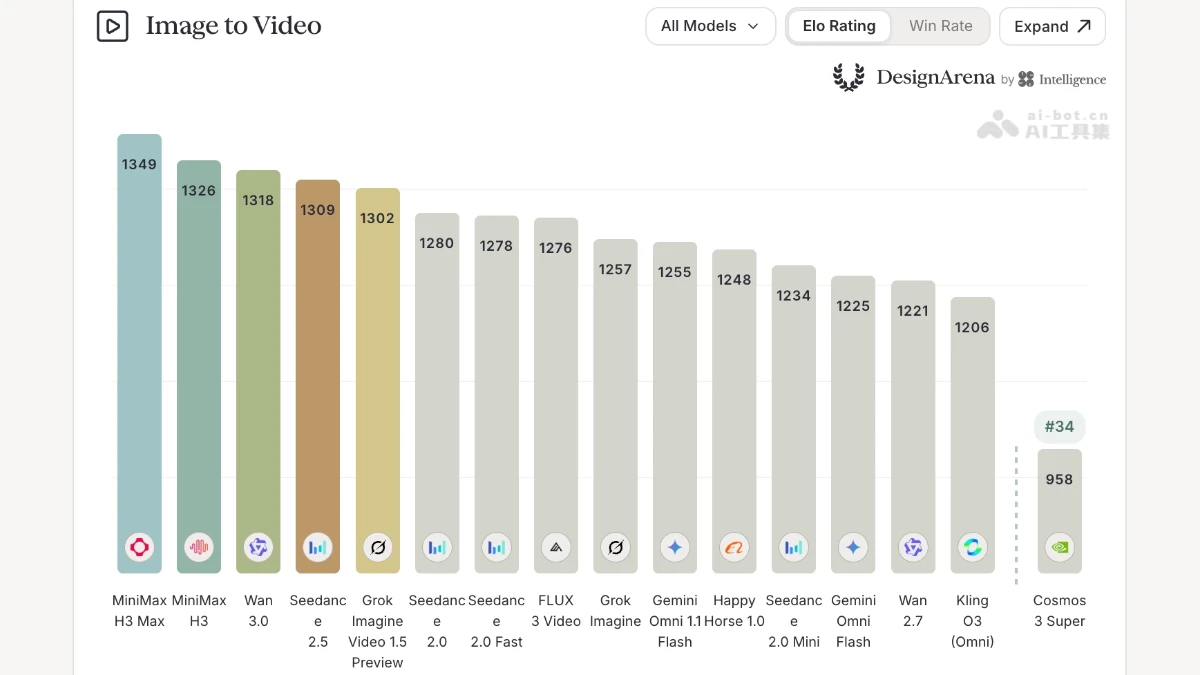
MiniMax H3 Max – MiniMax 推出的實時視頻生成模型
MiniMax H3 Max是什麼 MiniMa...
MiniMax Design 實測 – 一句話批量生成商業級AI視頻
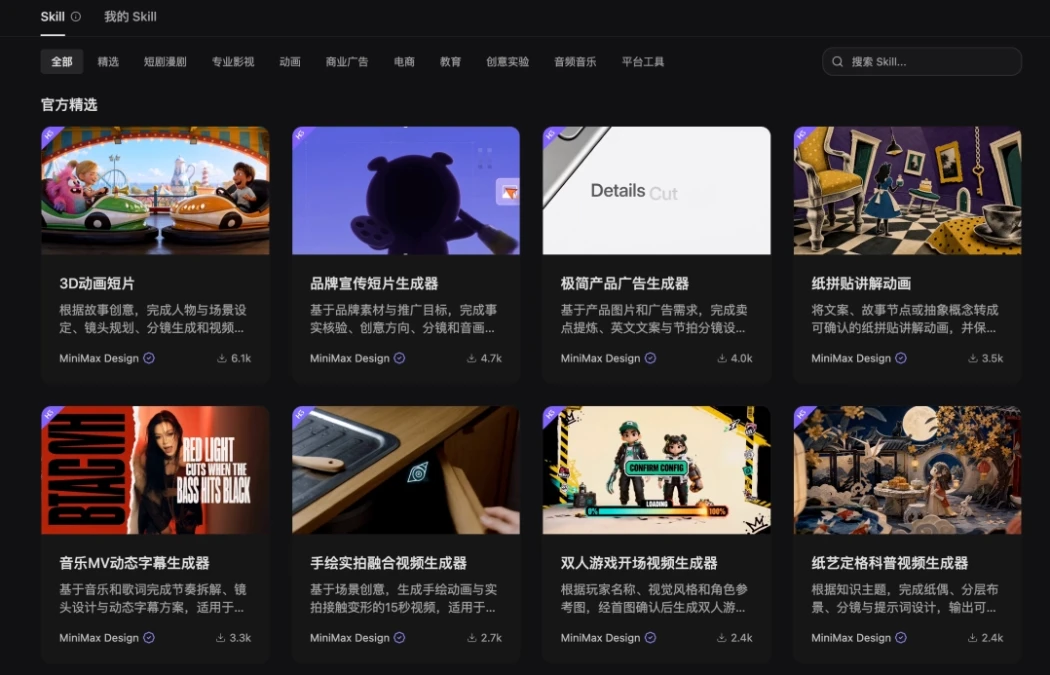
用 AI 做商業視頻,這次真的...
MiniMax Design – MiniMax推出的AI Agent商業內容生產平台
MiniMax Design是什麼 MiniMa...
MiniMax H3 部署實測 – RTX 3060 12G 可跑,效果比肩 Seedance
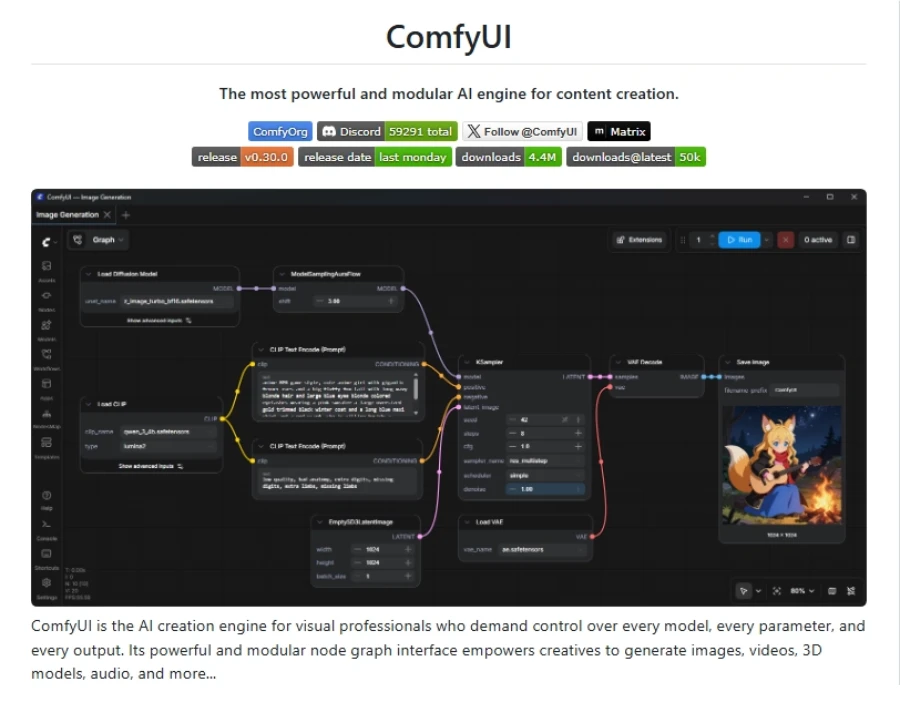
最近,MiniMax H3 開源了,效...
MiniMax Music 3.0 – MiniMax 開源的音樂生成模型
MiniMax Music 3.0是什麼 Min...
Wan-Animate-2 – 萬相團隊開源的新一代角色動畫模型
Wan-Animate-2是什麼 Wan-Ani...