最好用的AI工具
搜尋:Logo
5 個結果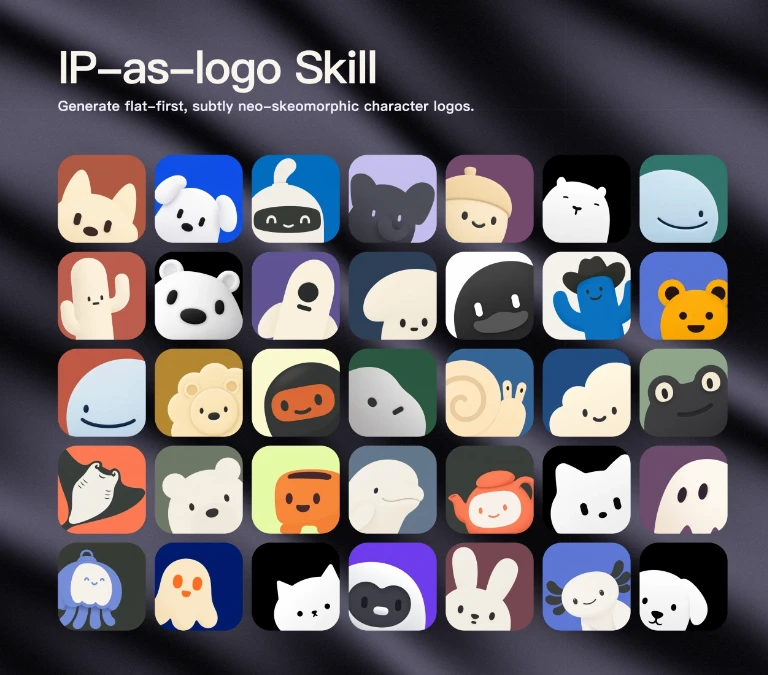
用豆包工作做 IP 形象教程 – 頭像、變體、表情包一次搞定
不管是做自媒體,還是打造產品、品牌,一個有辨識度的原創 IP 形象,都能讓人更容易記住你。 以前想做一套專屬 IP,從找設計師溝通、出方案,到摳細節、做延展,少說也得花上個把星期。 最近發現 GitHub 上一個拿到 6k 星的 ip-as-logo-skill 技能,搭配豆包工作,兩句話就能生成一套極簡、可愛的原創 IP 頭像。 我們還能在此基礎上延展出全套打工人表情包。 更實用的是,我們可以把自己調好的設計標準沉澱成專屬 Skill,以後一句話就能反覆調用! 下面把完整做法分享給大家。 01. 用 AI 畫爆款 IP 頭像 安裝 Skill 我們打開豆包工作,在輸入框中輸入: 幫我安裝 GitHub 上的 ip-as-logo-skill 技能。 豆包工作會在 GitHub 上查找技能倉庫,確認來源和內容無誤後自動完成安裝。 調用 Skill 安裝成功後,我們輸入“/”,在彈出的技能列表中選擇 Ip as Logo。 Ip as Logo Skill 的精髓在於把設計的審美變成了可以執行的標準,如何構圖、輪廓、如何配色…還有專爲頭像優化的角落探頭構圖,保證縮到微信小圓圈裏依然一眼可認。 我們在輸入框喚出技能,讓豆包工作設計一隻三花貓的 IP 角色。 豆包工作會按照 Skill 的設計規範,列出三個不同的設計方向,供我們選擇。 我們確認設計方向後,豆包工作生成了一組小三花貓的 IP 頭像候選圖。 畫面極其乾淨,色塊分明,簡單的線條輪廓,貓咪萌萌的形象,非常可愛。 我們選中一個覺得不錯的 IP 形象,還可以繼續讓豆包工作生成變體。 定製自己的 Skill 有了核心 IP 頭像,日常運營還需要配套的視覺資產。 我們讓豆包工作基於剛剛生成的 IP 形象,繼續衍生日常打工表情包。 我們繼續讓豆包工作給圖片配上文字,並將字號、排版調整到合適比例。 調整到合適的比例之後,我們可以讓豆包把這一套製作標準打包成一個專屬 Skill。 豆包工作會自動將我們之前列出的要求提煉爲結構化 SOP,存入我們的技能庫,命名爲 sticker-pack。 定製好技能後,我們拿新角色驗證一下。先用 Ip as Logo 技能做出新頭像。 再調用表情包 Skill 生成表情,豆包工作會自動按照剛纔沉澱好的標準,一鍵輸出符合相同視覺規範的表情包! 原本繁瑣的長流程,兩句話搞定。 02. 一些分享 技能把某個專業領域的成熟經驗、流程規範和交付標準封裝成標準化 SOP,讓專業方法隨時被一鍵喚醒。 今天是畫 IP 頭像,明天可以是公衆號排版規範、財務報表清洗、行業週報撰寫、社媒數據分析。 通過補充不同技能,讓豆包工作可以幫我們完成更多專業工作。 經常使用的格式、標準和工作步驟可以沉澱下來,後續任務複用,減少每次從頭組織提示詞的負擔。 一個人也更容易推進完整項目。 網頁搜索下載豆包工作下載電腦端,最多可以領六十天會員,第一次可領取三十天,結束後可再領三十天。(已經下載過豆包工作,領過30天會員的友友們,到期後可以在電腦端內再領三十天) 原文鏈接:兩句話做出原創 IP,豆包工作這套玩法建議收藏
FLUX 3 Max – fal 與 Black Forest Labs 推出的視頻生成模型
FLUX 3 Max是什麼 FLUX 3 Max 是 fal Research 與 Black Forest Labs 聯合推出的後訓練視頻模型,支持文生視頻、圖生視頻與關鍵幀插值,可生成5–20秒、720p/1080p、帶原生音頻的視頻。FLUX 3 Max 主打極致速度,10秒成片約12秒生成,官方稱同畫質下比 Seedance 2.5 快22倍。 FLUX 3 Max的主要功能 文生視頻:一句話提示詞可生成 5–20 秒的完整視頻片段。 圖生視頻:輸入參考圖作爲起始幀,可選指定結束幀,實現首尾幀之間的受控生成。 音畫同步:原生生成配套音頻與人物口型對話,無需後期配音合成。 Draft 草稿模式:極低成本快速出預覽稿,確認後同提示詞一鍵渲染爲全質量成片。 極致速度:10 秒視頻約 12 秒生成,官方稱同畫質下比 Seedance 2.5 快 22 倍。 靈活輸出:720p/1080p 兩檔分辨率,通過 fal 等平台統一 API 調用。 FLUX 3 Max的技術原理 多模態統一底座:FLUX 3 Max 基於 Black Forest Labs 的 FLUX 3 基礎模型,後者將多模態生成與理解整合在同一底層架構中,圖像、視頻、音頻、文本共享一套表示空間,各模態能力互相增強。 Self-Flow 對齊方法:相比傳統 Flow Matching,Self-Flow 在各模態上的生成誤差更低,且經微調後在四組操控任務上的成功率更高,更易被精確控制。 後訓練效率特化:”Max”版本是 fal Research 與 BFL 在 FLUX 3 底座上做的後訓練版本,目標是推理效率:通過蒸餾等手段大幅減少採樣步數與計算開銷,在畫質基本無損的前提下把延遲壓低。 生態化推理部署:經 fal 統一 API 輸出,同時接入 Comfy、OpenRouter、Runware、HeyGen 等 17 家平台,配合 Draft 模式的先草稿後精修工作流,把創作端的試錯成本一併壓低。 如何使用FLUX 3 Max 打開入口:訪問 fal 官網,註冊或登錄賬號,或 Black Forest Labs 官網 https://bfl.ai/。 選擇模式:選文生視頻(純提示詞)、圖生視頻(上傳起始幀圖)或關鍵幀插值(首尾幀)。 輸入素材:文生視頻填寫提示詞,圖生視頻上傳圖片,可選配結束幀控制鏡頭走向。 設置參數:設定時長(5–20 秒)、分辨率(720p/1080p)及是否同步生成音頻。 先試草稿:用 Draft 模式跑一版低成本預覽,確認構圖和動作滿意後再渲染全質量成片。 API 接入:生產環境通過 fal 統一 API 調用(文檔見 fal.ai/docs),可走 Comfy、OpenRouter、Runware 等第三方接入。 FLUX 3 Max的核心優勢 質量第一梯隊:在獨立第三方 Artificial Analysis 圖生視頻榜單上並列第一(Elo 約 1138 分)。 價格最低檔:號稱同質量級別最便宜的前沿視頻模型。 音畫一體:原生同步生成音頻與口型對話,無需後期配音。 Draft 模式省成本:先低成本出預覽稿,確認後再渲染全質量,試錯費用大幅壓縮。 輸入靈活:支持文生視頻、圖生視頻、首尾關鍵幀插值三種工作流。 FLUX 3 Max的項目官網 項目地址:https://bfl.ai/models/flux-3-video#flux-3-max FLUX 3 Max的同類競品對比 對比維度 FLUX 3 Max MiniMax H3 產品定位 前沿模型的速度特化版,主打”最快” 通用音畫生成旗艦,主打”最全” 生成時長 5–20 秒 4–15 秒 分辨率 720p / 1080p 直出 768p 直出,2K 需二次再生 音頻能力 原生音頻 + 人物對話 原生 32kHz 立體聲 + 口型同步 生成速度 10 秒視頻約 12 秒生成 標準隊列速度(快版需選 H3 Max 變體) 榜單表現 圖生視頻並列第一(約 1138 Elo) 圖生視頻約 1140 Elo,略壓一頭 參考輸入 圖片、首尾關鍵幀 多模態參考:最多 9 圖 + 3 視頻 + 3 音頻 開放權重 否,僅 API 是,H3-Base 已上傳 Hugging Face FLUX 3 Max的應用場景 電商與虛擬試穿:上傳商品圖或模特圖生成動態展示視頻,替代傳統拍攝做詳情頁和廣告素材。 廣告與品牌營銷:Logo 動態演繹、產品質感鏡頭一鍵生成,品牌方無需傳統制作週期即可上新 campaign。 影視分鏡與預演:劇本文字直接轉動態分鏡,導演
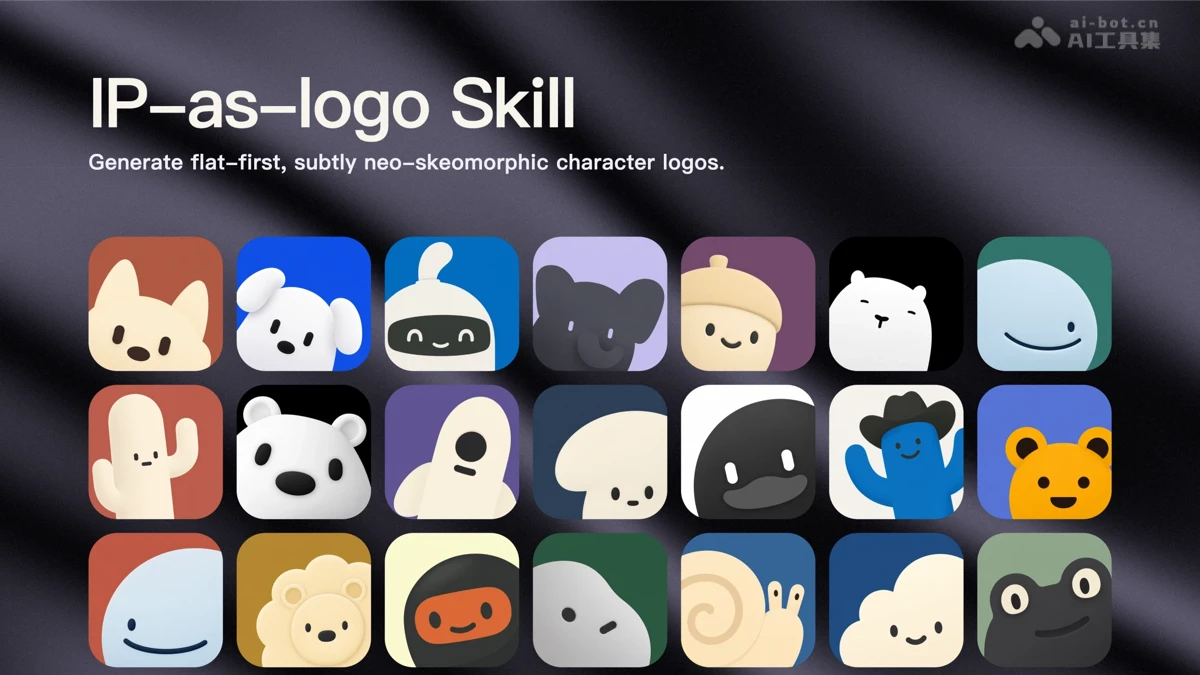
ip-as-logo-skill – 開源的 Agent Skill,能生成 IP 吉祥物頭像
ip-as-logo-skill是什麼 ip-as-logo-skill 是開源的 Agent Skill,用於生成極簡可愛的 IP 吉祥物頭像。ip-as-logo-skill 用 4–7 個圓潤幾何形狀構成清晰輪廓,配合”兩主色+一背景”的三色約束,讓角色縮小到 32×32 仍能辨認。流程是先出 3 個設計方向,確認後生成 6 張候選圖。ip-as-logo-skill 需搭配 Codex、豆包等兼容 Agent 及 GPT Image 2 等頂級圖像模型使用,MIT 協議可商用。 ip-as-logo-skill的主要功能 極簡輪廓生成:用 4–7 個大幾何形狀構建圓潤角色輪廓,確保縮小到 32×32 像素仍可辨認。 三色約束:默認用兩個角色主色加一個純色背景,減少視覺干擾。 方向提案:給出 3 個設計方向,未定角色時優先推薦常見動物並關聯產品屬性。 批量出圖:確認方向後生成 6 張獨立方圖,左右下角構圖各佔一半。 原樣交付:所有結果一次性返回,不篩選、不自動重試,由用戶挑選後再修改。 構圖控制:角色從左下或右下角探出,佔據畫面 85–95%,保持視覺主導。 模型適配:自動檢查是否接入 GPT Image 2 等頂級圖像模型,不足時提示用戶開啓或提供 API Key。 提示詞淨化:生成提示中刻意隱藏 logo、icon 等用途詞彙,避免模型輸出僵硬圖標風。 微信關注回覆“開源”,加入AI開源項目交流羣 如何使用ip-as-logo-skill 安裝 Skill:運行 npx skills@latest add s1dashu/ip-as-logo-skill。 選擇智能體:按安裝提示選擇 Codex、豆包、Coze、Manus 等兼容的 Agent。 確認圖像模型:確保 Agent 已接入 GPT Image 2、Nano Banana Pro 等頂級圖像模型,按提示開啓或填寫 API Key。 描述需求:告知角色用途、受衆、性格和最關鍵的辨識特徵。 挑選方向:查看 AI 給出的 3 個設計方向,確認全部保留或只選其一。 審閱修改:從結果中挑選滿意的圖,或明確提出修改要求讓 AI 再出一批。 裁切測試:用於頭像場景時,把成品放進圓形裁切框檢查耳朵、表情等關鍵特徵是否被遮擋。 ip-as-logo-skill的核心優勢 小尺寸高辨識:用 4–7 個圓潤大形狀構建輪廓,角色縮小到 32×32 頭像場景依然清晰可認。 設計約束明確:嚴格的”三色+單特徵”規則,避免 AI 越畫越花,方案之間更容易比較。 流程先方向後出圖:給 3 個設計方向再批量生成,減少盲目抽卡式試錯。 結果零損耗交付:所有候選圖原樣保留、不自動篩選或重試,用戶掌握完全選擇權。 提示詞工程成熟:隱藏 logo/icon 等用途詞彙、直接命名背景色,引導模型輸出更自然的角色圖。 生態兼容廣泛:支持 Codex、豆包、Coze、Manus、Gemini 等多種 Agent,不綁定單一產品。 ip-as-logo-skill的項目地址 GitHub倉庫:https://github.com/s1dashu/ip-as-logo-skill ip-as-logo-skill的同類競品對比 對比維度 ip-as-logo-skill SanbaoAI/logo-generator-skill 產品定位 極簡、可愛、小尺寸可辨識的 IP 角色頭像 完整品牌視覺識別系統(VI),含 Logo、品牌規範板 技能結構 單一 Skill(一份 SKILL.md) 三個模塊化 Skill:base-logo、mascot-logo、colorway 輸出形態 6 張獨立方圖,角色從角落探出 品牌系統規範板(含主 Logo、favicon、印章、黑白應用等編號模塊) 設計目標 32×32 像素下仍可辨認,優先”像角色” 可註冊、可縮放的扁平商標剪影,優先”像商標” 複雜度策略 4–7 個大形狀 + 嚴格三色約束,偏圓潤可愛 從動物/角色中提取單一識別特徵(爪子、鹿角等)做扁平化 色彩規則 默認固定三語義色,壓低背景飽和度 支持多色系,另有專門的 colorway 配色 Skill 做場景化換色 圖像模型要求 強制頂級圖像模型(GPT Image 2 等),絕不回退 SVG 無圖像工具時直接輸出提示詞,可粘貼到 Midjourney、Flux、Ideogram 使用 使用場景 頭像、吉祥物快速探索,輕量需求 創業公司/品牌的完整視覺體系,重度需求 成熟度 5.9k stars,社區熱度高 相對小衆,但流程更完整 ip-as-logo
LOGOS – 阿里開源的首個統一科學大模型
LOGOS是什麼 LOGOS(Language...
9個免費好用的AI Logo生成器,智能設計專業的品牌標誌
一個好的標誌,往往能傳達出...