最好用的AI工具
搜尋:Kimi
17 個結果
Beam – Reflection AI 開源的首款大語言模型
Beam是什麼 Beam 是 Reflection AI 推出的首款開源大語言模型,採用 501B 參數的稀疏 MoE 架構,每 token 僅激活 23B,支持 100 萬 token 上下文,預訓練消耗 23.8T token。Beam 的訓練過程堪稱重工業級別的算力展示,預訓練用 6,144 張 GB300 不到四周跑完,用 10,500 張 GB300 進行爲期四周、超 1 億次 rollout 的大規模強化學習。 Beam的主要功能 編程開發:在軟件工程任務上達到 GLM-5.2 同級水平,是面向企業編碼負載的主力模型。 Agent 執行:具備工具調用、終端操作、網頁搜索等能力,可自主完成多步任務,甚至學會調用其他大模型和 OCR API。 長文本處理:支持 100 萬 token 上下文,能從超長代碼庫和文檔中定位並關聯關鍵信息。 可調推理強度:用戶通過 reasoning effort 參數在短回覆與長推理之間靈活切換,匹配不同任務和算力預算。 Beam的技術原理 稀疏 MoE 架構:模型總參數 501B,但每次只激活 23B,通過細粒度路由專家配合輔助損失無關的負載均衡實現近均勻的專家利用率,最忙專家負載僅 1.04×,是 Beam 推理高效的硬件級基礎。 兩階段大規模訓練:預訓練在 6,144 張 GB300 上用不到四周消化 23.8T token,配合拓撲感知調度器和靜默數據損壞檢測,goodput 達 92.3%;之後用 10.5K 張 GB300 做四周強化學習,產生超 1 億次 rollout,期間平均維持 11 萬併發 rollout 和 17 萬併發沙盒。 全異步 RL 系統:採用異步 policy gradients,支持 rollout 與訓練並行,通過給每個 token 標記生成它的模型版本處理策略陳舊問題,即使樣本落後當前策略一天(107 個版本)數值依然穩定;新權重經 RoCE 分層分發到推理集羣僅需中位數 12 秒。 長度可控的推理學習:在 RL 中加入長度懲罰項,讓模型先學會用更少 token 解題、再在 agentic 能力增強後自然擴展推理長度,形成能力-token 消耗的最優權衡,由用戶按需調節。 微信關注回覆“開源”,加入AI開源項目交流羣 如何使用Beam 當前階段權重未放出,僅向部分用戶提供預覽版,訪問 https://platform.reflection.ai/ 可申請早期體驗。 Beam的核心優勢 推理效率極高:用 3–4 倍低於 GLM-5.2 的推理算力達到同級推理水平,比 Qwen 3.8-Max 等 2T+ 模型節省更多,智能密度突出。 激活參數極小:501B 總參中每 token 僅激活 23B,稀疏 MoE 設計大幅壓低部署和推理成本。 RL 規模業界罕見:10.5K 張 GB300 連續四周、超 1 億次 rollout,是開放實驗室中迄今最大規模的 RL 訓練之一。 訓練穩定性強:預訓練全程僅 9 次半自動回滾、goodput 達 92.3%,訓練曲線無失穩,工程成熟度極高。 推理長度可控:用戶可通過 reasoning effort 參數自由調節推理深度,在性能與成本間按需權衡。 Beam的項目地址 項目官網:https://reflection.ai/blog/introducing-beam Beam的同類競品對比 維度 Beam(Reflection AI) GLM-5.2(Z.ai / 智譜) 總參數 / 激活參數 501B / 23B 744B / 40B 激活佔比 約 4.6%(更稀疏) 約 5.4% 上下文窗口 1M tokens 1M tokens 預訓練數據量 23.8T tokens 28.5T tokens 架構特點 細粒度 MoE + 輔助損失無關負載均衡,52 層殘差流全程穩定 MoE + MLA + 稀疏注意力(DSA/IndexShare),78 層(前 3 層稠密) 後訓練 10.5K 張 GB300 跑 4 周 RL,超 1 億次 rollout,異步 policy gradients slime 異步 RL 基礎設施,長程 agentic 訓練 能力定位 對標 GLM-5.2,官方承認落後 Kimi K3,優勢在推理效率 開源模型推理/編程最強檔,GPQA Diamond 89%,SWE-bench Pro 62.1% 推理效率 達到同級推理水平僅用 GLM-5.2 約 1/3–1/4 算力 基準參照物,40B 激活已屬高效 許可協議 Apache 2.0 MIT 開源權重(已可下載) 當前可用性 wait
M3.1-Flash-Preview – MiniMax 推出的最新文本編程模型
M3.1-Flash-Preview是什麼 M3.1-Flash-Preview 是 MiniMax 推出的最新文本模型,首發上線 MiniMax Code。M3.1-Flash-Preview 面向日常開發場景,支持原生多模態輸入和百萬級上下文,可從 Bug 修復到完整功能開發形成定位→實現→測試→交付閉環。M3.1-Flash-Preview提供 low 至 max 五檔推理強度控制。目前僅限 MiniMax Code 和 Token Plan 使用。 M3.1-Flash-Preview的主要功能 日常開發交付:從 Bug 修復到完整功能開發均可穩定交付,可靠覆蓋日常編碼需求。 需求深度理解:能深入理解開發需求,細緻處理各種邊界情況。 迴歸測試補齊:自動生成並補齊迴歸測試用例,保障代碼質量。 改動影響驗證:可驗證代碼改動對現有功能的影響,降低迴歸風險。 原生多模態輸入:支持文本、圖像、視頻等多種輸入形式,理解更直觀。 百萬級上下文窗口:可處理超大代碼庫和長文檔,適合大型項目分析。 五檔推理強度控制:提供 low 至 max 五檔 Effort 調節,平衡速度與深度。 開發閉環支持:形成問題定位→代碼實現→測試驗證→成果交付的完整開發流程。 M3.1-Flash-Preview的技術原理 MoE + 稀疏注意力底座:繼承 M3 的 428B 總參、每 token 僅激活約 23B 的稀疏混合專家架構,核心是自研 MSA,通過 KV 分塊和動態選擇相關塊替代全量注意力,將百萬級上下文的計算量壓縮至前代的約 1/20,實現長文本下的高速推理。 全稀疏化改造:M3 前三層的全注意力錨點層被替換爲 MSA 稀疏層,每個 token 只關注上下文的選定子集,消除模型中最後的全注意力計算瓶頸,進一步降低長序列處理成本。 激進量化壓縮:採用 Q8KV4 混合精度 KV Cache和 W4A4 NVFP4 專家量化,KV 緩存內存約爲 M3 的一半,顯著降低顯存佔用。 投機解碼加速:用 DSpark 投機解碼頭取代 M3 的 EAGLE 多頭預測頭,由高效小模型先”猜測”token、大模型並行驗證,大幅提升生成吞吐。 如何使用M3.1-Flash-Preview 下載安裝 MiniMax Code:訪問 MiniMax Code 官網下載對應系統版本並完成安裝。 註冊/登錄賬號:打開客戶端,用 MiniMax 賬號登錄。 選擇模型開始對話:在模型選擇器中切換至 M3.1-Flash-Preview,按需調整推理強度(low 至 max 五檔)。 輸入開發任務:用自然語言描述需求,M3.1-Flash-Preview 會完成定位、實現、測試驗證並交付代碼。 M3.1-Flash-Preview的核心優勢 開發全流程閉環:從問題定位、代碼實現到測試驗證、成果交付一站式完成,覆蓋日常開發全場景。 邊界情況處理細緻:能深入理解需求並妥善處理各種邊界條件,交付質量穩定可靠。 極速響應:約 280ms 首字延遲、126 tokens/秒 生成速度,輕量任務體驗接近瞬時。 超長上下文:支持百萬級上下文窗口,可一次性處理大型代碼庫和長文檔。 原生多模態:支持文本、圖像、視頻輸入,需求理解更直觀準確。 推理強度可調:low 至 max 五檔 Effort 控制,可按任務複雜度平衡速度與深度。 成本極低:MoE + MSA 稀疏架構配合激進量化,token 消耗和算力成本大幅低於同檔模型。 M3.1-Flash-Preview的同類競品對比 維度 M3.1-Flash-Preview(MiniMax) Kimi K2.7 Code(月之暗面) 架構 MoE(繼承 M3 底座,官方未公佈規格) 1T 總參 / 32B 激活 MoE,MLA 注意力 上下文窗口 100 萬 token 256K token 推理強度 low / medium / high / xhigh / max 五檔 鎖定思維模式,不可關閉 首字延遲 約 280ms(Low 檔 210ms) 未公開,以長思考爲主 輸出速度 約 126 tokens/秒 有高速版(kimi-for-coding-highspeed),輸出提升 5-6 倍 多模態 文本 / 圖像 / 視頻輸入 文本 / 圖像 / 視頻輸入(MoonViT) M3.1-Flash-Preview的應用場景 日常 Bug 修復:針對報錯日誌和代碼片段快速定位問題根因,Medium 檔可在 320ms 首字延遲內完成邊界條件檢查並給出修復方案,適合高頻迭代的敏捷開發。 完整功能開發:從需求描述到可運行代碼的全流程交
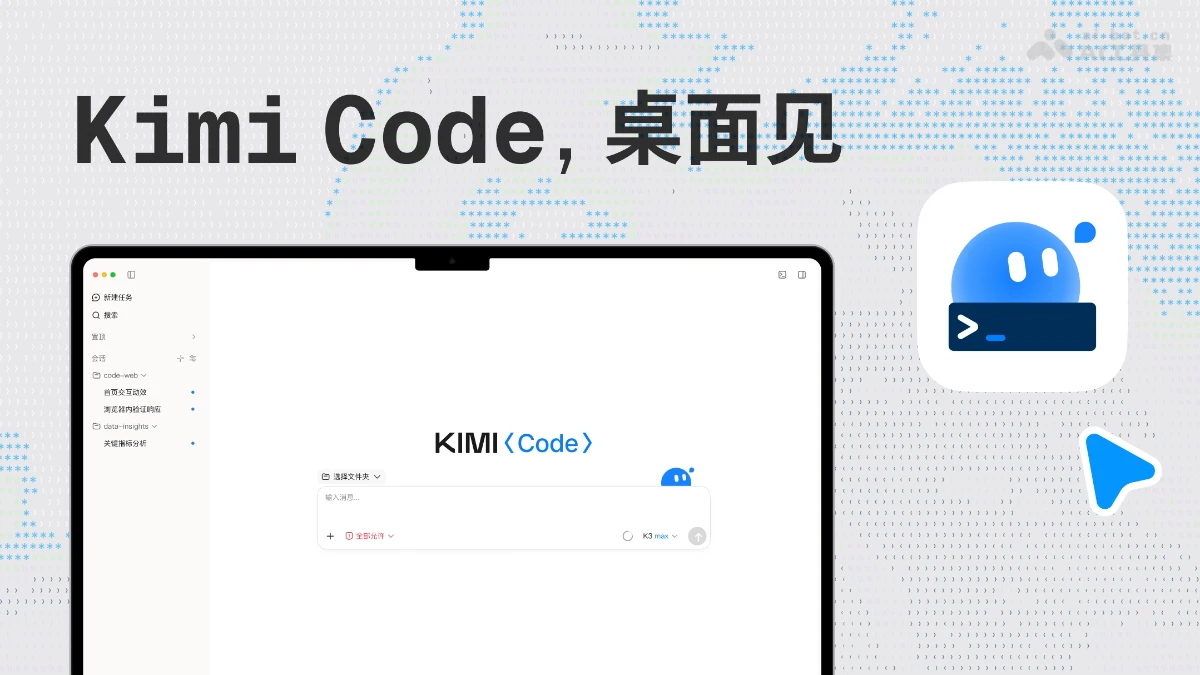
Kimi Code Desktop – Kimi 推出的 Kimi Code 桌面客戶端
Kimi Code Desktop是什麼 Kim...
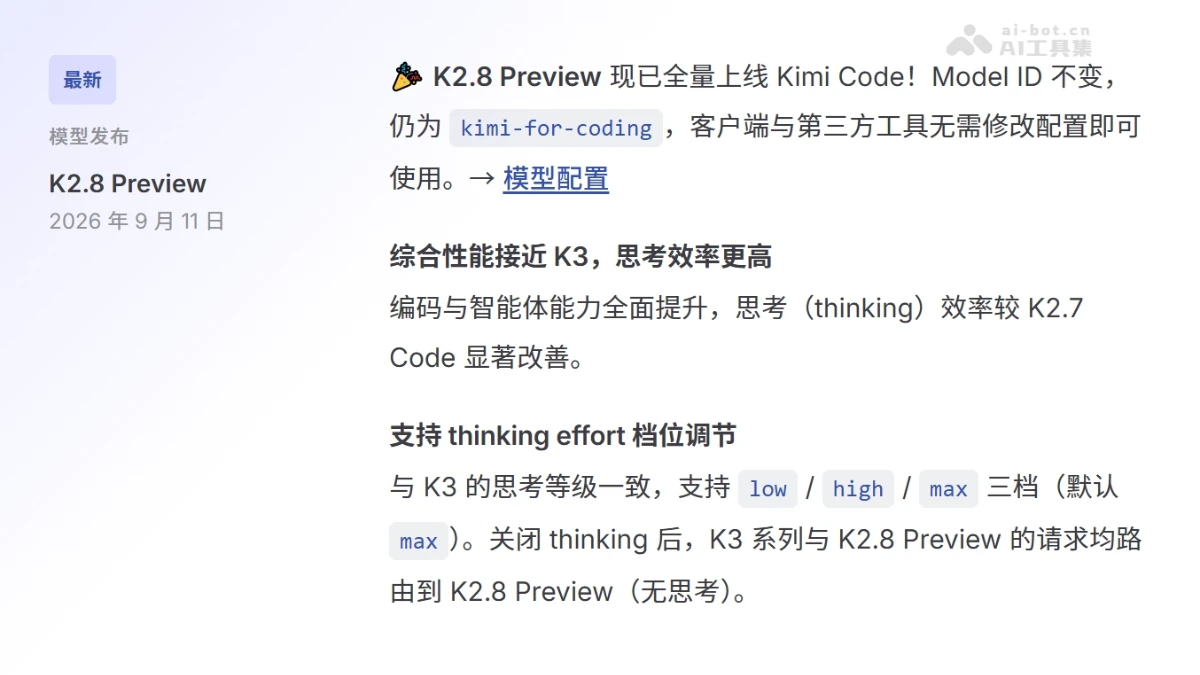
K2.8 Preview – 月之暗面 Kimi 推出的新一代主力模型
K2.8 Preview是什麼 Kimi K2....
Kimi K3 深度評測 – 前端開發能力登頂全球第一
昨晚,月之暗面悄悄上線了新...
Kimi K3 – 月之暗面推出的 2.8 萬億參數開源大模型
Kimi K3是什麼 Kimi K3 是月...
Codex 怎麼用國產模型?Kimi + CC Switch 接入配置指南
最近 Claude 又開始大面積封...
Kimi K2.7 Code 深度實測 – 代碼生成能力全解析
朋友們,Kimi 又更新了。 這...
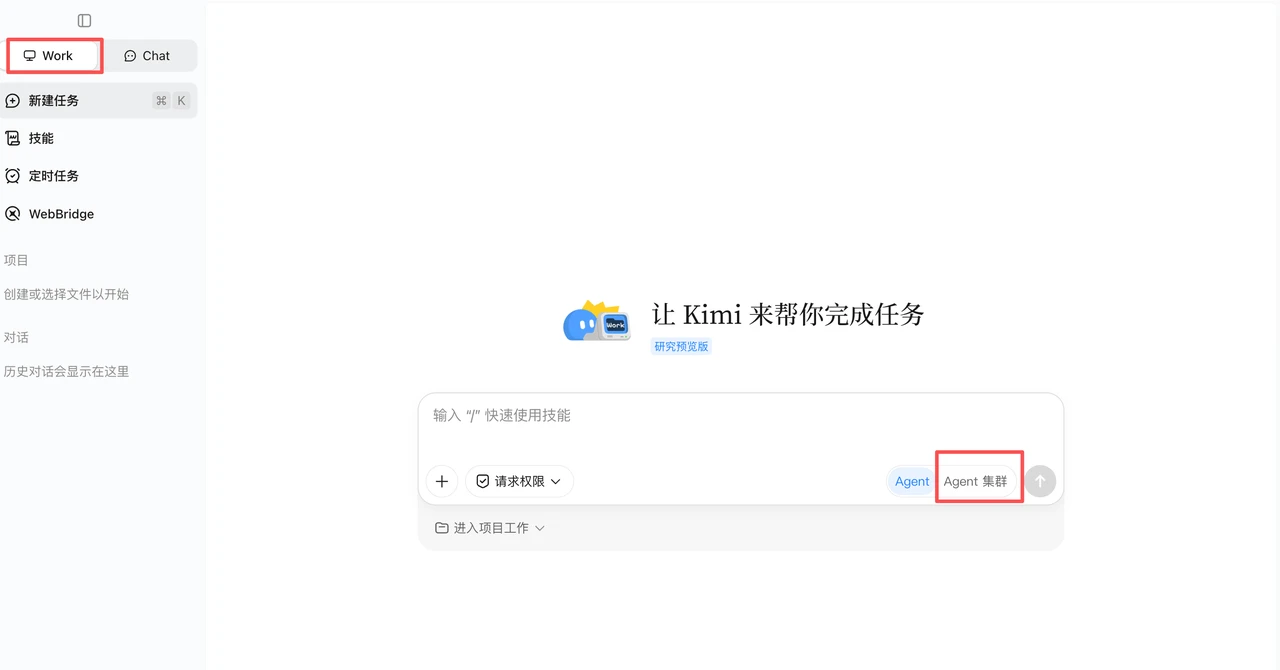
Kimi Work 媒介投放實戰 – Agent集羣自動抓取數據與分析
做過營銷投放的友友都知道,...
Kimi Work – 月之暗面推出的通用型本地 Agent
Kimi Work是什麼 Kimi Work ...
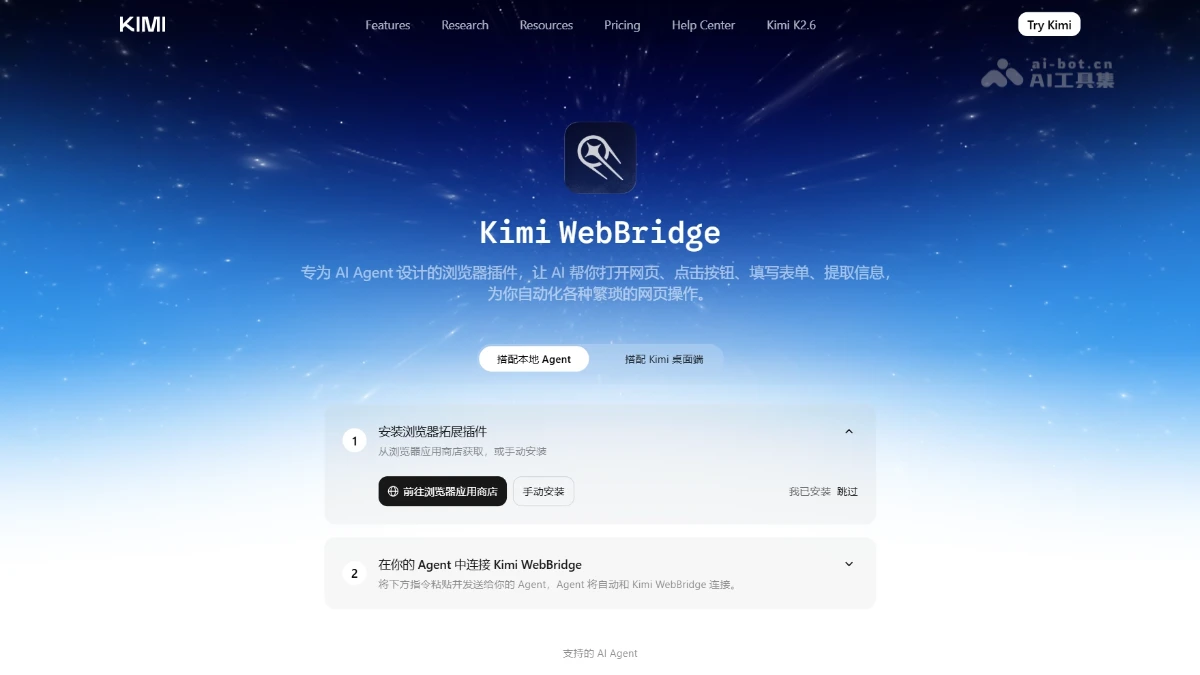
Kimi WebBridge – 月之暗面推出的瀏覽器擴展插件
Kimi WebBridge是什麼 Kimi W...
Kimi K2.6 實測:AI 一鍵生成精美網頁,媲美專業設計師
我去年給自己做個人品牌官網...
Kimi K2.6 – 月之暗面開源的最新旗艦模型
Kimi K2.6是什麼 Kimi K2.6 ...
Kimi“新PPT助手” ,Kimi全新自研的免費AI生成PPT助手
前段時間給大家分享了一期用...
Kimina-Prover – 月之暗面聯合 Numina 推出的數學定理證明模型
Kimina-Prover是什麼 Kimina-...
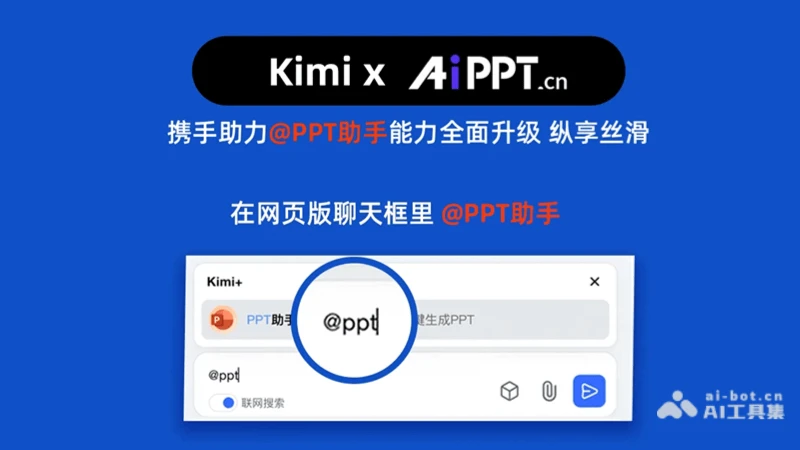
Kimi PPT助手 – Kimi聯合AiPPT推出一鍵生成PPT服務
Kimi PPT助手是什麼 Kimi PPT...
Kimi瀏覽器插件 – 月之暗面推出的官方Kimi瀏覽器助手
Kimi瀏覽器插件是什麼 Kimi瀏...