最好用的AI工具
搜尋:GLM-5
14 個結果
GLM-Legal – 智譜推出的法律專用大模型
GLM-Legal是什麼 GLM-Legal是智譜推出的法律專用大模型,基於輕量級基座GLM-5.3-Flash,經法律領域中間訓練與強化學習後訓練打造。GLM-Legal覆蓋閱讀材料—提取事實—分析法律關係—制定建議—生成專業文件的完整工作流,支持合同審查、證據分析、法律研究、合規規劃等任務。官方評測中,Harvey LAB全項通過率達19.2%,LegalBench、PLawBench持平前沿閉源模型。 GLM-Legal的主要功能 合同審查:分析合同條款風險,站在客戶立場提出具體可執行的修改建議。 證據分析:批量閱讀案件材料,找出證據間的矛盾與關鍵事實,引用來源編號並區分事實與推論。 法律研究:結合案件事實與法律規則形成有依據的分析結論,輸出可供律師審查的專業意見。 合規工作:針對跨境業務梳理各法域合規義務,輸出分優先級的落地清單並附具體法條引用。 專業文件生成:按法律工作規範組織分析、意見或修改方案,交付可直接使用的工作成果。 AutoClaw 集成:接入桌面 Agent 平台後,可在 Word 中修訂模式和批註直接呈現合同修改內容。 GLM-Legal的技術原理 輕量基座 + 領域縮放:模型構建於 GLM-5.3-Flash 之上,通過擴展高質量法律語料的中間訓練建立法律概念、法規規則和解釋框架的系統性知識底座,用小參數規模換取接近前沿模型的領域能力。 模型與 Harness 協同進化:後訓練階段在數萬個真實法律任務環境中做強化學習;Harness 作爲運行時編排框架管理任務上下文、工具調用與執行反饋,模型訓練暴露的邊界問題反哺 Harness 架構改進,架構改進又使模型適應真實執行約束,二者雙向迭代。 生產反饋閉環:由執業律師按”問題覆蓋、論證有據、格式合規、零返工”等標準評審實際輸出,將主觀質量轉化爲具體工程損失信號,回灌到任務環境、評測標準與 Harness 設計中,形成”實踐需求—訓練—驗證”的持續優化循環。 如何使用GLM-Legal 申請訪問:前往 https://z.ai/consultation/legal 提交 Beta 申請。 等待審覈:等待智譜審覈通過並獲得 API 訪問權限。 選擇使用方式:開發者調用 API 集成到自己的法律工作流,普通用戶可下載 AutoClaw 桌面端。 佈置任務:向模型提供任務簡報和相關源文件,明確交付格式要求。 獲取成果:模型自動完成閱讀、分析、推理並輸出專業文件(。 人工複覈:由執業律師審查輸出質量,確認無誤後交付客戶或用於談判。 GLM-Legal的核心優勢 端到端任務執行:覆蓋閱讀材料→提取事實→分析法律關係→制定建議→生成文件的完整工作流。 評測成績過硬:Harvey LAB 全項通過率達 19.2%(較基座提升 12.5 個百分點),LegalBench、PLawBench 持平前沿閉源模型,且由 Vals 獨立評估。 參數小、成本低:用輕量級 GLM-5.3-Flash 爲基座達到前沿水平,推理效率高,部署和使用成本更低。 交付即用的成果:輸出嚴格遵循任務簡報的專業文件,下游團隊無需返工即可直接使用。 證據級嚴謹性:分析中引用來源文件編號,區分事實與推論,論證和引用均可追溯覈驗。 GLM-Legal的項目地址 項目官網:https://z.ai/blog/glm-legal GLM-Legal的同類競品對比 對比維度 GLM-Legal Harvey 模型路線 自研輕量基座 GLM-5.3-Flash + 法律領域訓練,主打推理成本 基於 GPT 等第三方前沿大模型構建法律 Agent 套件 評測表現 Harvey LAB 全項通過率 19.2%(較基座 +12.5pp),LegalBench/PLawBench 持平前沿閉源模型 Harvey LAB 的出題方,自家產品在該基準的具體分數未公開 核心能力 合同審查、證據分析、法律研究、合規規劃、專業文件生成 端到端法律工作流(研究、起草、審查),覆蓋大型律所場景 交付形態 API + AutoClaw 桌面 Agent,可在 Word 中輸出修訂模式 獨立 SaaS 平台,深度集成 Microsoft Word / 律所繫統 語言與市場 中英雙語均衡,PLawBench 驗證中國法律實務能力 以英美法系英語市場爲主 GLM-Legal的應用場景 合同審查與談判支持:審查軟件服務等各類合同,站在客戶立場識別風險條款,輸出具體修改建議並直接在 Word 中以修訂模式呈現,供談判使用。 訴訟證據分析與案件準備:批量閱讀數十份案件文檔,構建證據矛盾地圖(如外部進度報告 vs 內部真實記錄的矛盾),引用來源
Beam – Reflection AI 開源的首款大語言模型
Beam是什麼 Beam 是 Reflection AI 推出的首款開源大語言模型,採用 501B 參數的稀疏 MoE 架構,每 token 僅激活 23B,支持 100 萬 token 上下文,預訓練消耗 23.8T token。Beam 的訓練過程堪稱重工業級別的算力展示,預訓練用 6,144 張 GB300 不到四周跑完,用 10,500 張 GB300 進行爲期四周、超 1 億次 rollout 的大規模強化學習。 Beam的主要功能 編程開發:在軟件工程任務上達到 GLM-5.2 同級水平,是面向企業編碼負載的主力模型。 Agent 執行:具備工具調用、終端操作、網頁搜索等能力,可自主完成多步任務,甚至學會調用其他大模型和 OCR API。 長文本處理:支持 100 萬 token 上下文,能從超長代碼庫和文檔中定位並關聯關鍵信息。 可調推理強度:用戶通過 reasoning effort 參數在短回覆與長推理之間靈活切換,匹配不同任務和算力預算。 Beam的技術原理 稀疏 MoE 架構:模型總參數 501B,但每次只激活 23B,通過細粒度路由專家配合輔助損失無關的負載均衡實現近均勻的專家利用率,最忙專家負載僅 1.04×,是 Beam 推理高效的硬件級基礎。 兩階段大規模訓練:預訓練在 6,144 張 GB300 上用不到四周消化 23.8T token,配合拓撲感知調度器和靜默數據損壞檢測,goodput 達 92.3%;之後用 10.5K 張 GB300 做四周強化學習,產生超 1 億次 rollout,期間平均維持 11 萬併發 rollout 和 17 萬併發沙盒。 全異步 RL 系統:採用異步 policy gradients,支持 rollout 與訓練並行,通過給每個 token 標記生成它的模型版本處理策略陳舊問題,即使樣本落後當前策略一天(107 個版本)數值依然穩定;新權重經 RoCE 分層分發到推理集羣僅需中位數 12 秒。 長度可控的推理學習:在 RL 中加入長度懲罰項,讓模型先學會用更少 token 解題、再在 agentic 能力增強後自然擴展推理長度,形成能力-token 消耗的最優權衡,由用戶按需調節。 微信關注回覆“開源”,加入AI開源項目交流羣 如何使用Beam 當前階段權重未放出,僅向部分用戶提供預覽版,訪問 https://platform.reflection.ai/ 可申請早期體驗。 Beam的核心優勢 推理效率極高:用 3–4 倍低於 GLM-5.2 的推理算力達到同級推理水平,比 Qwen 3.8-Max 等 2T+ 模型節省更多,智能密度突出。 激活參數極小:501B 總參中每 token 僅激活 23B,稀疏 MoE 設計大幅壓低部署和推理成本。 RL 規模業界罕見:10.5K 張 GB300 連續四周、超 1 億次 rollout,是開放實驗室中迄今最大規模的 RL 訓練之一。 訓練穩定性強:預訓練全程僅 9 次半自動回滾、goodput 達 92.3%,訓練曲線無失穩,工程成熟度極高。 推理長度可控:用戶可通過 reasoning effort 參數自由調節推理深度,在性能與成本間按需權衡。 Beam的項目地址 項目官網:https://reflection.ai/blog/introducing-beam Beam的同類競品對比 維度 Beam(Reflection AI) GLM-5.2(Z.ai / 智譜) 總參數 / 激活參數 501B / 23B 744B / 40B 激活佔比 約 4.6%(更稀疏) 約 5.4% 上下文窗口 1M tokens 1M tokens 預訓練數據量 23.8T tokens 28.5T tokens 架構特點 細粒度 MoE + 輔助損失無關負載均衡,52 層殘差流全程穩定 MoE + MLA + 稀疏注意力(DSA/IndexShare),78 層(前 3 層稠密) 後訓練 10.5K 張 GB300 跑 4 周 RL,超 1 億次 rollout,異步 policy gradients slime 異步 RL 基礎設施,長程 agentic 訓練 能力定位 對標 GLM-5.2,官方承認落後 Kimi K3,優勢在推理效率 開源模型推理/編程最強檔,GPQA Diamond 89%,SWE-bench Pro 62.1% 推理效率 達到同級推理水平僅用 GLM-5.2 約 1/3–1/4 算力 基準參照物,40B 激活已屬高效 許可協議 Apache 2.0 MIT 開源權重(已可下載) 當前可用性 wait
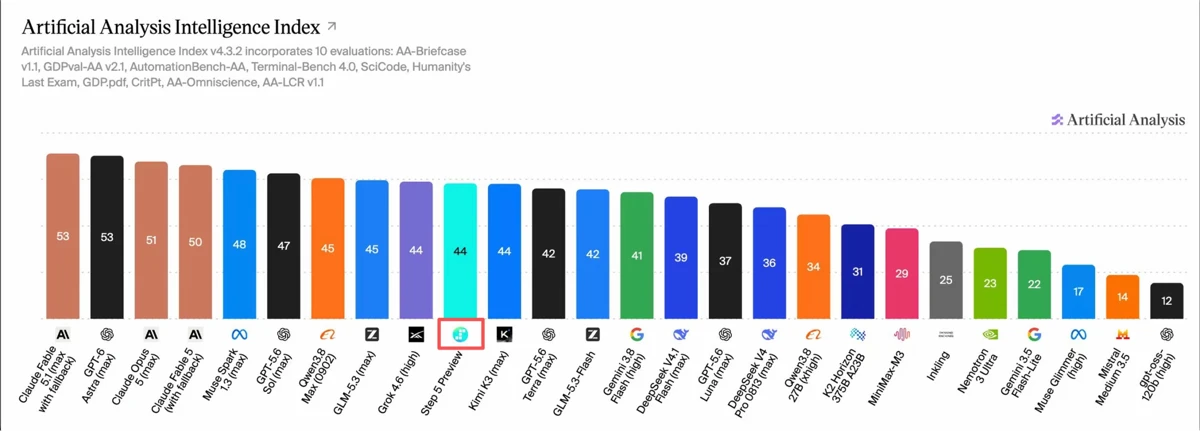
Step 5 Preview vs Claude Opus 5 vs GLM-5.3六大場景橫評
階躍星辰發佈了新模型 Step 5...
GLM-5.3-FlashX – 智譜推出的高速推理模型
GLM-5.3-FlashX是什麼 GLM-5.3-FlashX 是智譜推出的高速推理模型,輸出速度最高 200 tokens/s,較 GLM-5.3-Flash 提速 5 倍、提價 2.5 倍,API 已開放。模型基於 10 萬張國產芯片算力,推理基礎設施由 GLM-5.3 驅動的 Agent 在兩週內自動構建完成,端到端吞吐達初始基線 3 倍。模型主打同尺寸最強智能、極高性價比,形成智能、價格、速度的全面競爭力,適用於對延遲敏感的實時交互與 Agent 高頻調用場景。 GLM-5.3-FlashX的主要功能 高速文本生成:輸出速度最高 200 tokens/s,較 GLM-5.3-Flash 提速 5 倍。 對話補全 API:通過 bigmodel.cn 開放標準 API,Model Key 爲 GLM-5.3-FlashX。 在線體驗:官網體驗中心提供可視化試用入口,無需部署即可測試。 實時 Agent 交互:低延遲特性適配高頻調用、流式輸出的智能體應用場景。 高性價比推理:在保持同尺寸最強智能的同時,以 2.5 倍價格提供 5 倍速度。 GLM-5.3-FlashX的技術原理 國產芯片推理算力底座:模型運行在 10 萬張國產芯片組成的推理集羣上,通過 Infra 側的持續投入與推理優化,保障大規模併發下的高速穩定輸出。 Agent 驅動的 Infra 構建:整套推理系統由 GLM-5.3 驅動的 Agent 自動構建,人類負責定目標、設邊界和審覈關鍵修改,Agent 自主完成測試、日誌分析、Trace 排查與代碼優化,形成「稠密反饋」閉環,不到兩週即實現端到端吞吐 3 倍提升。 精度修復保障長上下文穩定:針對 KDA 的 CP 路徑,修復了 FP32 輸入默認走 TF32 計算導致的誤差累積問題,通過顯式設置 input_precision="tf32x3" 提升長上下文精度,修復已回饋至 Flash Linear Attention 上游。 KV Transfer 併發優化:定位到 DeepEP v1.2.1 的 C++ 調用未釋放 GIL、阻塞 Python 側 Mooncake Transfer 線程的問題,修復後 Prefill 加傳輸與單獨 Prefill 的性能差距從 20% 以上降至 1% 以內。 KDA Decode 算子去冗餘:將沿 V 維度分塊導致的四遍重複 FP32 歸一化與門控計算合併到同一線程塊,批量預計算並共享中間結果,算子性能提升至優化前的 1.71 倍。 如何使用GLM-5.3-FlashX 註冊賬號:API調用網址 https://docs.bigmodel.cn/api-reference/,註冊並登錄賬號。 獲取 API Key:在控制檯創建並複製你的 API 密鑰。 確認模型名稱:調用時使用 Model Key GLM-5.3-FlashX。 API 調用:參考官方文檔(對話補全接口),將請求中的 model 字段設爲 GLM-5.3-FlashX 併發送請求。 在線體驗(可選):訪問體驗中心 https://www.bigmodel.cn/trialcenter/modeltrial/visual?modelCode=glm-5.3-flashx,免部署直接試用。 接入應用:將 API 集成到你的應用或 Agent 工作流中,利用其 200 tokens/s 的高速輸出處理實時交互場景。 GLM-5.3-FlashX的核心優勢 極致速度:輸出速度最高 200 tokens/s,較 GLM-5.3-Flash 提速 5 倍。 智能不妥協:長期保持同尺寸最強智能水平,提速不以犧牲模型能力爲代價。 高性價比:以 2.5 倍價格換取 5 倍速度,單位智能成本反而更低。 國產算力底座:基於 10 萬張國產芯片推理集羣,供應鏈自主可控。 Agent 構建的 Infra:推理系統由 GLM-5.3 驅動的 Agent 不到兩週自動建成,端到端吞吐達基線 3 倍,迭代效率遠超傳統人工優化。 工程深度優化:通過修復 TF32 精度偏差、GIL 阻塞、重複計算等問題,實現算子級性能躍升(KDA Decode 算子提升 1.71 倍)。 GLM-5.3-FlashX的同類競品對比 維度 GLM-5.3-FlashX DeepSeek-V4-Flash 輸出速度 200 tokens/s(顯式標稱,主打賣點) 官方未標稱具體數值,實測爲高吞吐檔 價格 Flash 的 2.5 倍(絕對價未公佈,按 GLM-5 系定價推算居中檔) $0.14 / $0.28 每百萬 tokens(約 ¥1 / ¥2),爲 Flash 檔價格屠
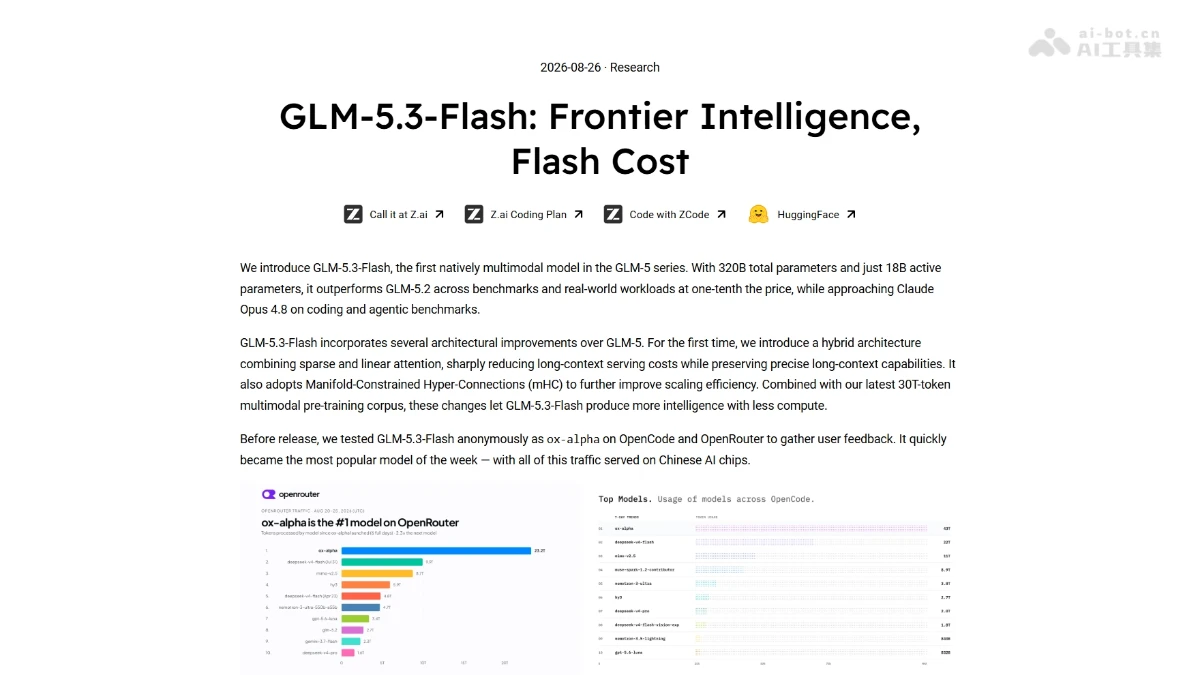
智譜 GLM-5.3-Flash 深度實測 – AI 編程能力憑國產芯片登頂
今天發點模型實測相關的東西...
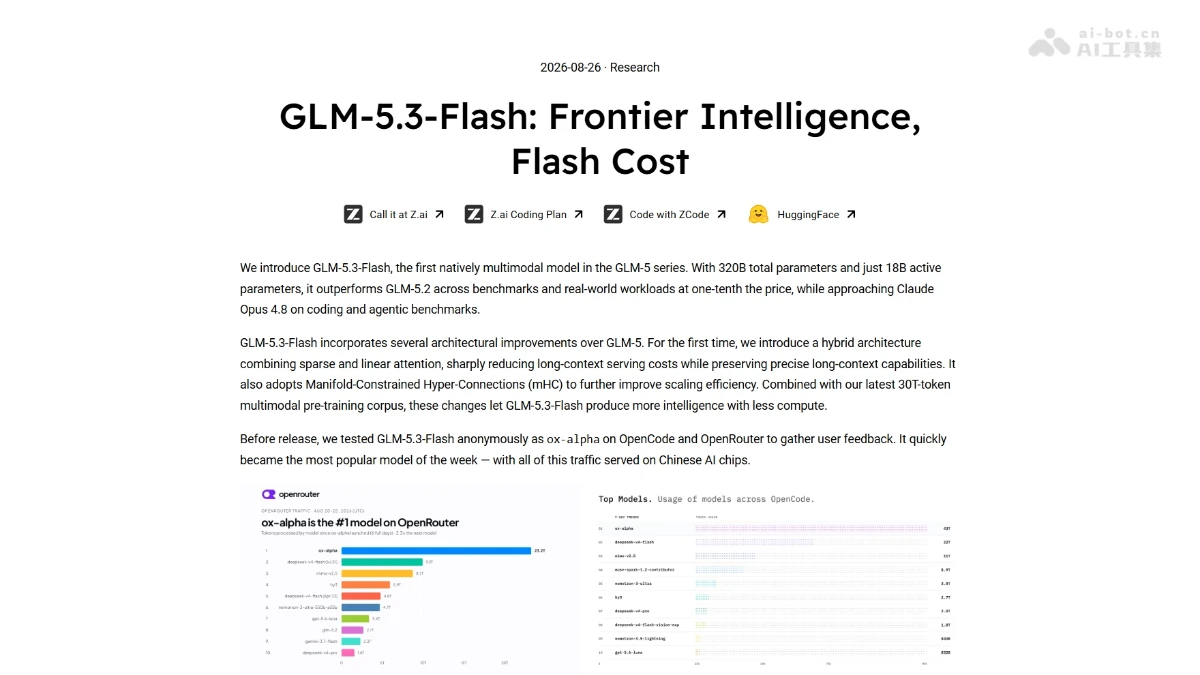
GLM-5.3-Flash – 智譜開源的原生多模態模型
GLM-5.3-Flash是什麼 GLM-5.3...
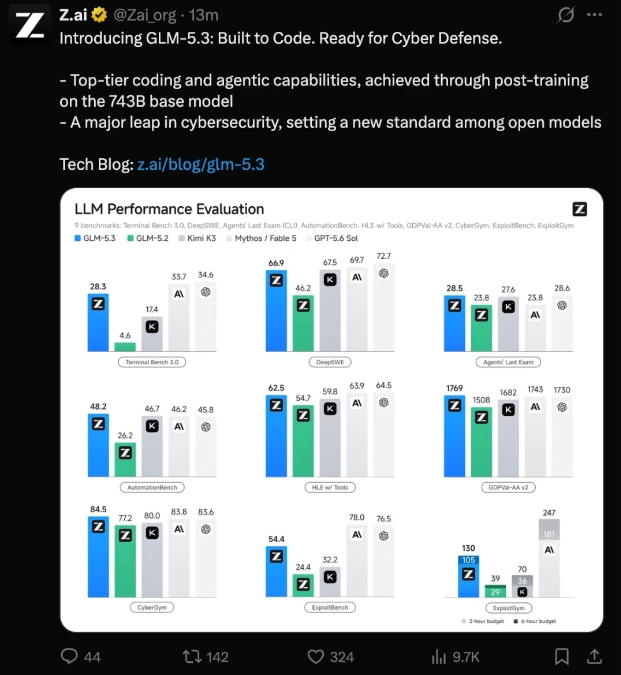
GLM-5.3 實測 – 編程、網絡安全與 3D 創作能力全面解析
這兩天的大模型圈,簡直是神...
DeepSeek V4 Pro 與 GLM-5.3 深度實測,誰是國產大模型一哥?
今天發點新模型對抗測評相關...
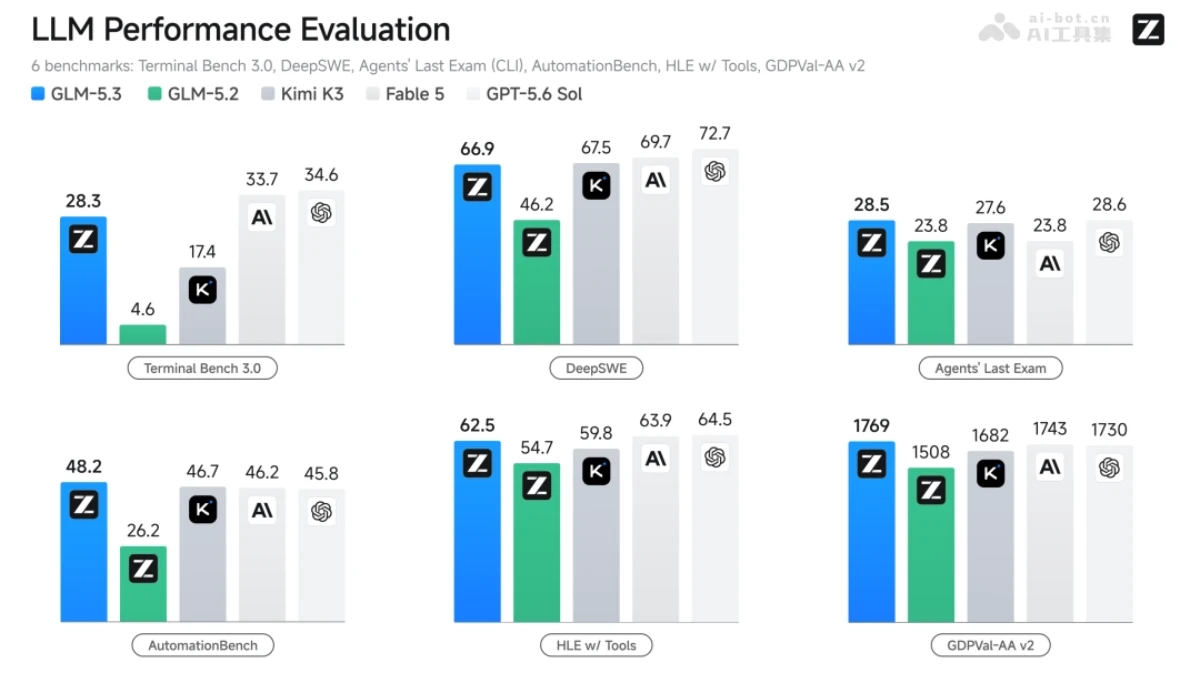
GLM-5.3 – 智譜推出的最新 AI 大模型
GLM-5.3是什麼 GLM-5.3 是智...
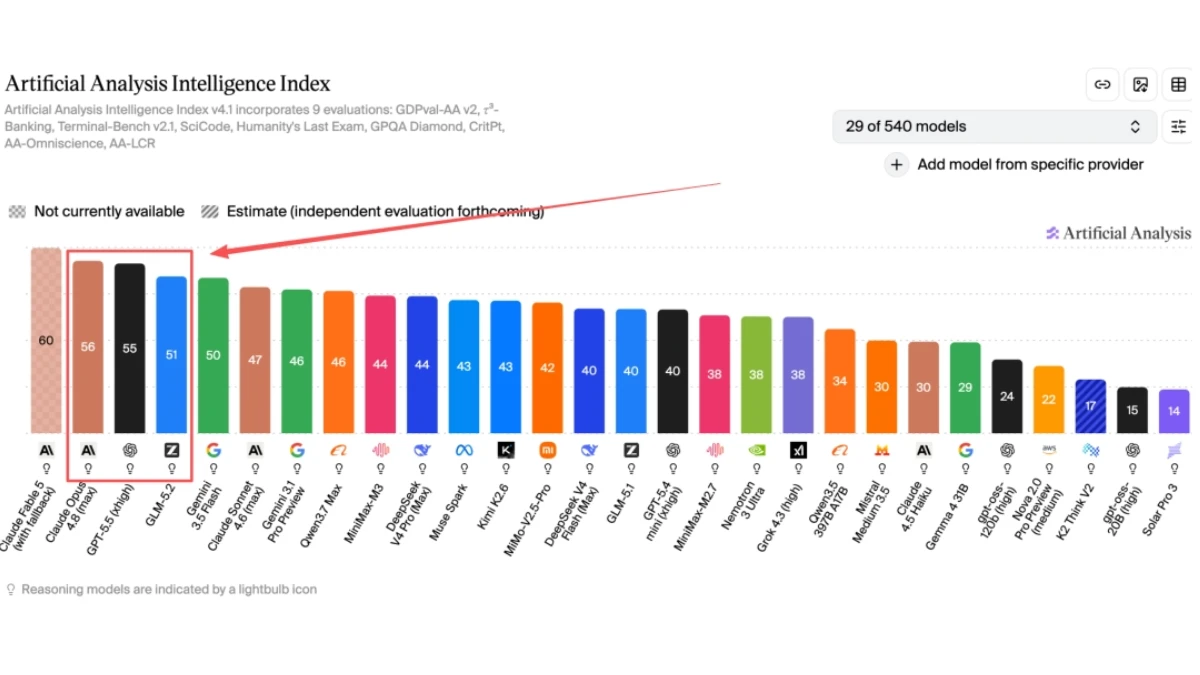
GLM-5.2 實測 – 代碼生成能力躋身全球第一梯隊
過去,國產模型一發,大家安...
國產大模型Vibe Coding橫評:DeepSeek V4和GLM-5.1實測對比
DeepSeek V4 系列模型預覽版...
智譜 GLM-5.1 開源實測:編程能力登頂 SWE-bench Pro
GLM-5.1 這麼能打?!複雜軟...
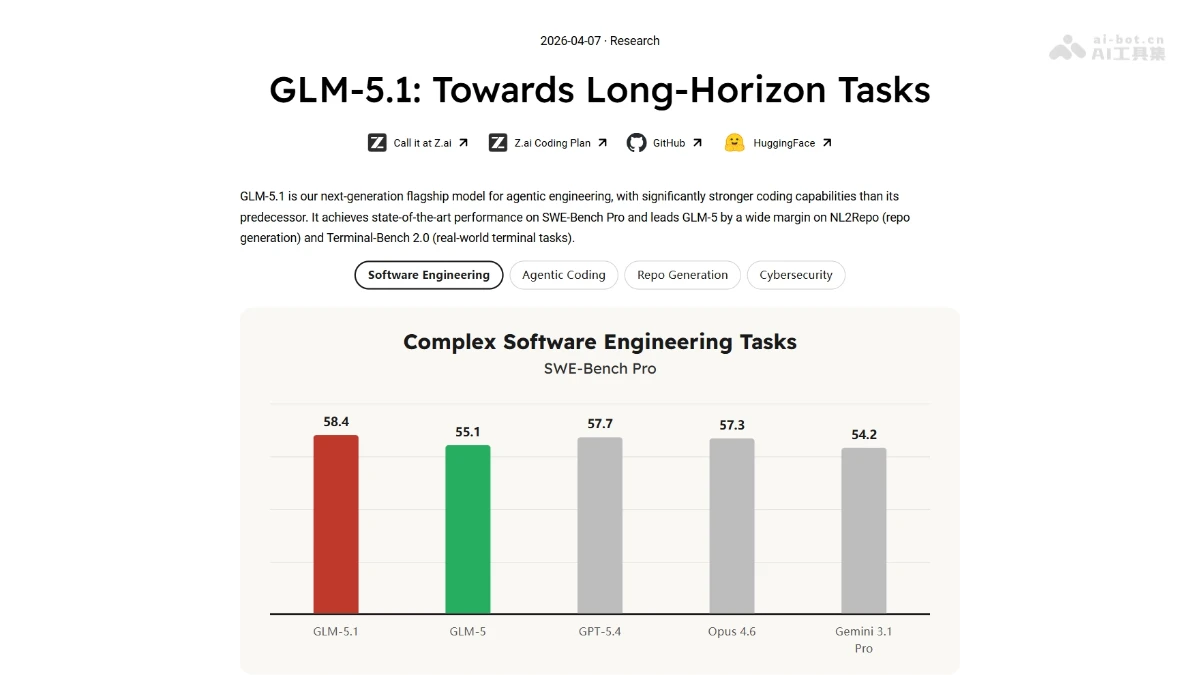
GLM-5.1 – 智譜推出的最強開源模型,8小時長程任務執行
GLM-5.1是什麼 GLM-5.1是智譜...
GLM-5V-Turbo – 智譜AI推出的原生多模態Coding基座模型
GLM-5V-Turbo是什麼 GLM-5V-T...