最好用的AI工具
搜尋:4.5
5 個結果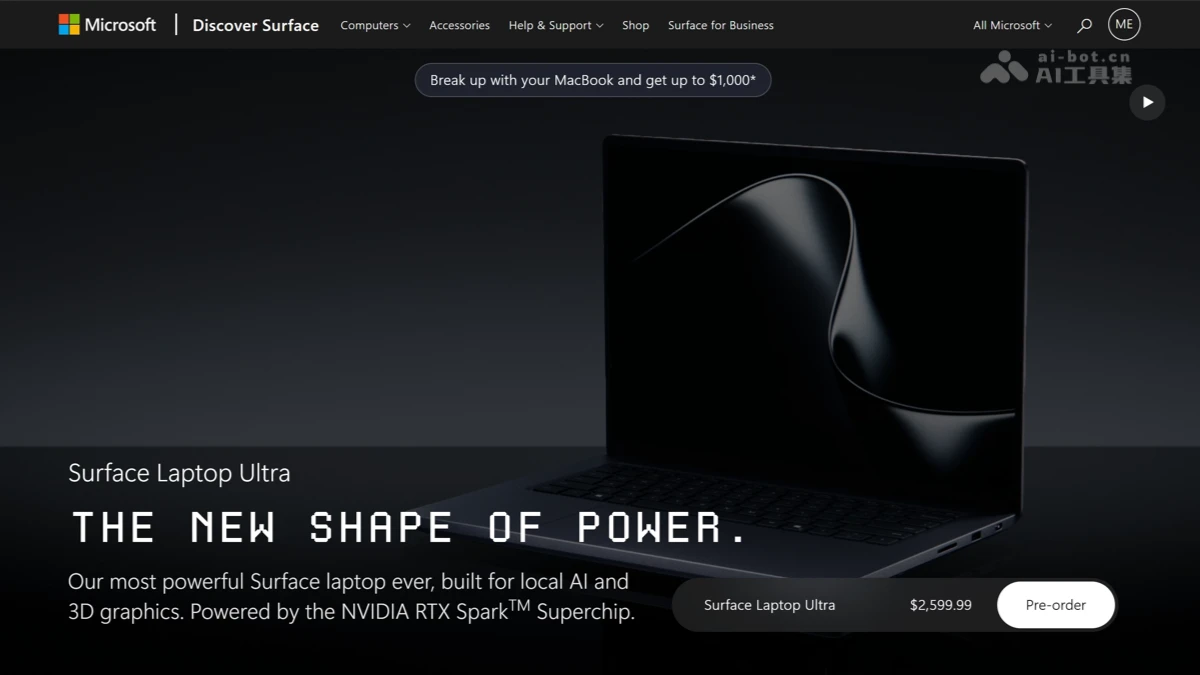
Surface Laptop Ultra – 微軟聯合英偉達推出的最強 AI PC
Surface Laptop Ultra是什麼 Surface Laptop Ultra是微軟推出最強Surface PC,搭載英偉達RTX Spark N1X超級芯片,最高20核CPU+6144核GPU+128GB統一內存,本地AI算力達1PFLOPS,可運行超1200億參數大模型。Surface Laptop Ultra採用15英寸PixelSense Ultra觸控屏、磁吸式USB-C充電,續航一整天,專爲AI開發、創意工作與智能體場景打造。 Surface Laptop Ultra的主要功能 本地跑大模型:1PFLOPS算力+128GB統一內存,本地運行超1200億參數模型。 AI編程:本地跑MAI-Code-1.1-Flash,Copilot智能編排本地與雲端任務。 智能體運行:配合MXC沙箱安全運行OpenClaw、Codex等智能體。 視頻創作:支持電影級視頻編輯,AI視頻生成比M5 Pro快6.2倍。 遊戲:光線追蹤+DLSS,《戰爭機器》穩定60幀。 屏幕:15英寸觸控屏,HDR亮度比MacBook Pro M5高25%。 磁吸充電:全球首款內置磁吸式USB-C接口。 擴展性:3個USB-C+HDMI等接口,可驅動3台4K顯示器,存儲可拆卸升級。 續航散熱:散熱提升2.5倍,續航滿足一整天。 Surface Laptop Ultra的規格參數 芯片:英偉達RTX Spark N1X超級芯片,Grace CPU + Blackwell RTX GPU,互聯速度600GB/s CPU:最高20核,入門版爲18核 GPU:最高6144核,入門版爲5120核 AI算力:1 PFLOPS FP4,可本地運行超1200億參數模型 內存:24GB家庭版或32GB~128GB專業版LPDDR5x統一內存 存儲:512GB~1TB固態硬盤,支持用戶自行拆卸、升級和更換 屏幕:15英寸PixelSense Ultra觸控屏,HDR峯值亮度比MacBook Pro M5高25% 機身:厚度不足18mm,重量不足4.5磅 散熱:全新散熱架構,散熱能力爲現有Surface筆記本的2.5倍 電池:續航滿足一整天使用 接口:3個USB-C,含全球首款內置磁吸式充電接口Magnetic Connect),、HDMI、USB-A、SD卡讀卡器、3.5mm耳機插孔,可驅動最多3台4K顯示器 操控:觸控板面積增大30%,配備先進觸覺反饋技術 系統:Windows 11家庭版/專業版 遊戲技術:英偉達光線追蹤、DLSS、Reflex Surface Laptop Ultra的價格配置 入門版2599美元,約17425元,18核CPU+5120核GPU+24GB+512GB 頂配5899.99美元,約39557元,20核CPU+6144核GPU+128GB+1TB Surface Laptop Ultra的購買地址 官方購買地址:https://www.microsoft.com/en-us/store/configure/surface-laptop-ultra/8wg5vqp0x4b8 Surface Laptop Ultra的應用場景 本地AI開發:依託1PFLOPS算力和128GB統一內存,開發者可在本地運行1200億參數大模型及MAI-Code-1.1-Flash,無需聯網即可完成代碼生成與調試。 企業智能體辦公:通過MXC安全沙箱隔離運行OpenClaw、Codex等智能體,自動完成文件整理、郵件歸檔等流程性工作。 影視內容創作:藉助AI圖像生成4.3倍、視頻生成6.2倍於M5 Pro的速度,創作者可本地完成電影級剪輯與AI素材生成。 隱私敏感計算:醫療、法律、金融行業的機密數據全程在本地處理,無需上傳雲端即可滿足合規要求。
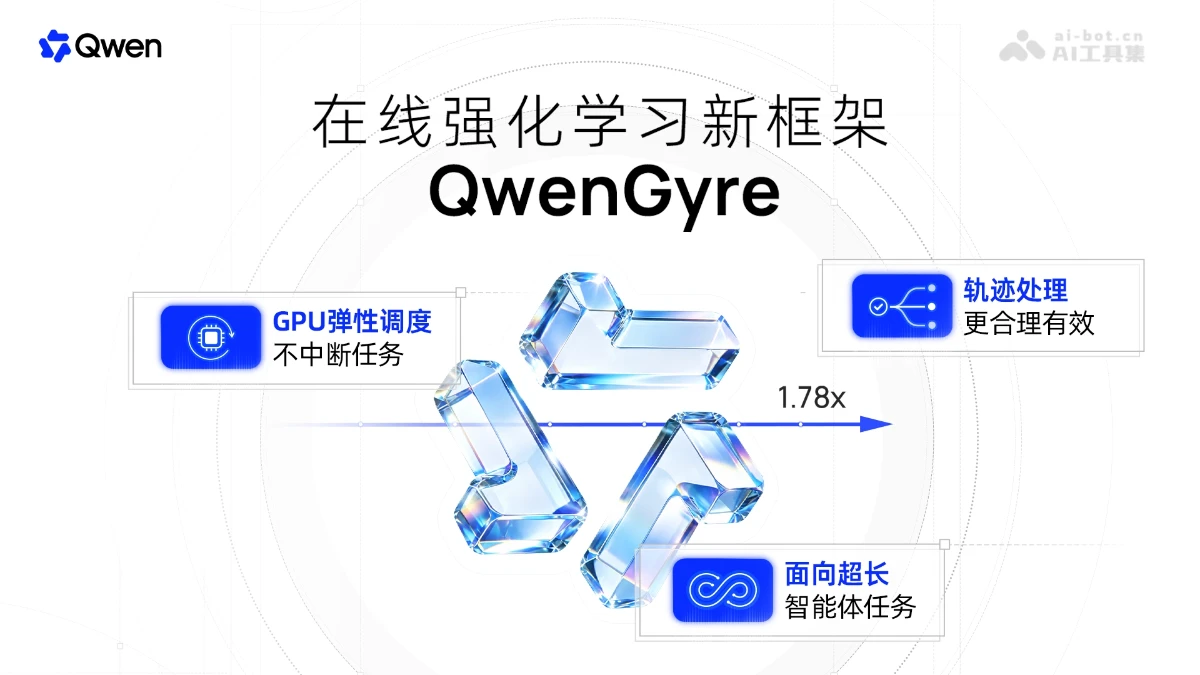
QwenGyre – 阿里千問推出的在線強化學習框架
QwenGyre是什麼 QwenGyre 是阿里千問推出的超長程智能體在線強化學習框架,面向單次約 70 萬 token、持續數小時的任務。QwenGyre用彈性調度在任務不中斷時把空閒 GPU 在採樣與訓練間切換,用軌跡處理保留真實上下文、評估部分成果、去重共享前綴以控制成本。在 Qwen3.8-2.4T 上 48 步把 NL2RepoBench 通過率從 52.48% 提至 58.54%,較 Async 端到端加速 1.78×。 QwenGyre的主要功能 超長程智能體在線強化學習:在單次執行長達數小時、累計約百萬 token 的任務上直接做 RL 訓練。 彈性 GPU 調度:任務不中斷的情況下,動態把空閒 GPU 在採樣與訓練間切換。 請求重路由與 KV cache 遷移:切換 GPU 角色時智能體繼續運行,工作區和工具狀態保留,通過 RDMA 遷移 KV cache 減少重複計算。 流式訓練與新節點中途加入:核心 cell 保存權威參數,衛星 cell 可隨時拉取快照加入正在進行的批次,按進度領取微批次。 軌跡樹與真實上下文保留:用 Token-in Token-out 記錄每次調用的精確輸入輸出,按共享前綴組織成軌跡樹,輸出始終對應生成時的上下文。 部分評分(Partial Scoring):超時未完成的任務若產出可檢驗成果,仍按任務規則評分並用於訓練。 軌跡預算與損失均衡:每個執行最多保留 Jmax 條軌跡,共享前綴只計一次損失,避免分支多的任務權重過大。 QwenGyre的技術原理 彈性調度(Elastic Scheduler):將 GPU 劃分爲若干同構計算單元,每個 cell 能用 SGLang 提供採樣服務,也能用 Megatron 承載完整訓練副本。調度器跟蹤”水位”,未完成任務量,只要剩餘採樣容量足以支撐在跑任務且訓練數據供應充足,就按序把 cell 逐個切入訓練;切換時由代理把模型請求重定向到新推理引擎並重試未完成請求,後端進程和通信組無需重建。核心 cell 持有權威權重與優化器狀態,衛星 cell 通過 RDMA 拉取參數快照後加入當前批次的梯度累計,最後由核心統一彙總更新,實現訓練隨數據就緒逐步擴容、採樣與訓練高度重疊。 軌跡處理(Trajectory Processor):QwenGyre 通過代理記錄每次模型調用的精確輸入/輸出 token ID 和行爲策略對數概率,把共享前綴複用、分叉處建分支,組織成軌跡樹,保證每條輸出始終對應其生成時的原始上下文。訓練准入階段按角色優先級爲每個執行選取不超過 Jmax 條軌跡,僅策略模型生成的 token 參與損失、共享目標只計一次;損失先在執行內對選中 token 取平均、再對執行取平均,使執行權重與其分支數量解耦。配合 Partial Scoring 對超時任務的已完成部分評估打分,最大化利用超長程執行中稀疏而昂貴的有效信號。 如何使用QwenGyre 目前 QwenGyre 用論文形式發佈,阿里尚未公開代碼與安裝包。 QwenGyre的核心優勢 首次實現旗艦模型超長程在線 RL:在 Qwen3.8-2.4T 上完成單次約 70 萬 token 任務的在線強化學習,48 步將 NL2RepoBench 通過率從 52.48% 提升至 58.54%。 訓練效率大幅提升:相同 GPU 預算下端到端加速最高達 1.78×(對 Async)、1.85×(對 Colocate),48 步訓練耗時從 134.55 小時縮短至 75.42 小時。 任務零中斷的彈性調度:GPU 在採樣與訓練間動態切換時,智能體執行、工作區和工具狀態完全保留,切換耗時僅數秒,相對數小時的執行可忽略。 GPU 利用率最大化:細粒度 cell 級資源分配消除了 Colocate 模式的長尾等待空轉和 Async 模式的固定分區僵化,訓練可被採樣完全隱藏。 真實上下文保真訓練:TITO 機制保證每條輸出都對應其生成時的原始上下文,避免歷史壓縮、子智能體上下文拼接導致的”虛假上下文”訓練信號。 QwenGyre的項目地址 arXiv技術論文:https://arxiv.org/pdf/2609.33848 QwenGyre的應用場景 自然語言生成完整代碼倉庫:根據自然語言規格從零構建多包軟件倉庫,單次執行約 70 萬 token、長達數小時。 已有倉庫的長程軟件工程:在現有代碼庫中完成功能開發、缺陷修復與跨文件改造等複雜任務。 多輪終端自動化操作:智能體在命令行環境中連續執行數百輪工具調用,完成系統配置與運維任務。 大規模代碼庫重構遷移:跨倉庫技術棧升級、整體重構等需要數小時連續規劃執行的工程任務。 多智能體協作任務:主智能體委派子智能體的層級執行場景,
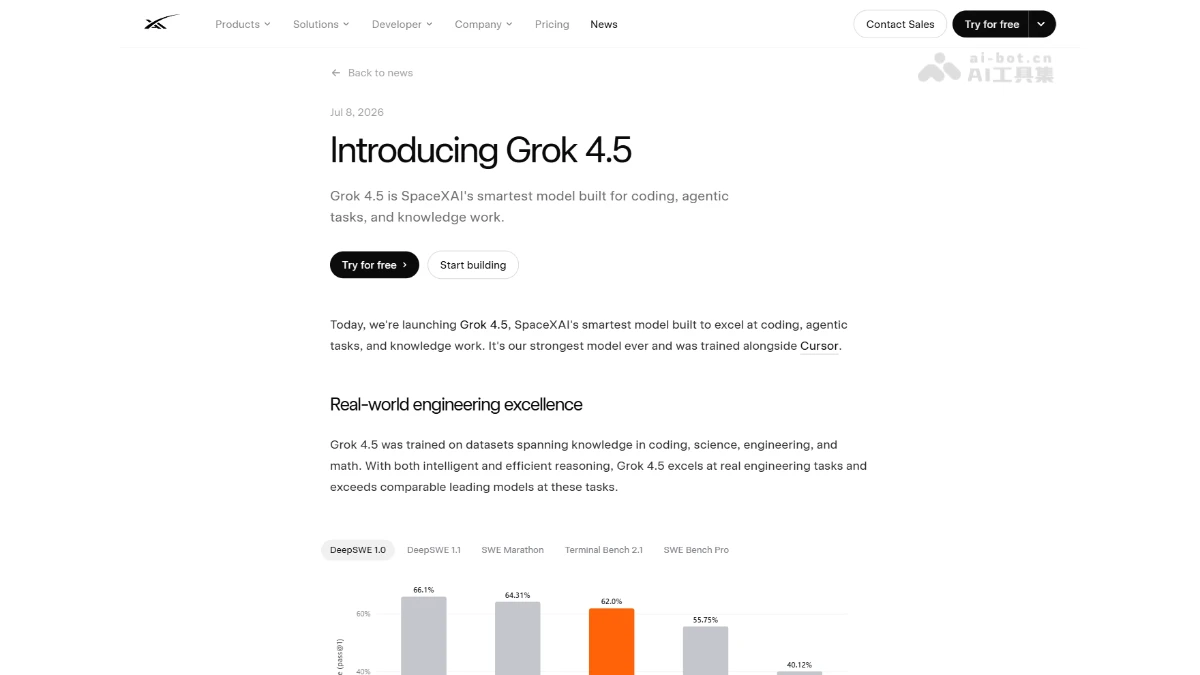
Grok 4.5 – SpaceXAI推出的新一代旗艦大語言模型
Grok 4.5是什麼 Grok 4.5是Sp...

MiniCPM-o 4.5 – 面壁智能開源的全雙工全模態模型
MiniCPM-o 4.5是什麼 MiniCPM...
消息稱AI軟件開發初創公司Poolside AI正洽談籌集4.5億美元的融資
據PitchBook報道,總部位於法...