DeepInfer – DeepSeek 開源的生產級推理框架
DeepInfer是什麼
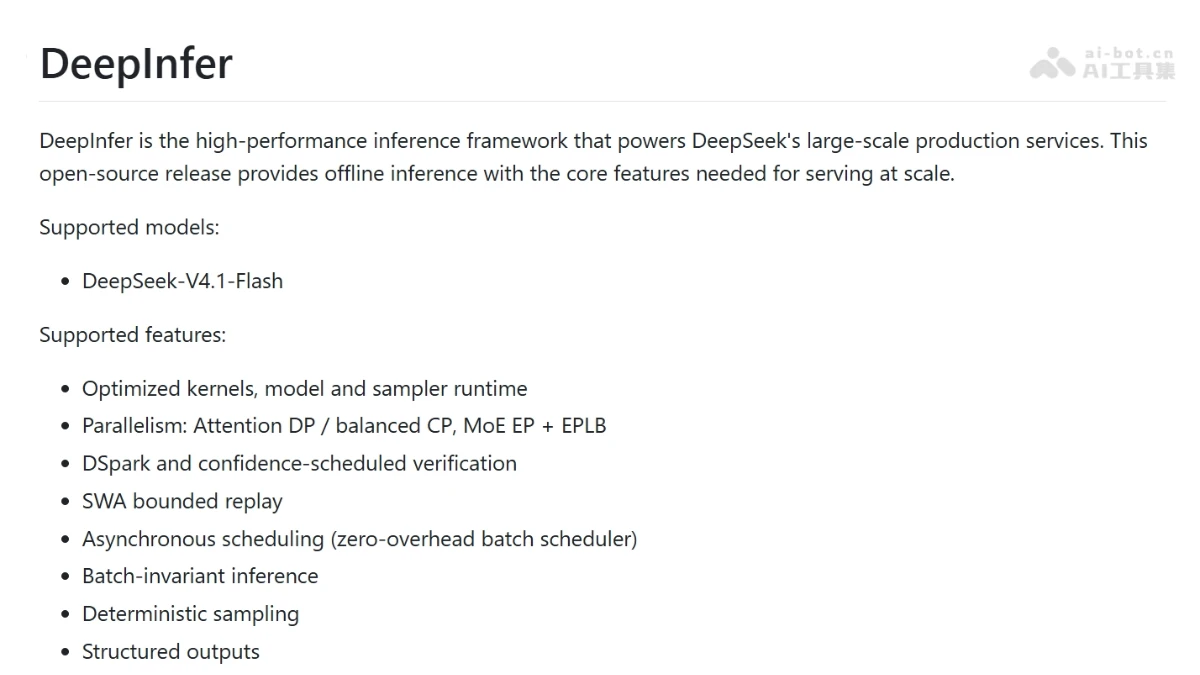
DeepInfer 是 DeepSeek 開源的生產級推理框架,源自 vLLM,支持 V4.1 Flash,可運行於英偉達 SM100 與華爲昇騰 950。DeepInfer 採用 PD 分離部署,靠 3FS 緩存集羣實現 96% 輸入命中、Prefill 提效 25 倍,SWA Bounded Replay 令 Prefill 計算量減半,DSpark 投機解碼再提吞吐 6%,線上單集羣日處理 155 萬億 Token。同步開源的 deepseek-recipe是生產級 Token 編解碼組件,負責統一 Chat Completions、Responses、Messages 三種 API 格式,處理注入防護、並行分詞與流式輸出,使自部署模型的接口表現與官方 API 完全一致。
DeepInfer的主要功能
分佈式推理:支持注意力數據並行、上下文並行及 MoE 專家並行,支撐單集羣日處理 155 萬億 Token 的大規模生產服務。
跨硬件平台兼容:同時支持英偉達 SM100 GPU 與華爲昇騰 950 NPU,覆蓋兩大算力生態。
長上下文高效處理:通過 SWA Bounded Replay 將緩存未命中的重算成本壓縮到固定 128 個 Token,與上下文長度和層數解耦。
推測解碼加速:集成自研 DSpark 與置信度驗證調度,讓模型一次推進多個 Token,顯著提升生成吞吐。
負載均衡調度:動態均衡專家與請求的分佈,線上最繁忙的卡僅高出平均負載 9%。
緩存複用:依託 3FS 存儲集羣實現 96% 的輸入緩存命中率,Prefill 吞吐提升約 25 倍。
DeepInfer的技術原理
PD 分離部署:推理分爲 Prefill 與 Decode 兩個階段:Prefill 一次性處理數萬 Token 的輸入,是計算密集型;Decode 逐 Token 生成,受限於顯存帶寬讀取。DeepInfer 將兩者部署在不同硬件上,Prefill 用常規 8 卡服務器,Decode 用 64–128 卡超節點,兩類機器數量按約 1:1 配置,使各自按最優硬件特性運行。
前綴緩存體系:Agent 場景下每次工具調用都會重發完整歷史,其中大部分內容已計算過。系統只緩存從首 Token 起完全一致的前綴,命中部分直接複用 KV Cache,僅計算新增部分。緩存存放於獨立的 3FS 分佈式存儲集羣,用 128 Token 爲塊寫入,Agent 流量保留 3 天、聊天流量保留 7 天。
SWA Bounded Replay:V4.1 Flash 的部分層採用滑動窗口注意力,每個 Token 只關注最近 128 個 Token,這部分 KV Cache 不寫入硬盤、僅駐留在計算機器的內存中。未命中時舊方案需按”層數 × 窗口長度”精確重算,V4.1 改爲只重算最後 128 個 Token、且注意力僅在這 128 個內計算,得到近似窗口緩存,重算成本固定。
DSpark 推測解碼與異步調度:由輕量草稿模塊先連續猜測 5 個 Token,再由目標模型批量驗證,猜對的直接採用、首個猜錯處由大模型糾正,一步計算即可推進多個 Token。置信度頭預估各猜測被接受的概率,低可能性的不再驗證、把算力讓給其他請求,相比固定驗證 5 個的方案線上吞吐提升 6%。同時 CPU 調度第 N+1 步與 GPU 計算第 N 步重疊執行,消除 GPU 在調度間隙的空轉。
微信關注回覆“開源”,加入AI開源項目交流羣
如何使用DeepInfer
確認環境前置條件:Linux 系統,GCC ≥ 13.0、Python 3.12,NVIDIA 平台需 CUDA 13,昇騰平台需 CANN 9.2。
克隆倉庫:git clone https://github.com/deepseek-ai/DeepInfer 並進入目錄。
創建乾淨環境:新建並激活一個空的 Python 3.12 虛擬環境,避免依賴衝突。
選擇硬件平台並編譯:運行 export DEEPINFER_ACCELERATOR=nvidia(昇騰用 ascend)後執行 ./build.sh 從源碼構建,注意該環境變量需在後續運行環境中保持生效。
準備模型權重:默認首次運行會自動從 Hugging Face 下載 deepseek-ai/DeepSeek-V4.1-Flash-1017,或用 export DEEPINFER_HF_MODEL_DIR=/path/to/DeepSeek-V4.1-Flash-1017 指向本地副本。
運行離線推理示例:執行 python examples/offline_inference.py 啓動推理,更多用法參考倉庫 examples 目錄。