最好用的AI工具
搜尋:3.0
20 個結果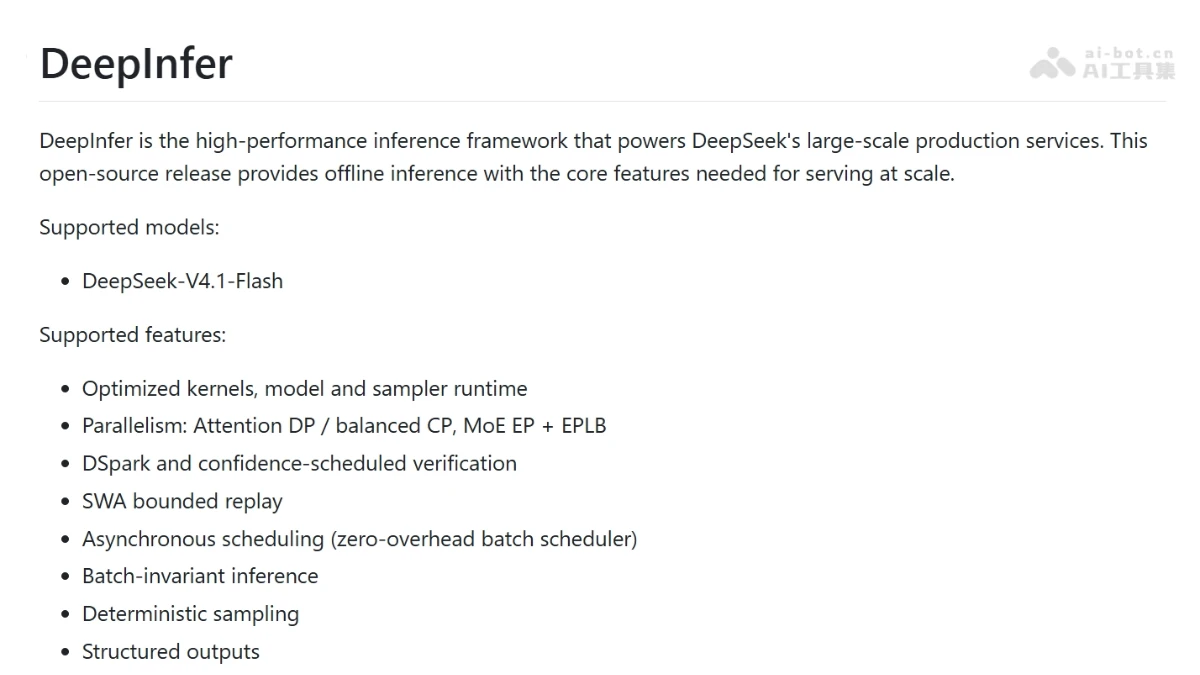
DeepInfer – DeepSeek 開源的生產級推理框架
DeepInfer是什麼 DeepInfer 是 DeepSeek 開源的生產級推理框架,源自 vLLM,支持 V4.1 Flash,可運行於英偉達 SM100 與華爲昇騰 950。DeepInfer 採用 PD 分離部署,靠 3FS 緩存集羣實現 96% 輸入命中、Prefill 提效 25 倍,SWA Bounded Replay 令 Prefill 計算量減半,DSpark 投機解碼再提吞吐 6%,線上單集羣日處理 155 萬億 Token。同步開源的 deepseek-recipe是生產級 Token 編解碼組件,負責統一 Chat Completions、Responses、Messages 三種 API 格式,處理注入防護、並行分詞與流式輸出,使自部署模型的接口表現與官方 API 完全一致。 DeepInfer的主要功能 分佈式推理:支持注意力數據並行、上下文並行及 MoE 專家並行,支撐單集羣日處理 155 萬億 Token 的大規模生產服務。 跨硬件平台兼容:同時支持英偉達 SM100 GPU 與華爲昇騰 950 NPU,覆蓋兩大算力生態。 長上下文高效處理:通過 SWA Bounded Replay 將緩存未命中的重算成本壓縮到固定 128 個 Token,與上下文長度和層數解耦。 推測解碼加速:集成自研 DSpark 與置信度驗證調度,讓模型一次推進多個 Token,顯著提升生成吞吐。 負載均衡調度:動態均衡專家與請求的分佈,線上最繁忙的卡僅高出平均負載 9%。 緩存複用:依託 3FS 存儲集羣實現 96% 的輸入緩存命中率,Prefill 吞吐提升約 25 倍。 DeepInfer的技術原理 PD 分離部署:推理分爲 Prefill 與 Decode 兩個階段:Prefill 一次性處理數萬 Token 的輸入,是計算密集型;Decode 逐 Token 生成,受限於顯存帶寬讀取。DeepInfer 將兩者部署在不同硬件上,Prefill 用常規 8 卡服務器,Decode 用 64–128 卡超節點,兩類機器數量按約 1:1 配置,使各自按最優硬件特性運行。 前綴緩存體系:Agent 場景下每次工具調用都會重發完整歷史,其中大部分內容已計算過。系統只緩存從首 Token 起完全一致的前綴,命中部分直接複用 KV Cache,僅計算新增部分。緩存存放於獨立的 3FS 分佈式存儲集羣,用 128 Token 爲塊寫入,Agent 流量保留 3 天、聊天流量保留 7 天。 SWA Bounded Replay:V4.1 Flash 的部分層採用滑動窗口注意力,每個 Token 只關注最近 128 個 Token,這部分 KV Cache 不寫入硬盤、僅駐留在計算機器的內存中。未命中時舊方案需按”層數 × 窗口長度”精確重算,V4.1 改爲只重算最後 128 個 Token、且注意力僅在這 128 個內計算,得到近似窗口緩存,重算成本固定。 DSpark 推測解碼與異步調度:由輕量草稿模塊先連續猜測 5 個 Token,再由目標模型批量驗證,猜對的直接採用、首個猜錯處由大模型糾正,一步計算即可推進多個 Token。置信度頭預估各猜測被接受的概率,低可能性的不再驗證、把算力讓給其他請求,相比固定驗證 5 個的方案線上吞吐提升 6%。同時 CPU 調度第 N+1 步與 GPU 計算第 N 步重疊執行,消除 GPU 在調度間隙的空轉。 微信關注回覆“開源”,加入AI開源項目交流羣 如何使用DeepInfer 確認環境前置條件:Linux 系統,GCC ≥ 13.0、Python 3.12,NVIDIA 平台需 CUDA 13,昇騰平台需 CANN 9.2。 克隆倉庫:git clone https://github.com/deepseek-ai/DeepInfer 並進入目錄。 創建乾淨環境:新建並激活一個空的 Python 3.12 虛擬環境,避免依賴衝突。 選擇硬件平台並編譯:運行 export DEEPINFER_ACCELERATOR=nvidia(昇騰用 ascend)後執行 ./build.sh 從源碼構建,注意該環境變量需在後續運行環境中保持生效。 準備模型權重:默認首次運行會自動從 Hugging Face 下載 deepseek-ai/DeepSeek-V4.1-Flash-1017,或用 export DEEPINFER_HF_MODEL_DIR=/path/to/DeepSeek-V4.1-Flash-1017 指向本地副本。 運行離線推理示例:執行 python examples/offline_inference.py 啓動推理,更多用法參考倉庫 examples 目錄。
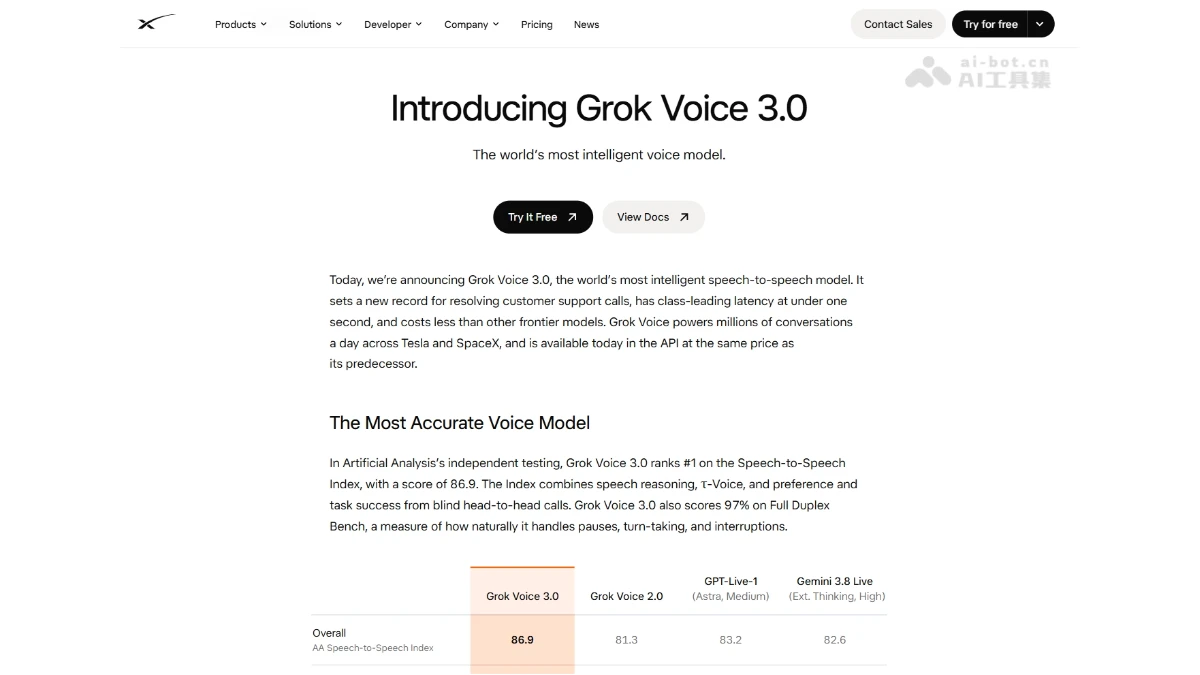
Grok Voice 3.0 – SpaceXSI 推出的端到端語音轉語音模型
Grok Voice 3.0是什麼 Grok Voice 3.0 是 SpaceXSI 推出的端到端語音轉語音模型,在獨立測試機構 Artificial Analysis 的語音綜合榜單以 86.9 分居首,響應延遲低於 1 秒,單次任務運行成本約 0.025 美元,低於同級別競品。目前每天支撐特斯拉車內數百萬次對話,星鏈客服中心依託模型日處理 2 萬通多語言來電,約七成無需人工介入可解決。 Grok Voice 3.0的主要功能 端到端語音對話:支持語音輸入直接生成語音輸出,無需文字中轉,實現自然流暢的實時人機對話。 全雙工交互:可智能處理停頓、對話輪替和插話,用戶隨時打斷,模型響應自然不僵硬。 複雜任務執行:依託 Connectors 和 Grok Bot,可完成查日程、回郵件、下單咖啡、預訂晚餐等免動手操作。 企業客服能力:單個智能體即可完成客戶身份覈驗、硬件故障排查、發放退款和補發設備全流程服務。 多語言支持:星鏈客服中心每天以多種語言承接約 2 萬通客戶來電。 Grok Voice 3.0的技術原理 端到端語音轉語音架構:傳統語音助手採用”語音識別→文本理解→文本生成→語音合成”的多模塊級聯方案,信息逐級損耗且延遲疊加。Grok Voice 3.0 採用語音到語音的直接建模,音頻信號進入模型後不經文本中間表示,直接輸出語音回覆,減少級聯誤差,是其首響延遲壓至 1 秒以內的結構基礎。 全雙工對話建模:模型能同時處理收聽與生成:通過流式編碼器持續捕捉用戶音頻流,結合對停頓、語氣詞和插話行爲的判別,動態決定何時續說、何時讓步,在 Full Duplex Bench 上取得 97% 的成績,是其車載免喚醒、可打斷交互體驗的核心支撐。 語音推理與智能體能力融合:模型將聽覺理解與大語言模型的推理規劃能力耦合,用戶語音被解析爲任務意圖後,由內置的智能體框架調用日程、郵件、下單等外部工具 Connectors 或 Grok Bot 完成任務,把執行結果用自然語音回饋用戶,形成”聽懂—規劃—執行—回覆”的閉環,是其客服場景能獨立完成退款、補發等操作的原因。 如何使用Grok Voice 3.0 普通用戶:在 Grok 應用、Grok Bot 或特斯拉車內直接開啓語音模式可對話,grok-voice-latest 用戶已自動升級無需操作。 開發者:註冊 API Console 獲取密鑰後,按官方文檔調用 Voice Agent API 接入應用。 Grok Voice 3.0的核心優勢 綜合智能第一:以 86.9 分登頂 Artificial Analysis 語音轉語音綜合榜,在語音推理、任務完成率和人類偏好上全面領先競品。 延遲行業領先:響應延遲低於 1 秒,比同級別 GPT-Live-1 低 40%,實現智能與速度的最優平衡。 運行成本更低:單次任務成本約 0.025 美元,低於 GPT-Live-1 和 GPT-Realtime-2.1,且 API 定價與上代持平不漲。 全雙工交互自然:Full Duplex Bench 拿下 97%,對停頓、輪替和插話的處理接近真人對話體驗。 企業場景驗證充分:EVA-Bench 以 74% 精度居首,星鏈實測日接 2 萬通電話、70% 無需人工、四分之一銷售通話直接成交。 Grok Voice 3.0的項目地址 項目官網:https://x.ai/news/grok-voice-3 Grok Voice 3.0的同類競品對比 對比維度 Grok Voice 3.0 Gemini 3.8 Live AA 語音綜合指數 86.9(第 1 名) 82.6 語音推理(Big Bench Audio) 98.5% 97.7% 人類偏好(Arena Elo) 1070 990 任務完成率 94.8% 89.1% 全雙工(Full Duplex Bench) 97.0% 91.9% τ-Voice 客服場景 71.6% 68.6% 單次任務成本 $0.025 更高(未列具體值) EVA-Bench 企業客服精度 74%(最高) 未領先 Grok Voice 3.0的應用場景 智能車載語音助手(特斯拉):駕駛員全程免動手,通過 Connectors 查詢日程、回覆郵件,或用 Grok Bot 完成下單咖啡、預訂晚餐等複雜任務,目前每天處理數百萬次車內對話。 企業客服中心(星鏈):星鏈客服依託 Grok Voice 每天多語言接聽約 2 萬通來電,約 70% 無需人工介入即可解決,單個智能體可獨立完成身份覈驗、故障排查、退款和設備補發。 電話銷售轉化:約四分之一的銷售通話在客戶掛斷前即促成下
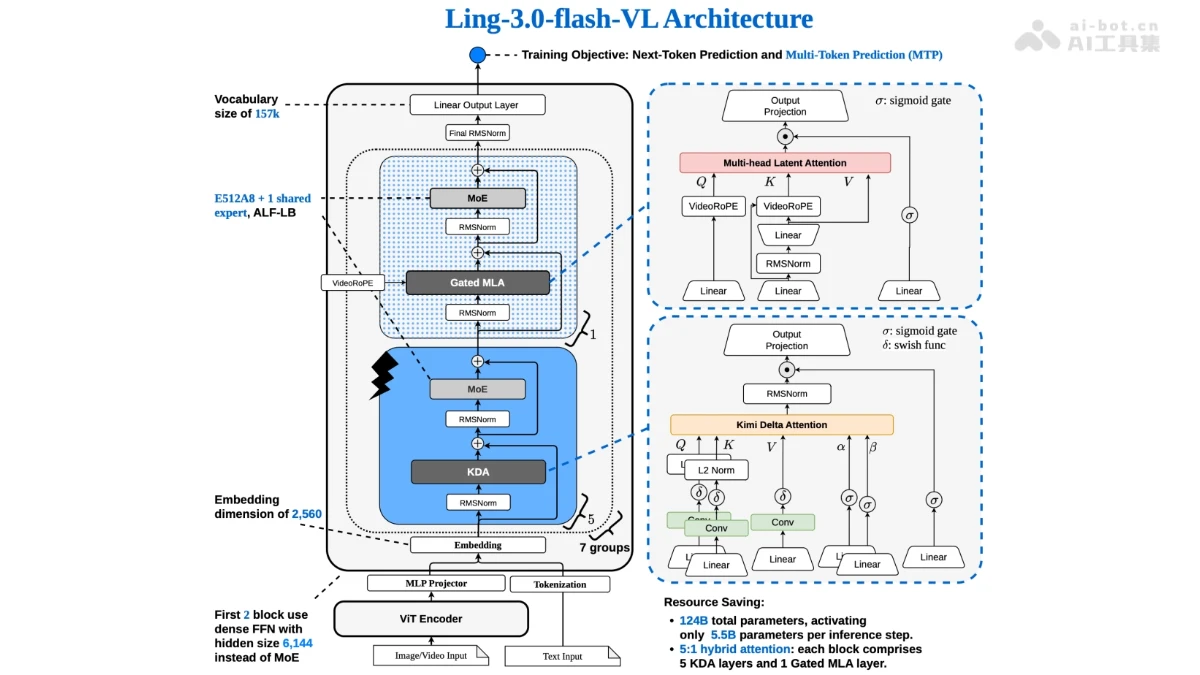
Ling-3.0-flash-VL – 螞蟻開源的原生多模態大模型
Ling-3.0-flash-VL是什麼 Lin...
Ling-3.0-flash-Fin – 螞蟻百靈推出的首個金融增強模型
Ling-3.0-flash-Fin是什麼 Li...
MiniMax Music 3.0 – MiniMax 開源的音樂生成模型
MiniMax Music 3.0是什麼 Min...
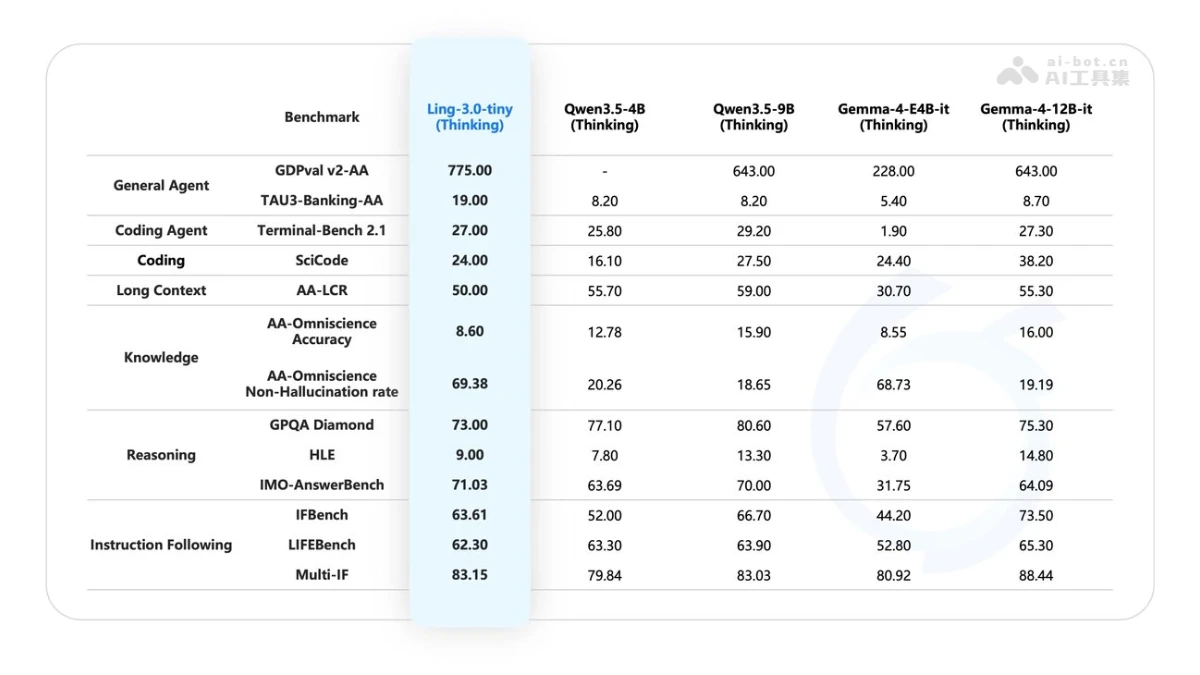
Ling-3.0-tiny – 螞蟻百靈推出的原生混合推理模型
Ling-3.0-tiny是什麼 Ling-3....
Wan3.0 – 阿里萬相最新推出的視頻生成大模型
Wan3.0是什麼 Wan3.0 是阿里...
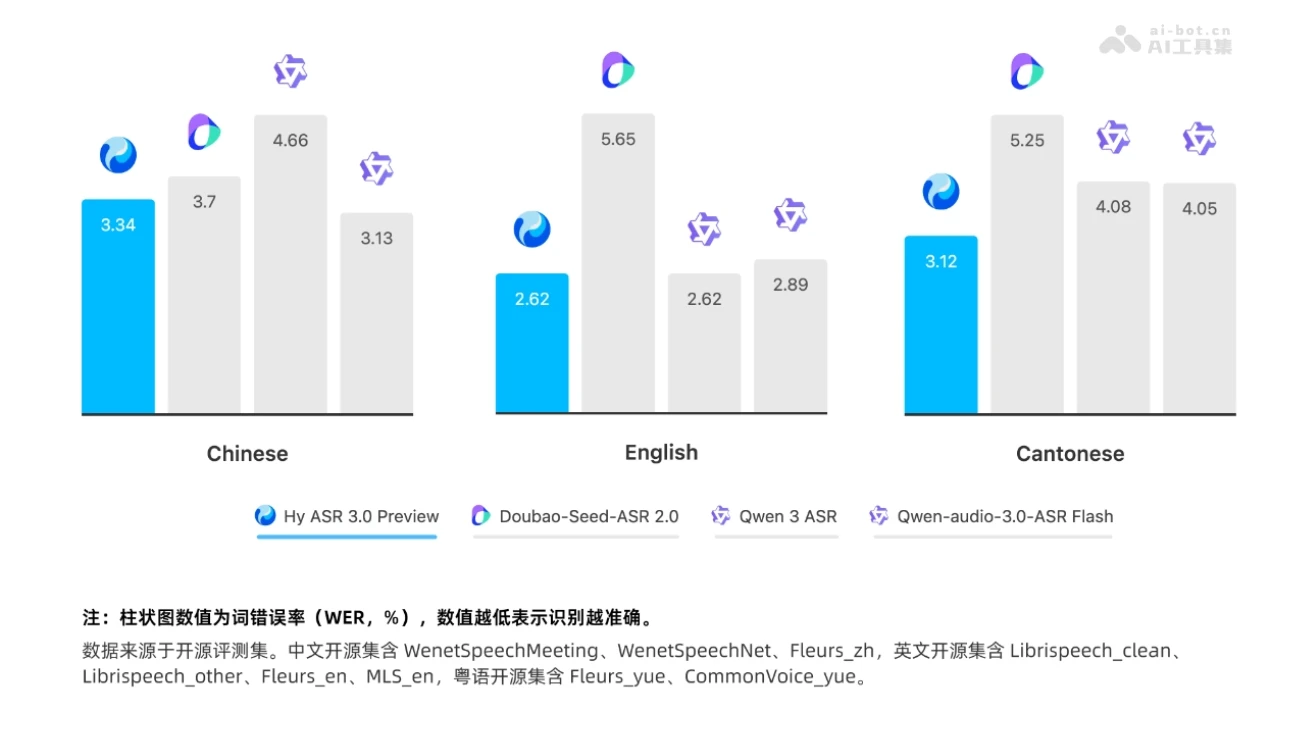
Hy ASR 3.0 preview – 騰訊混元推出的新一代語音識別模型
Hy ASR 3.0 preview是什麼 Hy...
Qwen-Audio-3.0-ASR-Flash – 阿里千問推出的語音識別大模型
Qwen-Audio-3.0-ASR-Flash是...
商湯 Seko 3.0 實測 – 一鍵生成爆款AI短漫劇
AI 劇漫劇的觀衆越來越多,普...
Ling 3.0 Flash – 螞蟻百靈推出的輕量級 MoE 推理模型
Ling 3.0 Flash是什麼 Ling-3...
Qwen-Image-3.0 – 阿里通義推出第三代圖像生成基礎模型
Qwen-Image-3.0是什麼 Qwen-I...
Qwen-Audio-3.0-TTS – 阿里通義千問推出的語音合成模型
Qwen-Audio-3.0-TTS是什麼 Qw...
Qwen-Audio-3.0-Realtime – 阿里推出的實時語音交互模型
Qwen-Audio-3.0-Realtime是什...
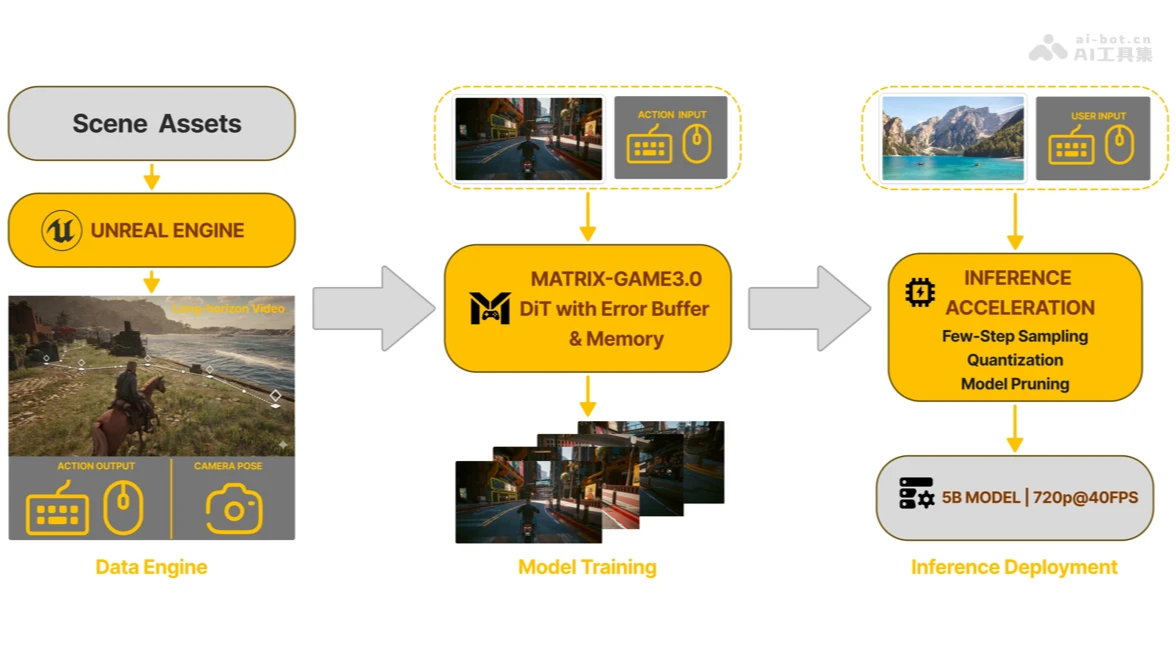
Matrix-Game 3.0 – 崑崙萬維推出的實時交互式世界模型
Matrix-Game 3.0是什麼 Matri...
FeelFish 3.0 發佈 – 小說創作,正式邁入多智能體時代
當 AI 還在以「單智能體問答...
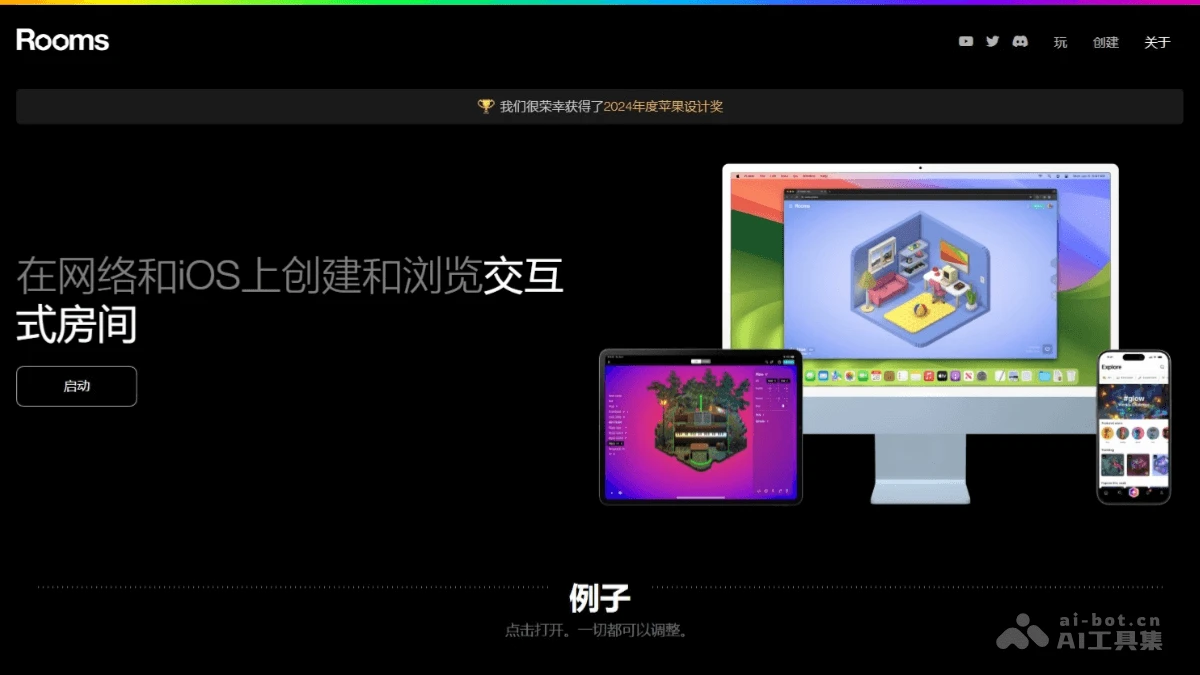
Rooms – 前 Google 員工推出的交互式 3D 房間創建應用
Rooms是什麼 Rooms 是前 Google 員工推出的交互式房間設計應用,支持用戶用超過 10,000 個可編輯物品和 Lua 編程語言構建和編碼交互式的 3D 房間和小遊戲,支持在網頁端和 iOS 平台應用。Rooms提供一個創造性的平台,用戶在這裏表達自己,創造出獨特的數字空間,用類似 TikTok 的垂直信息流瀏覽其他人的作品。Rooms 引入了無需編程即可讓房間“活”起來的新功能,並計劃通過 Google Gemini AI 進一步增強應用體驗,例如添加文本到語音模式,讓角色能“說話”。 Rooms的主要功能 3D 房間創建:用戶用應用內提供的超過 10,000 個物品構建個性化的 3D 房間。 編程與交互:基於 Lua 編程語言,用戶爲房間添加交互功能,例如動畫和遊戲元素。 內容瀏覽與分享:應用提供類似 TikTok 的垂直信息流,用戶能瀏覽其他創作者的作品,進行分享和互動。 無需編程的編輯器:3.0 版本新增的 Actions 編輯器支持用戶無需編寫代碼讓房間具有動態效果。 Rooms的官網地址 官網地址:rooms.xyz Rooms的應用場景 個人創作與表達:用戶創建個性化的 3D 空間展示自己的興趣、愛好和藝術風格,如模擬自己的房間、設計虛擬畫廊等。 遊戲開發與體驗:用戶能製作簡單的 3D 小遊戲,如迷宮、解謎遊戲等,供自己或他人體驗和娛樂。 教育與學習:對於學習編程和 3D 設計的學生或愛好者,Rooms 提供一個實踐平台,基於實際操作提高相關技能。 社交與互動:用戶能瀏覽和評論其他創作者的作品,與創作者進行互動,對喜歡的作品進行再創作。 品牌展示與營銷:品牌創建專屬的 3D 空間展示產品或品牌故事,吸引用戶的關注和參與,增強品牌影響力。
Granite 3.0 – IBM推出用於企業級應用的系列AI模型
Granite 3.0是什麼 Granite 3...
MiniCPM 3.0 – 面壁智能開源的端側AI模型,4B參數性能超越GPT-3.5
MiniCPM 3.0是什麼 MiniCPM 3...
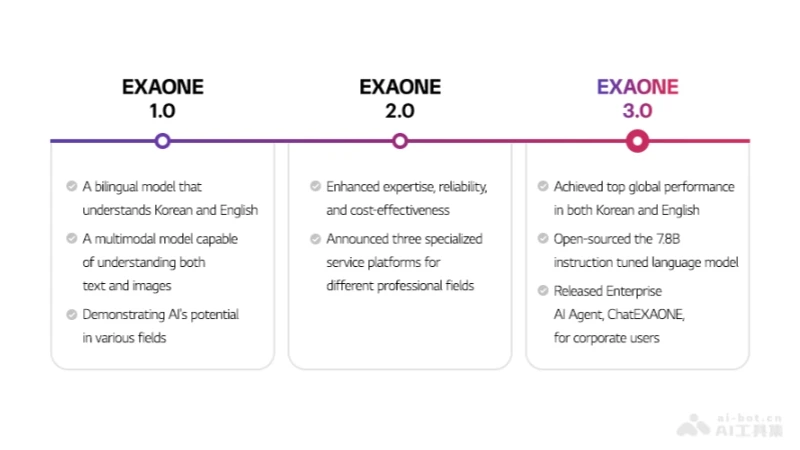
EXAONE 3.0 – LG 推出的開源 AI 模型,專爲英語和韓語設計
EXAONE 3.0是什麼 EXAONE 3.0...