最好用的AI工具
搜尋:音頻
40 個結果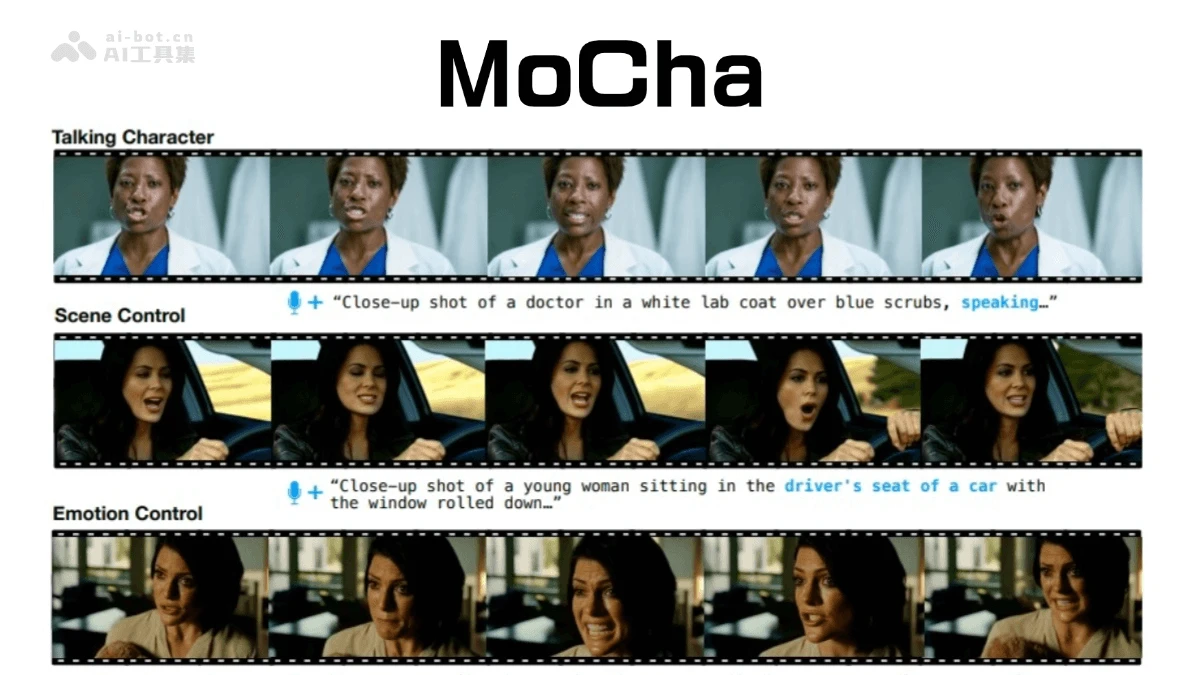
MoCha – Meta 聯合滑鐵盧大學推出的端到端對話角色視頻生成模型
MoCha是什麼 MoCha AI 是 Meta 和滑鐵盧大學聯合開發的端到端對話角色視頻生成模型。能根據文本或語音輸入生成帶有同步語音和自然動作的完整角色動畫。MoCha 採用語音-視頻窗口注意力機制,解決了視頻壓縮時音頻分辨率不匹配以及脣部動作錯位的問題。支持多角色輪換對話,能生成具有情感表達和全身動作的角色動畫。 MoCha的主要功能 語音驅動角色動畫生成:用戶輸入語音,MoCha 可以生成與語音內容同步的角色嘴型、面部表情、手勢及身體動作。 文本驅動角色動畫生成:用戶僅輸入文本腳本,MoCha 會先自動合成語音,再驅動角色進行完整的口型和動作表現。 全身動畫生成:與傳統僅生成面部表情或嘴型的模型不同,MoCha 能生成全身的自然運動,涵蓋嘴脣同步、手勢以及多角色之間的互動。 多角色輪番對話生成:MoCha 提供結構化提示模板與角色標籤,能自動識別對話輪次,實現角色間“你來我往”的自然對話呈現。在多角色場景中,用戶只需定義一次角色信息,可以通過簡單的標籤(如“人物1”“人物2”)在不同的場景中引用這些角色,無需重複描述。 MoCha的技術原理 擴散變壓器(DiT)架構:MoCha 基於擴散變壓器(Diffusion Transformer)架構,通過將文本和語音條件依次通過交叉注意力機制融入模型,有效捕捉語義和時間動態。能生成逼真且富有表現力的全身動作,同時確保角色動畫與輸入語音的精確同步。 語音-視頻窗口注意力機制:爲了解決視頻壓縮和並行生成帶來的語音-視頻對齊問題,MoCha 引入了語音-視頻窗口注意力機制。限制每個視頻標記只能關注與其時間上相鄰的音頻標記,提高口型同步的準確性和語音-視頻對齊效果。模擬了人類語音的運作方式,使角色的口型與對話內容精準匹配。 聯合訓練策略:MoCha 採用了聯合訓練策略,同時基於語音標註和文本標註的視頻數據進行訓練。增強了模型在多樣化角色動作上的泛化能力,通過自然語言提示實現對角色表情、動作、互動和環境的精細控制。 結構化提示模板:爲了簡化多角色對話的文本描述,MoCha 設計了結構化提示模板,通過爲每個角色分配唯一標籤在文本中使用這些標籤來描述角色的動作和互動。減少了冗餘,提高了模型在多角色場景中的生成效果。 多階段訓練框架:MoCha 採用了多階段訓練框架,根據鏡頭類型(如特寫鏡頭、中景鏡頭)對數據進行分類,逐步引入更復雜的任務。確保了模型在不同難度任務上的表現,同時提高了訓練效率。 MoCha的項目地址 項目官網:https://congwei1230.github.io/MoCha/ arXiv技術論文:https://arxiv.org/pdf/2503.23307 MoCha的應用場景 虛擬主播:MoCha 可以自動生成日常 Vlog、角色問答等內容。通過語音或文本輸入,生成與語音內容同步的角色嘴型、面部表情、手勢及身體動作,使虛擬主播更加生動自然。 動畫影視創作:MoCha 支持 AI 自動配音和自動動畫生成,能降低動畫影視創作的製作成本。能生成全身動畫,讓角色動作更加自然,接近電影級數字人演出。 教育內容創作:MoCha 可以作爲 AI 老師角色進行講課或互動。通過文本驅動的方式,生成與教學內容匹配的角色動畫,提高教育內容的趣味性和吸引力。 數字人客服:MoCha 可以用於擬人化企業客服、諮詢角色。通過語音或文本輸入,生成自然流暢的客服對話動畫,提升用戶體驗。
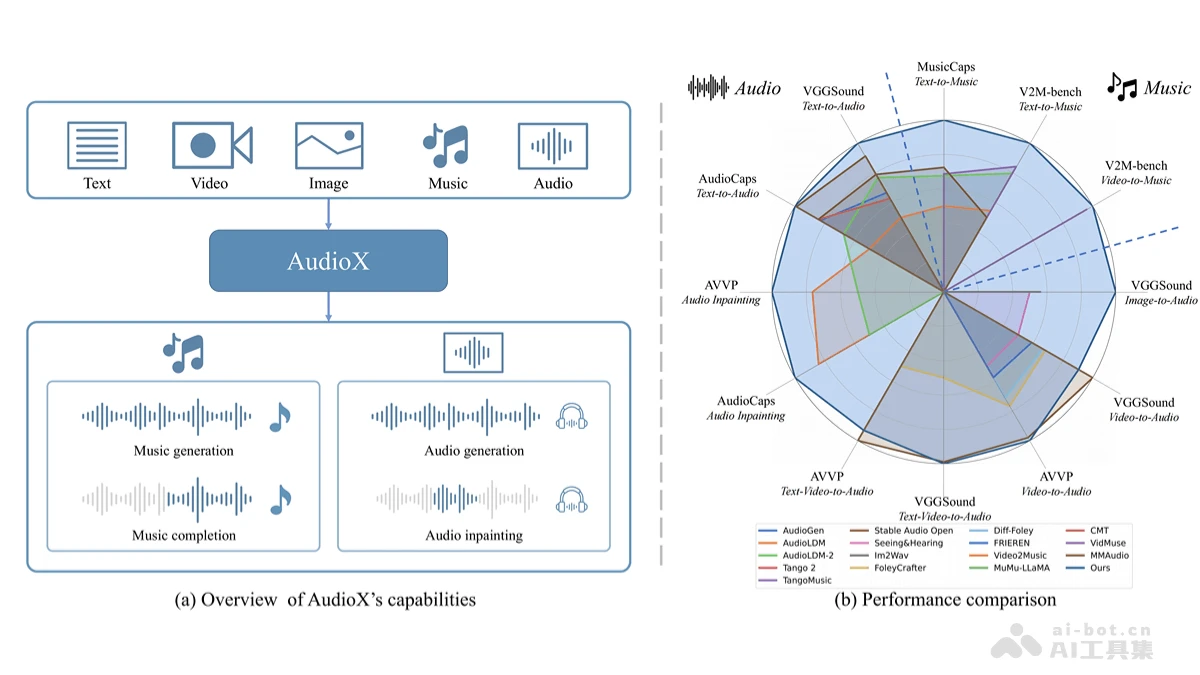
AudioX – 港科大聯合月之暗面推出的擴散變換器模型,任意內容生成音頻
AudioX是什麼 AudioX 是香港...
Zonos – ZyphraAI 開源的多語言 TTS 模型
Zonos是什麼 Zonos是Zyphra推出的高保真文本到語音(TTS)模型。Zonos包含兩個模型:16億參數的Transformer模型和SSM混合模型,均在Apache 2.0許可下開源。Zonos根據文本提示和說話人嵌入生成自然、高表達性的語音,支持語音克隆功能,可調節語速、音高、情感等參數,輸出採樣率爲44kHz。模型基於約20萬小時的多語言語音數據訓練,主要支持英語,對其他語言的支持有限。Zonos提供優化的推理引擎,支持快速生成語音,適合實時應用。 Zonos的主要功能 零樣本TTS與語音克隆:輸入文本和10-30秒的說話者樣本,能生成高質量的TTS輸出。 音頻前綴輸入:基於添加文本和音頻前綴,更精確地匹配說話者的聲音,和實現難以通過說話者嵌入複製的行爲,如耳語。 多語言支持:支持英語、日語、中文、法語和德語。 音頻質量和情感控制:支持精細控制語速、音高、最大頻率、音頻質量和各種情感。 Zonos的技術原理 文本預處理:基於eSpeak工具進行文本歸一化和音素化,將輸入文本轉換爲音素序列。 特徵預測:用Transformer或混合骨幹網絡(Hybrid Backbone)預測DAC(Discrete Audio Codec)標記。 語音生成:基於預測的DAC標記,用自編碼器(Autoencoder)解碼生成高質量的語音輸出。 Zonos的項目地址 項目官網:https://www.zyphra.com/post/beta-release-of-zonos-v0-1 GitHub倉庫:https://github.com/Zyphra/Zonos Zonos的應用場景 有聲讀物與在線教育:將文本內容轉換爲自然流暢的語音,爲有聲讀物和在線課程提供高質量的語音旁白。 虛擬助手與客服:在虛擬助手和客服系統中,生成自然的語音交互,提供更人性化的用戶體驗。 多媒體內容創作:在視頻製作、動畫和廣告中,生成高質量的旁白和配音。 無障礙技術:爲視障人士提供語音閱讀服務,將網頁、文檔和書籍的內容轉換爲語音,幫助他們更好地獲取信息。 遊戲與互動娛樂:在遊戲和互動娛樂應用中,生成角色對話和旁白,增強遊戲的沉浸感。
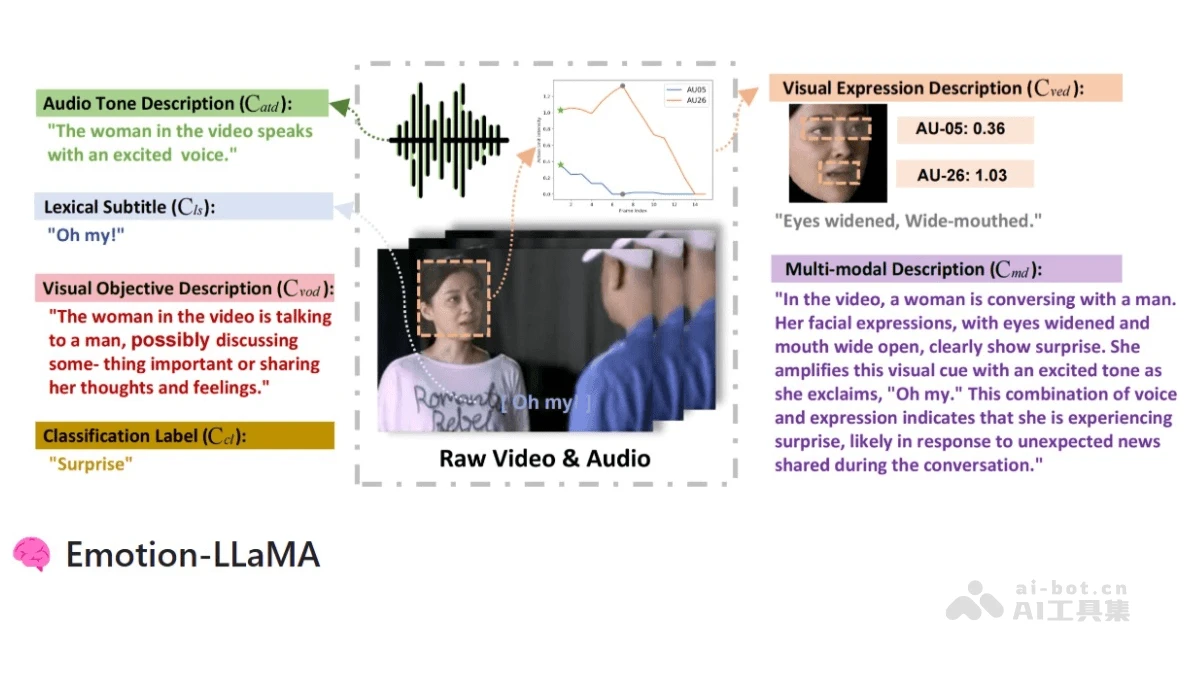
Emotion-LLaMA – 多模態情緒識別與推理模型,融合音頻、視覺和文本輸入
Emotion-LLaMA是什麼 Emotion...
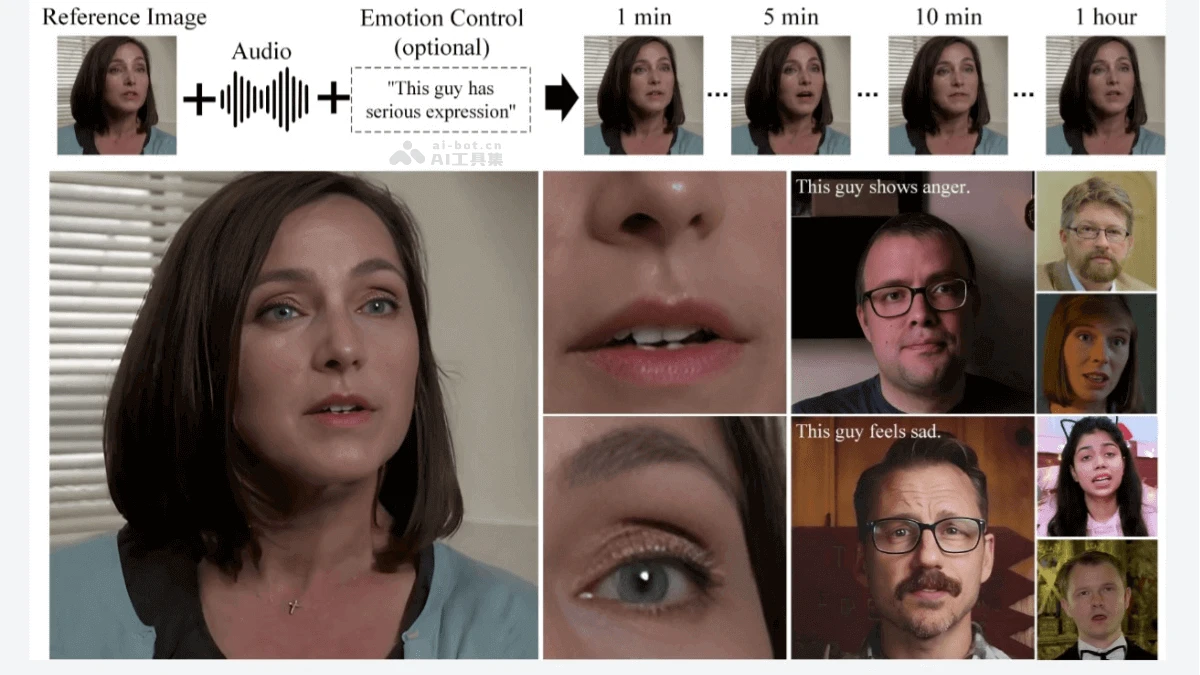
Hallo2 – 復旦、百度和南京大學共同推出的音頻驅動肖像圖像動畫生成模型
Hallo2是什麼 Hallo2是由復旦...
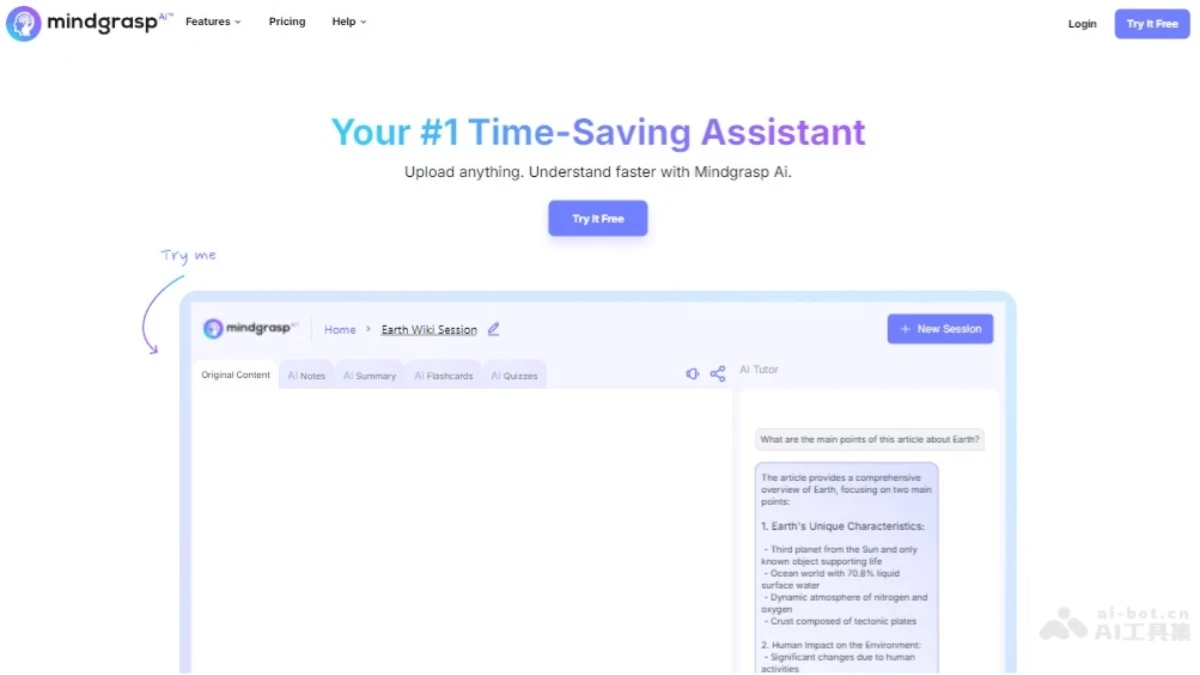
mindgrasp – AI學習和辦公助手,智能生成筆記摘要
mindgrasp是什麼 mindgrasp是一個AI驅動的學習工具,能快速從文檔、PDF、視頻、音頻等多種格式的文件中提取關鍵信息,並生成詳細的筆記、摘要、抽認卡和測驗。基於先進的人工智能技術,幫助用戶提高學習效率,加深對材料的理解。用戶可以上傳文件,提出問題,mindgrasp會即時提供答案和相關信息,是學生和專業人士提升學習和工作效率的得力助手。 mindgrasp的主要功能 智能筆記:自動從上傳的文檔、視頻、音頻等材料中提取關鍵信息,生成結構化的筆記。 問答系統:用戶可以就上傳的內容提出問題,mindgrasp利用AI技術提供準確的答案。 內容摘要:將長文檔或視頻內容進行壓縮,提供簡短的摘要,幫助用戶快速把握核心要點。 抽認卡:自動識別學習材料中的關鍵點,並生成抽認卡,幫助用戶通過間隔重複的方式加強記憶。 文件上傳:支持多種文件格式的上傳,包括PDF、MP3、MP4、PPT等。 網絡搜索:結合互聯網資源,爲用戶的問題提供更全面的答案。 mindgrasp的產品官網 產品官網:mindgrasp.ai mindgrasp的應用場景 學術研究:學生和研究人員可以用mindgrasp從大量文獻中提取關鍵信息,生成筆記和摘要,支持論文寫作和學術研究。 在線學習:在線課程學習者可以用來整理網絡課程內容,創建抽認卡,提高學習效率。 企業培訓:企業可以用mindgrasp來整理培訓材料,生成員工培訓手冊,提高培訓效率。 會議記錄:會議結束後,可以上傳會議錄音,mindgrasp會幫助生成會議紀要和行動項。 語言學習:語言學習者可以用它來分析語言材料,生成語言練習和抽認卡。 法律研究:法律專業人士可以用mindgrasp來分析案件文件,提取關鍵證據和法律條款。
JoyHallo – 京東推出音頻驅動視頻生成的數字人模型
JoyHallo是什麼 JoyHallo 是...
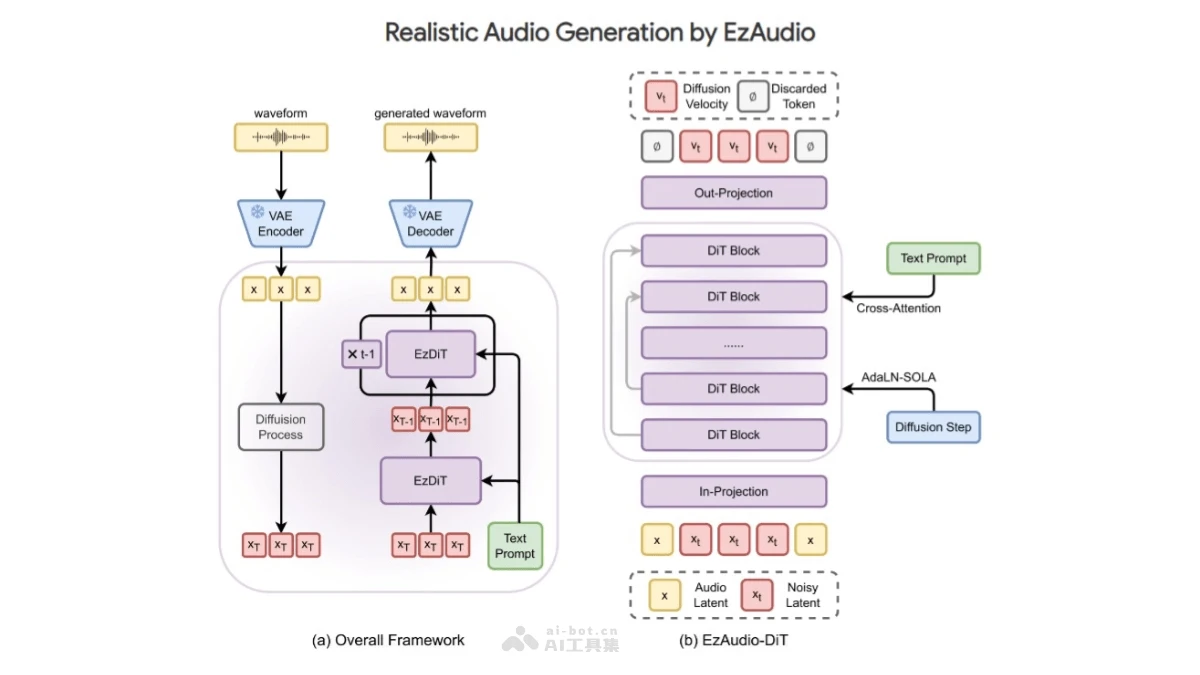
EzAudio – 騰訊聯合約翰霍普金斯大學推出的文本到音頻生成模型
EzAudio是什麼 ...
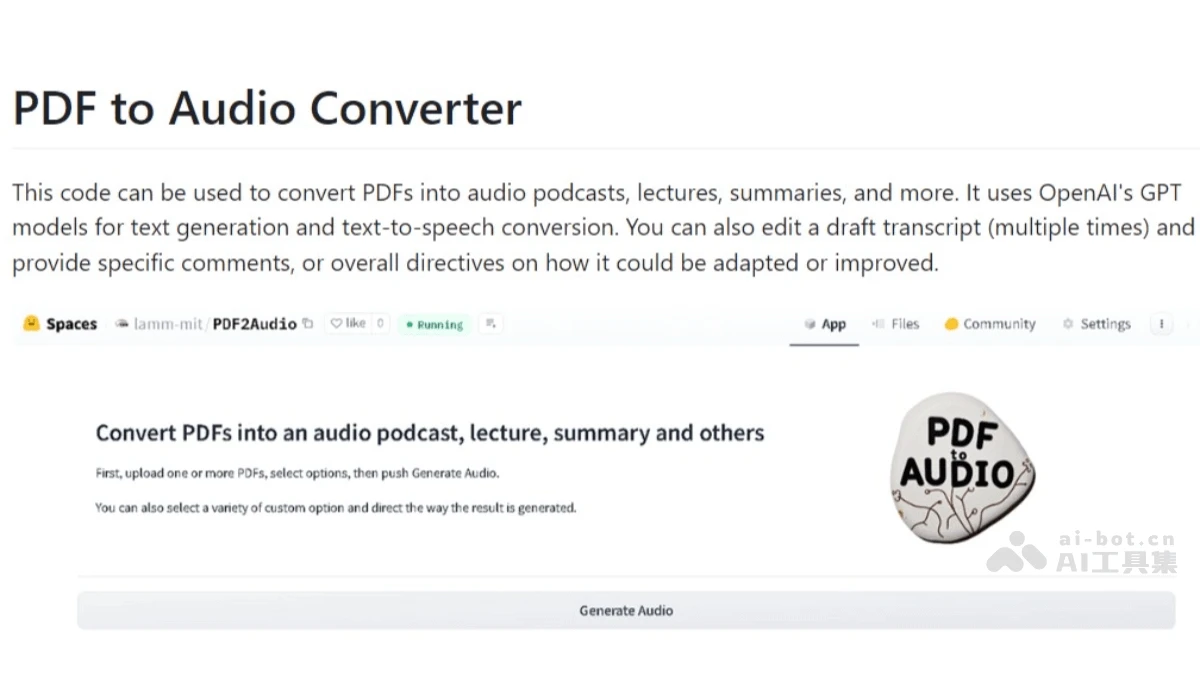
PDF2Audio – 將PDF文檔轉換成音頻博客的開源工具
PDF2Audio是什麼 PDF2Audio ...
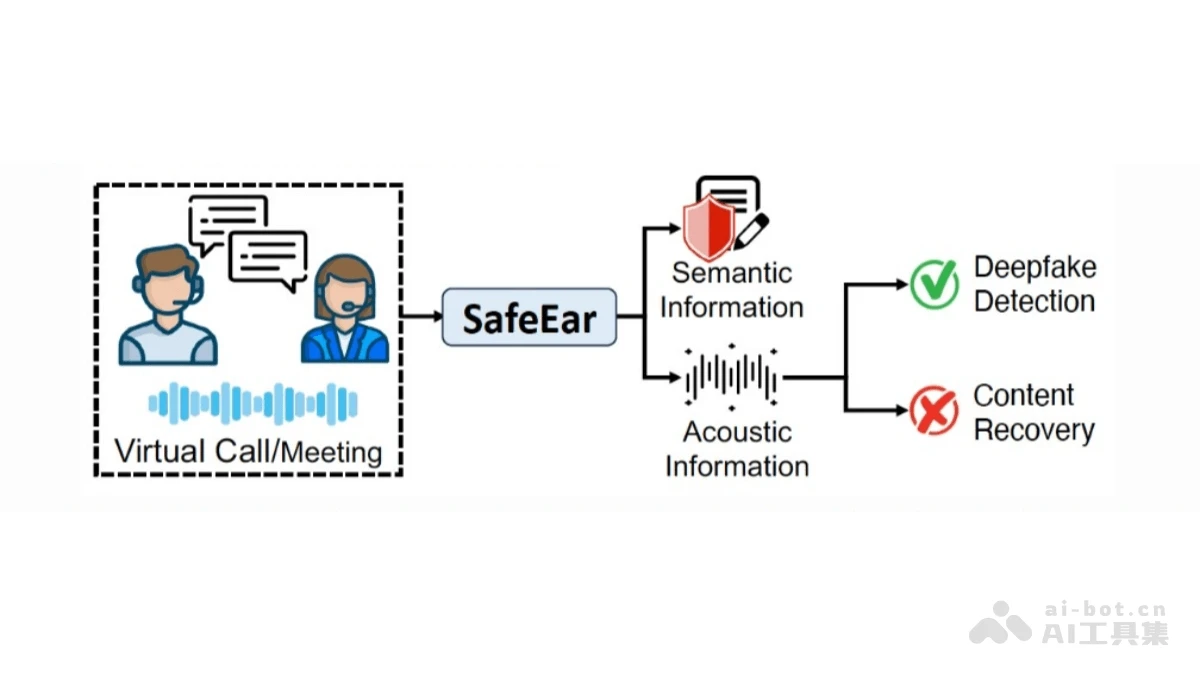
SafeEar – 浙大和清華聯合開源的AI音頻僞造檢測框架
SafeEar是什麼 SafeEar是由浙...
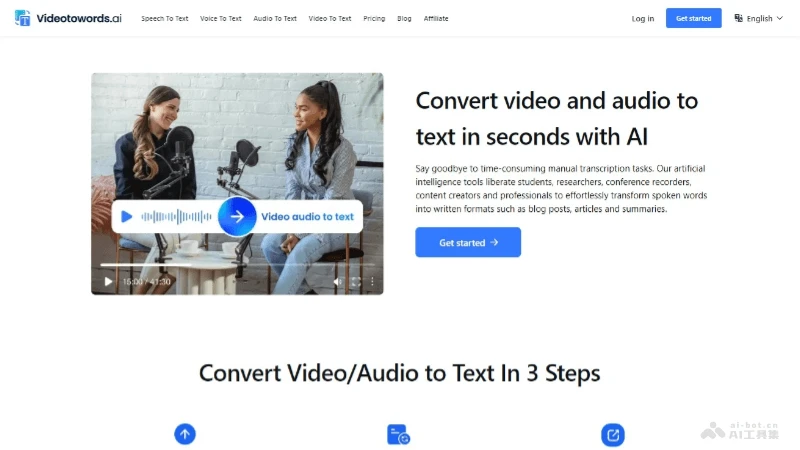
Videotoword.ai – 視頻和音頻轉文字的AI在線平台,準確率高達99.9%
Videotoword.ai是什麼 Videot...
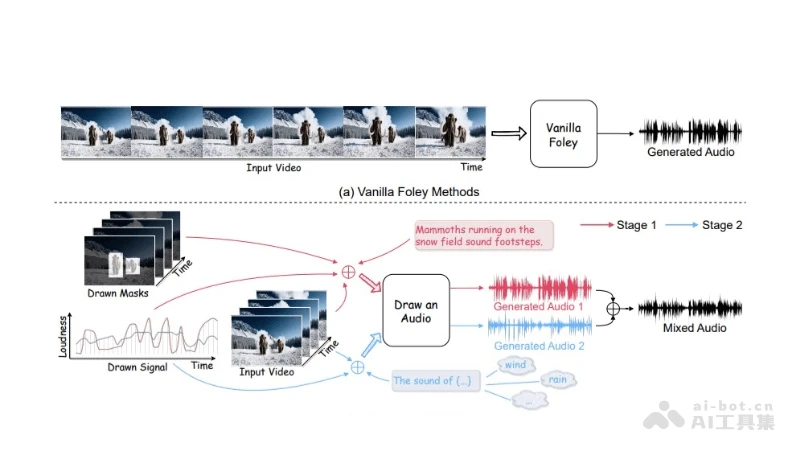
Draw an Audio – 中科院聯合美團推出的視頻生成音頻系統
Draw an Audio是什麼 Draw an...
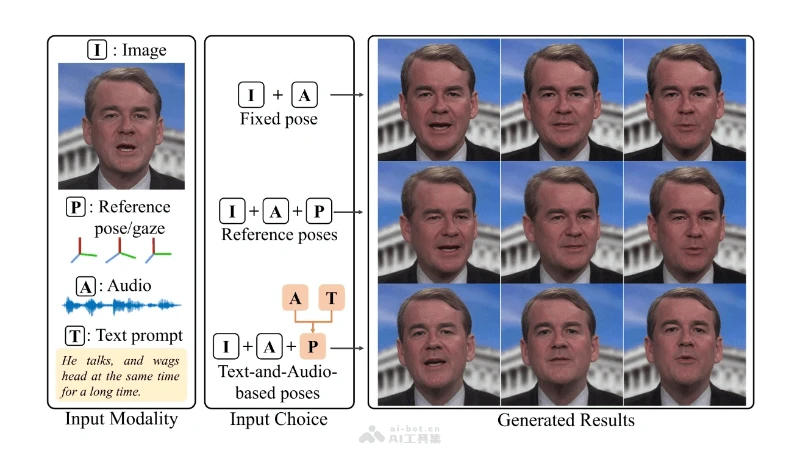
PoseTalk – 文本和音頻驅動的生成會說話的頭部動畫開源項目
PoseTalk是什麼 PoseTalk 是...
Readtheirlips – 脣語識別AI軟件,無音頻也能轉錄口語內容
Readtheirlips是什麼 Readthe...
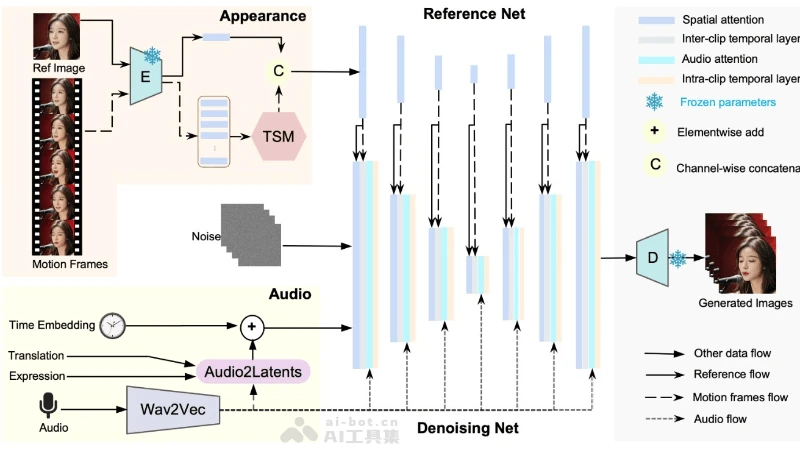
Loopy – 字節跳動推出的音頻驅動的AI視頻生成模型
Loopy是什麼 Loopy是字節跳動...
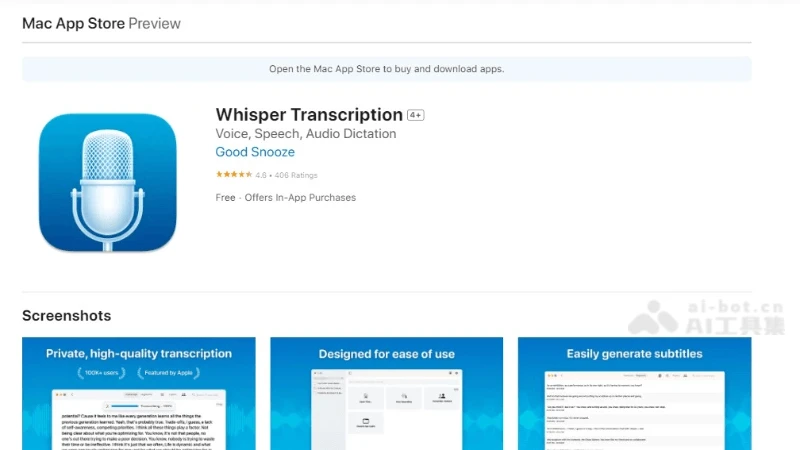
MacWhisper – AI音頻轉文字工具,支持macOS平台
MacWhisper是什麼 MacWhisper...
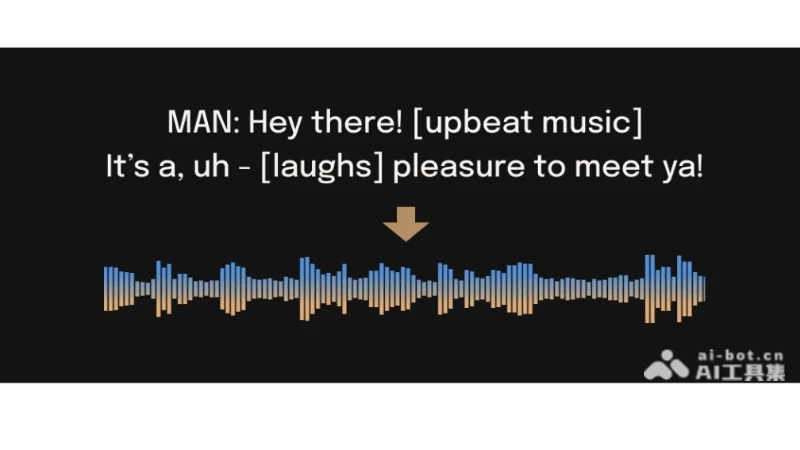
Bark – Suno AI 推出的開源文本到音頻模型
Bark是什麼 Bark是Suno AI 推...
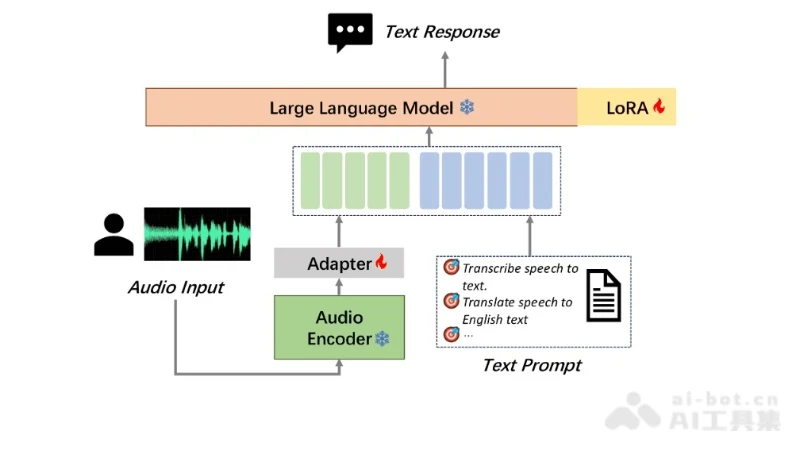
MooER – 摩爾線程推出的業界首個音頻理解大模型
MooER是什麼 MooER是摩爾線程...
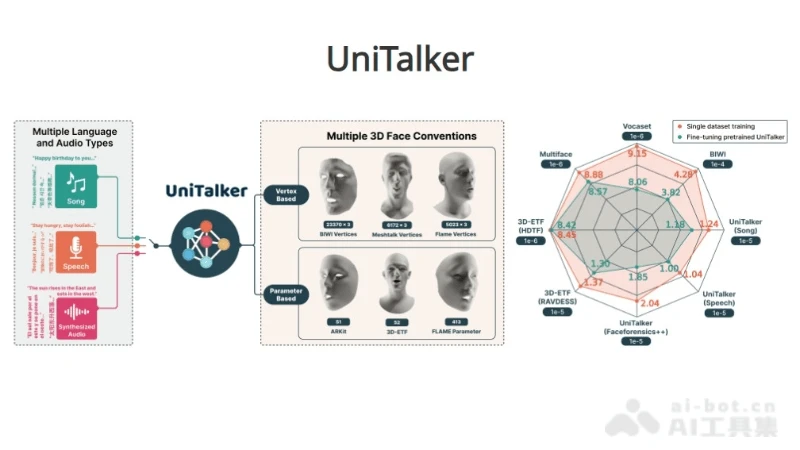
UniTalker – 商湯推出的音頻驅動3D面部動畫生成模型
UniTalker是什麼 UniTalker是...
Moshi – 法國AI實驗室Kyutai開發的實時音頻多模態模型
Moshi是什麼 Moshi是由法國的...