最好用的AI工具
搜尋:谷歌
45 個結果
Veo 3.1 Lite – 谷歌推出的 AI 視頻生成模型
Veo 3.1 Lite是什麼 Veo 3.1 ...
Gemini 3.1 Flash Live – 谷歌推出的實時語音模型
Gemini 3.1 Flash Live是什麼...
TurboQuant – 谷歌推出的向量量化算法
TurboQuant是什麼 TurboQuant...
Lyria 3 Pro – 谷歌推出的 AI 音樂生成模型
Lyria 3 Pro是什麼 Lyria 3 P...

MedGemma 1.5 – 谷歌開源的多模態AI醫療模型
MedGemma 1.5是什麼 MedGemma...

T5Gemma 2 – 谷歌開源的長上下文編碼器-解碼器模型
T5Gemma 2是什麼 T5Gemma 2 是谷歌開源的新型端側多模態長上下文編碼器 – 解碼器模型。模型迴歸優化了經典 Transformer 架構,引入綁定詞嵌入和合併注意力機制等創新,參數規模有 270M – 270M、1B – 1B 和 4B – 4B 等多種版本。模型在多模態性能、長上下文處理以及通用能力上均優於對應規模的 Gemma 3,支持超 140 種語言,適用手機等設備的快速實驗與部署,爲端側 AI 應用開闢了新道路。 T5Gemma 2的主要功能 多模態理解與生成 :同時處理文本和圖像信息,可執行視覺問答、多模態推理等任務,比如根據圖像內容回答相關問題,將圖像信息與文本描述相結合進行生成。 長上下文處理 :具備強大的長上下文能力,能處理長達 128K 個標記的上下文窗口,適合需要長文本理解和生成的場景,如長篇文檔的總結、長故事的續寫等。 編碼 – 解碼功能 :作爲編碼器 – 解碼器模型,將輸入的文本或圖像編碼成向量,通過解碼器生成目標文本,用於翻譯、文本改寫、摘要生成等多種自然語言處理任務。 多語言支持 :支持超過 140 種語言,滿足不同語言環境下的應用需求,實現跨語言的文本處理和生成。 端側高效部署 :模型參數緊湊,適合在手機、瀏覽器等端側設備上快速部署和運行,爲端側應用提供強大的 AI 能力支持。 T5Gemma 2的技術原理 編碼器 – 解碼器架構:T5Gemma 2 採用經典的編碼器 – 解碼器架構,編碼器負責處理輸入(如文本或圖像),生成語義向量;解碼器基於向量生成目標輸出(如文本描述)。 多模態能力:T5Gemma 2 集成一個高效的視覺編碼器(如 SigLIP),將圖像轉換爲 256 個嵌入向量,向量被輸入到編碼器中進行視覺理解。通過將視覺特徵和文本特徵融合,模型能同時處理文本和圖像信息,支持多模態任務,如視覺問答(VQA)和圖像描述生成。 長上下文處理:T5Gemma 2 採用交替局部和全局注意力機制,能處理長達 128K 的上下文窗口,顯著提升長上下文任務的性能。通過調整位置編碼的頻率,模型在處理長序列時能更好地捕捉局部和全局信息。 模型適配技術:T5Gemma 2 的參數初始化來自預訓練的純解碼器模型(如 Gemma 3),通過 UL2 預訓練目標進行適配,繼承預訓練模型的語言理解能力。這種適配策略不僅適用於文本任務,還擴展到了多模態和長上下文任務,證明了其通用性和高效性。 效率優化:T5Gemma 2 將編碼器和解碼器的詞嵌入層綁定在一起,共享參數,顯著減少模型的總參數量,提高模型的效率。將解碼器中的自注意力和交叉注意力合併爲一個統一的模塊,減少模型參數和架構複雜性,同時提高推理效率。 T5Gemma 2的項目地址 項目官網:https://blog.google/technology/developers/t5gemma-2/ HuggingFace模型庫:https://huggingface.co/collections/google/t5gemma-2 arXiv技術論文:https://arxiv.org/pdf/2512.14856 T5Gemma 2的應用場景 視覺問答:通過結合圖像和文本信息,爲用戶提供準確的視覺問答服務,適用於教育、智能客服等領域。 圖像描述生成:自動生成圖像描述文本,幫助用戶快速理解圖像內容,可用於社交媒體和輔助視障人士。 多模態推理:結合圖像和文本進行推理,判斷場景是否符合描述,應用於智能安防和自動駕駛等領域。 跨語言翻譯:將一種語言的文本翻譯成另一種語言,廣泛應用於在線翻譯服務和國際商務溝通。 手機語音助手:在手機上運行,提供語音交互功能,支持語音搜索和指令執行。
谷歌推出AI產品設計指南《The People + Al Guidebook》
《The People + Al Guidebook...
Gemini 2.0 – 谷歌推出的原生多模態輸入輸出 + Agent 爲核心的AI模型
Gemini 2.0是什麼 Gemini 2.0...
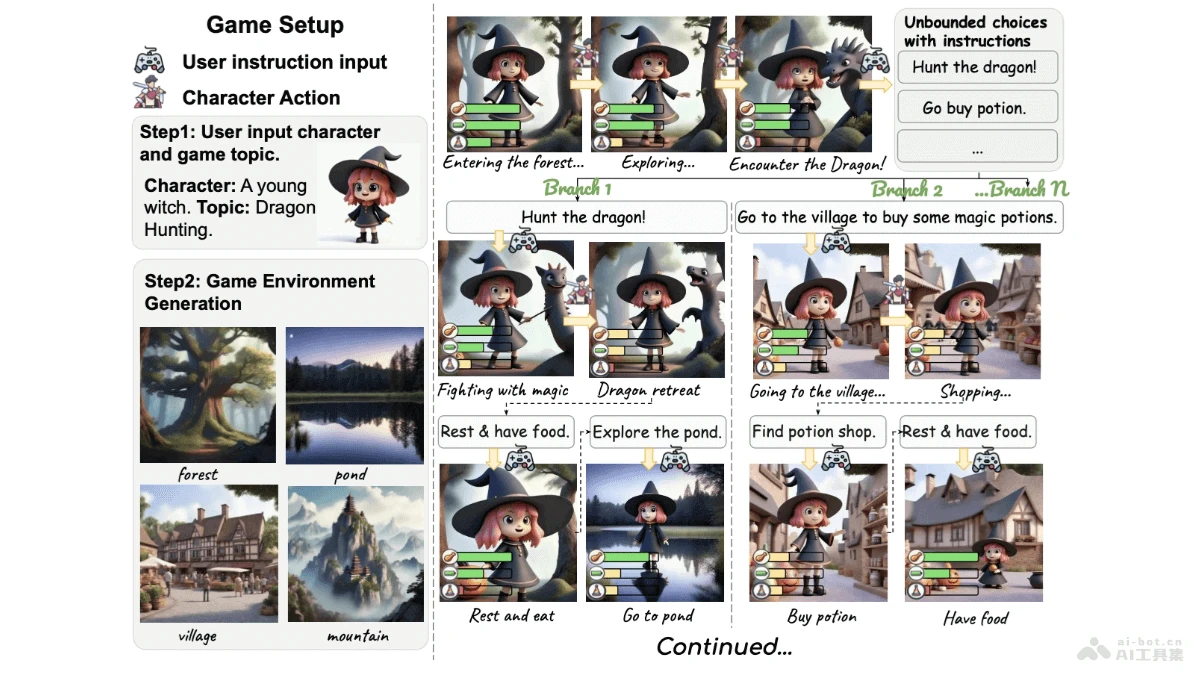
Unbounded – 谷歌聯合北卡羅來納推出的交互式生成式無限遊戲
Unbounded是什麼 Unbounded是...
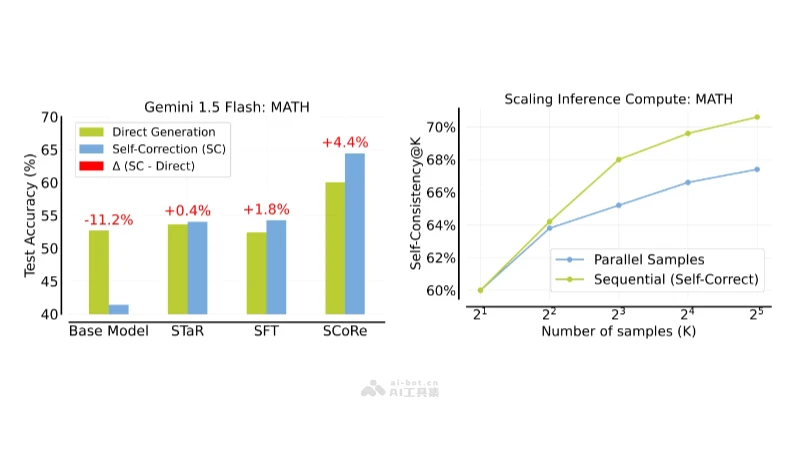
SCoRe – 谷歌DeepMind推出的多輪強化學習方法
SCoRe是什麼 SCoRe(Self-Cor...
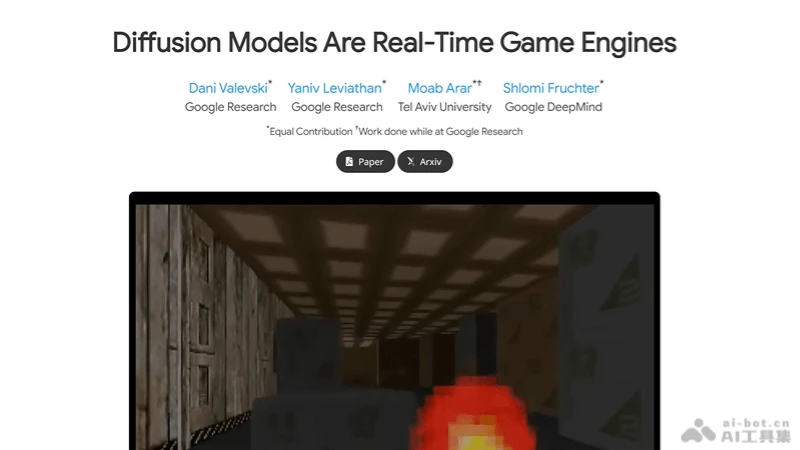
GameNGen – 谷歌推出的首個AI遊戲引擎,生成實時可玩的遊戲
GameNGen是什麼 GameNGen是谷...
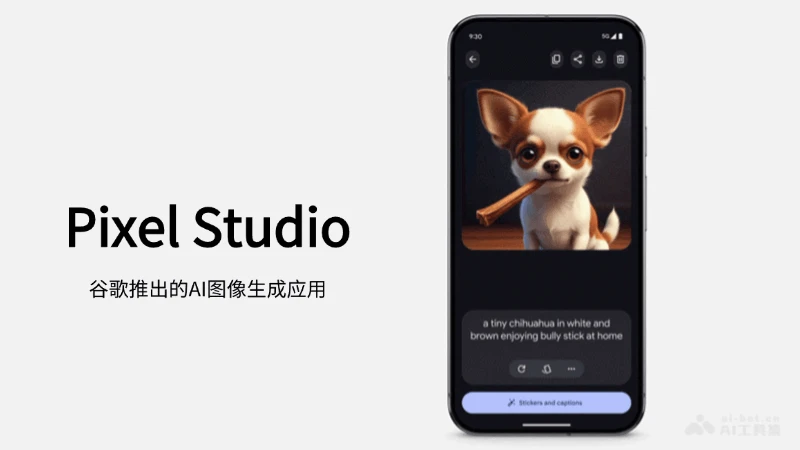
Pixel Studio – 谷歌推出的AI圖像生成應用
Pixel Studio是什麼 Pixel St...
Gemini Live – 谷歌推出的多模態AI語音助手
Gemini Live是什麼 Gemini Li...
Gemma 2 – 谷歌DeepMind推出的新一代開源人工智能模型
Gemma 2是什麼 Gemma 2是谷歌...
谷歌DeepMind推出V2A技術,可爲無聲視頻添加逼真音效
在人工智能領域,谷歌旗下的D...
Veo - 谷歌推出的可生成1分鐘1080P的視頻模型
Veo是什麼 Veo是由Google Dee...
CodeGemma - 谷歌開源推出的代碼生成大模型
CodeGemma是什麼 CodeGemma是...
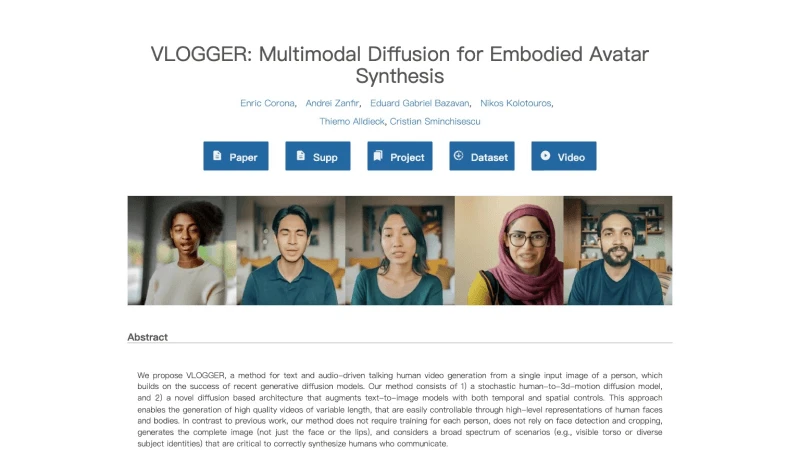
VLOGGER - 谷歌推出的圖像到合成人物動態視頻的模型
VLOGGER是什麼 VLOGGER AI是...
ScreenAI - 谷歌推出的可讀屏AI視覺模型,可理解UI和信息圖表
ScreenAI是什麼 ScreenAI是一...
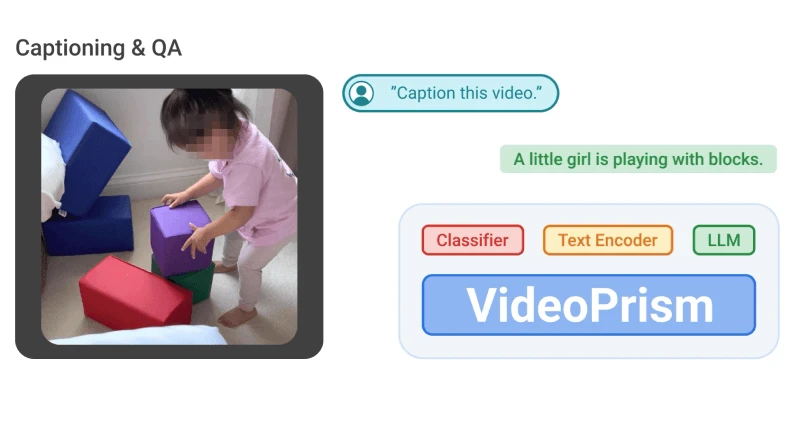
VideoPrism – 谷歌研究團隊推出的通用視頻編碼器
VideoPrism是什麼 VideoPrism...