最好用的AI工具
搜尋:論文
25 個結果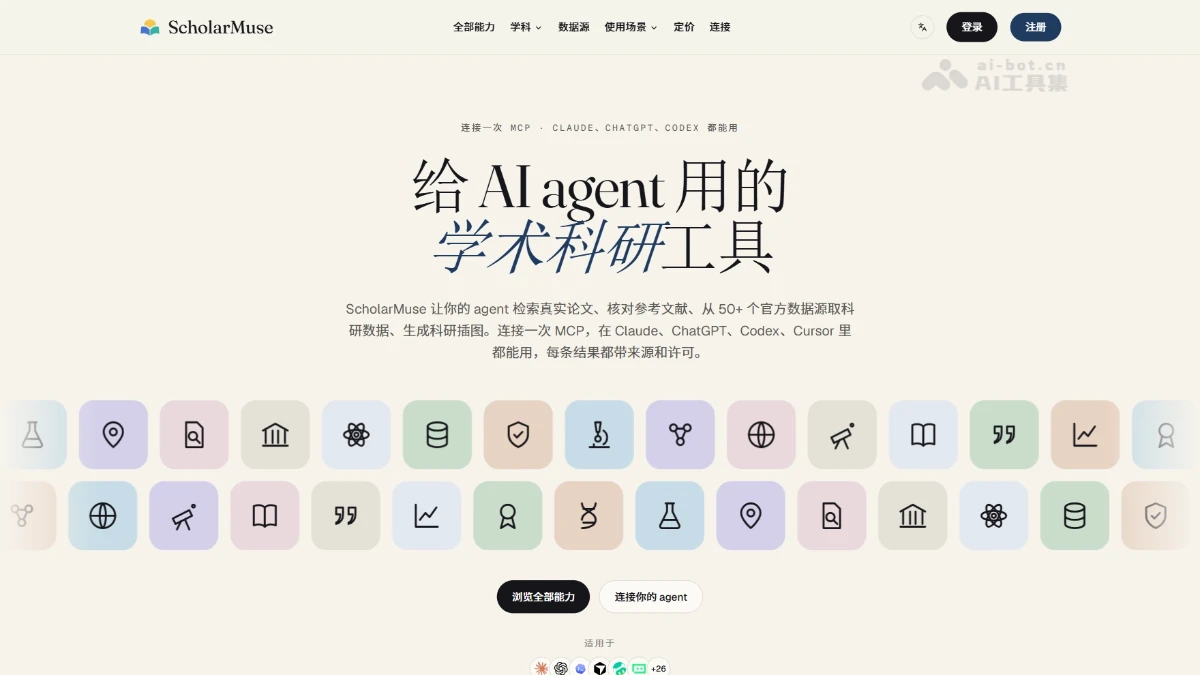
ScholarMuse – 把論文檢索與科研數據接入現有 AI 助手
ScholarMuse是什麼 ScholarMu...
HelixWorld – Noiz AI 聯合港科大開源的實時交互世界模型
HelixWorld是什麼 HelixWorld 是 Noiz AI 與港科大聯合開源的實時交互式音視頻世界模型。給模型一張起始圖片和文字描述,可通過 WASD 和方向鍵在 AI 生成的世界中行走、轉頭,畫面與立體空間音效同步實時生成,且聲像隨視角自然變化。HelixWorld 基於 LTX-2.3 構建,採用”雙向教師 + 因果蒸餾”訓練,單張 H800 顯卡可實現 768×512 分辨率、24 FPS 的實時生成。配套發佈 HelixBench 基準,專門評估空間聲學一致性。 HelixWorld的主要功能 實時可交互世界生成:輸入起始圖片和文字描述,可在 AI 生成的世界中自由探索。 鍵盤/動作操控:WASD 控制移動、方向鍵調整視角,畫面隨操作即時響應。 原生音視頻聯合生成:視頻與立體聲音頻同步生成,非後期配音。 空間聲學一致性:聲像隨鏡頭轉動自然變化,如左側聲源轉身後面向時聲音方向隨之改變。 三軌解耦提示詞:分別用視頻、音頻、音視頻聯合描述控制生成內容。 實時流暢體驗:單張 H800 顯卡上達到 768×512 分辨率、24 FPS 實時生成。 HelixWorld的技術原理 雙向教師模型預訓練:先訓練一個雙向音視頻擴散模型作爲教師:連續 6-DoF 相機軌跡通過 PRoPE 注入視覺注意力,81 類離散動作經 AdaLN-Zero 調製擴散時間步,跨模態注意力把相機運動傳遞到音頻分支,使聲音自然產生立體聲像變化。 因果蒸餾實現實時化:將教師模型蒸餾爲少步因果學生模型:視頻潛變量與音頻 token 分塊處理,塊內雙向注意力、塊間通過 KV cache 因果連接,配合 ODE 初始化使學生能以 4 步完成去噪,滿足實時推理需求。 在線軌跡蒸餾抑制漂移:針對自迴歸長程生成的誤差累積問題,訓練時用教師 Probability Flow ODE 的終點爲目標監督學生速度場,與分佈匹配損失(DMD)隨機交替使用,兼顧生成多樣性與長程穩定性。 長程流式微調:通過滑窗 KV cache 逐段展開長序列訓練,保留 sink 幀錨點、歷史梯度截斷,配合約一分鐘的長序列微調,進一步減少長時間生成中的畫面漂移與聲音退化。 微信關注回覆“開源”,加入AI開源項目交流羣 如何使用HelixWorld 方式一:在線體驗 打開官網 https://helixworld.org,選擇示例圖片或上傳自己的圖片。 填寫場景的文字描述。 進入世界後用 WASD 移動、方向鍵轉動視角,實時探索生成內容。 運行過程中還可隨時修改提示詞,調整後續生成的場景。 方式二:本地部署 環境準備:Linux 系統、Python 3.11、CUDA 12.x、NVIDIA 顯卡(建議 80GB 顯存)、ffmpeg 和 ffprobe。 下載項目並安裝依賴:git clone https://github.com/NoizAI/HelixWorld.git,創建 conda 環境後 pip install -r requirements.txt。 運行 python download_models.py 下載模型權重。 準備一張起始圖片,通過 ./run.sh 指定圖片、畫面/聲音/聯合提示詞、動作序列等參數,生成 MP4 輸出到 outputs 目錄。 HelixWorld的核心優勢 首個開源實時交互式音視頻世界模型:畫面與空間立體聲在用戶操控下聯合實時生成,代碼和權重完全開放。 真正的”轉頭即變聲”:聲像嚴格跟隨視角轉動,空間一致性得分數倍於同類。 單卡即可實時:單張 H800 實現 24 FPS、RTF 0.77 實時生成,速度是同類的 2.5 倍以上。 長程生成不漂移:在線軌跡蒸餾 + 長程微調,30 秒以上連續生成畫面聲音依然穩定,且多樣性不降反升。 音頻質量全面領先:HelixBench 核心指標全面最優,用戶盲測帶音頻場景下以 67.9% 偏好率碾壓對手。 HelixWorld的項目地址 項目官網:https://helixworld.org/ GitHub倉庫:https://github.com/NoizAI/HelixWorld arXiv技術論文:https://arxiv.org/pdf/2609.38123 HelixWorld的應用場景 沉浸式遊戲原型:無需建模和引擎,輸入圖片即可生成可行走探索的開放世界,大幅縮短遊戲 Demo 開發週期。 VR/AR 虛擬空間:第一人稱視角 + 空間音頻的組合天然適配頭顯設備,可快速生成虛擬展廳、數字孿生環境。 影視與廣告預演:導演上傳概念圖即可”走進”場景試聽音畫效果,在實拍前低成本驗證鏡頭語言和氛圍設計。 AI 視頻通話/虛擬主播背景:根據語音
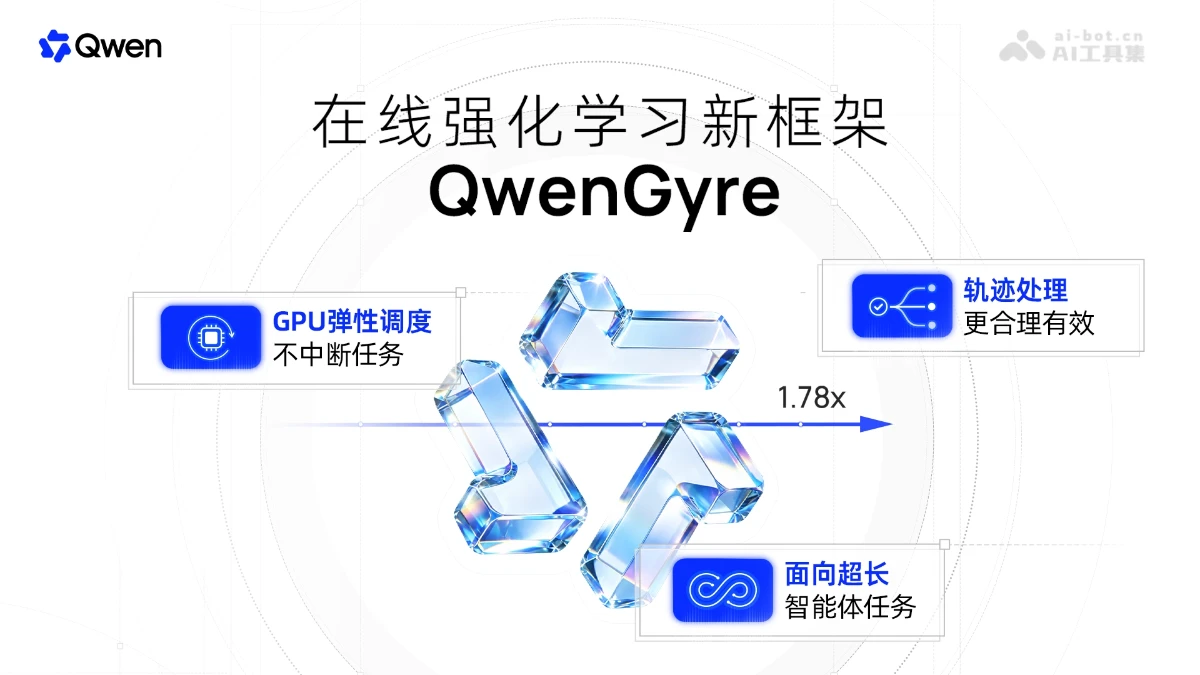
QwenGyre – 阿里千問推出的在線強化學習框架
QwenGyre是什麼 QwenGyre 是阿里千問推出的超長程智能體在線強化學習框架,面向單次約 70 萬 token、持續數小時的任務。QwenGyre用彈性調度在任務不中斷時把空閒 GPU 在採樣與訓練間切換,用軌跡處理保留真實上下文、評估部分成果、去重共享前綴以控制成本。在 Qwen3.8-2.4T 上 48 步把 NL2RepoBench 通過率從 52.48% 提至 58.54%,較 Async 端到端加速 1.78×。 QwenGyre的主要功能 超長程智能體在線強化學習:在單次執行長達數小時、累計約百萬 token 的任務上直接做 RL 訓練。 彈性 GPU 調度:任務不中斷的情況下,動態把空閒 GPU 在採樣與訓練間切換。 請求重路由與 KV cache 遷移:切換 GPU 角色時智能體繼續運行,工作區和工具狀態保留,通過 RDMA 遷移 KV cache 減少重複計算。 流式訓練與新節點中途加入:核心 cell 保存權威參數,衛星 cell 可隨時拉取快照加入正在進行的批次,按進度領取微批次。 軌跡樹與真實上下文保留:用 Token-in Token-out 記錄每次調用的精確輸入輸出,按共享前綴組織成軌跡樹,輸出始終對應生成時的上下文。 部分評分(Partial Scoring):超時未完成的任務若產出可檢驗成果,仍按任務規則評分並用於訓練。 軌跡預算與損失均衡:每個執行最多保留 Jmax 條軌跡,共享前綴只計一次損失,避免分支多的任務權重過大。 QwenGyre的技術原理 彈性調度(Elastic Scheduler):將 GPU 劃分爲若干同構計算單元,每個 cell 能用 SGLang 提供採樣服務,也能用 Megatron 承載完整訓練副本。調度器跟蹤”水位”,未完成任務量,只要剩餘採樣容量足以支撐在跑任務且訓練數據供應充足,就按序把 cell 逐個切入訓練;切換時由代理把模型請求重定向到新推理引擎並重試未完成請求,後端進程和通信組無需重建。核心 cell 持有權威權重與優化器狀態,衛星 cell 通過 RDMA 拉取參數快照後加入當前批次的梯度累計,最後由核心統一彙總更新,實現訓練隨數據就緒逐步擴容、採樣與訓練高度重疊。 軌跡處理(Trajectory Processor):QwenGyre 通過代理記錄每次模型調用的精確輸入/輸出 token ID 和行爲策略對數概率,把共享前綴複用、分叉處建分支,組織成軌跡樹,保證每條輸出始終對應其生成時的原始上下文。訓練准入階段按角色優先級爲每個執行選取不超過 Jmax 條軌跡,僅策略模型生成的 token 參與損失、共享目標只計一次;損失先在執行內對選中 token 取平均、再對執行取平均,使執行權重與其分支數量解耦。配合 Partial Scoring 對超時任務的已完成部分評估打分,最大化利用超長程執行中稀疏而昂貴的有效信號。 如何使用QwenGyre 目前 QwenGyre 用論文形式發佈,阿里尚未公開代碼與安裝包。 QwenGyre的核心優勢 首次實現旗艦模型超長程在線 RL:在 Qwen3.8-2.4T 上完成單次約 70 萬 token 任務的在線強化學習,48 步將 NL2RepoBench 通過率從 52.48% 提升至 58.54%。 訓練效率大幅提升:相同 GPU 預算下端到端加速最高達 1.78×(對 Async)、1.85×(對 Colocate),48 步訓練耗時從 134.55 小時縮短至 75.42 小時。 任務零中斷的彈性調度:GPU 在採樣與訓練間動態切換時,智能體執行、工作區和工具狀態完全保留,切換耗時僅數秒,相對數小時的執行可忽略。 GPU 利用率最大化:細粒度 cell 級資源分配消除了 Colocate 模式的長尾等待空轉和 Async 模式的固定分區僵化,訓練可被採樣完全隱藏。 真實上下文保真訓練:TITO 機制保證每條輸出都對應其生成時的原始上下文,避免歷史壓縮、子智能體上下文拼接導致的”虛假上下文”訓練信號。 QwenGyre的項目地址 arXiv技術論文:https://arxiv.org/pdf/2609.33848 QwenGyre的應用場景 自然語言生成完整代碼倉庫:根據自然語言規格從零構建多包軟件倉庫,單次執行約 70 萬 token、長達數小時。 已有倉庫的長程軟件工程:在現有代碼庫中完成功能開發、缺陷修復與跨文件改造等複雜任務。 多輪終端自動化操作:智能體在命令行環境中連續執行數百輪工具調用,完成系統配置與運維任務。 大規模代碼庫重構遷移:跨倉庫技術棧升級、整體重構等需要數小時連續規劃執行的工程任務。 多智能體協作任務:主智能體委派子智能體的層級執行場景,
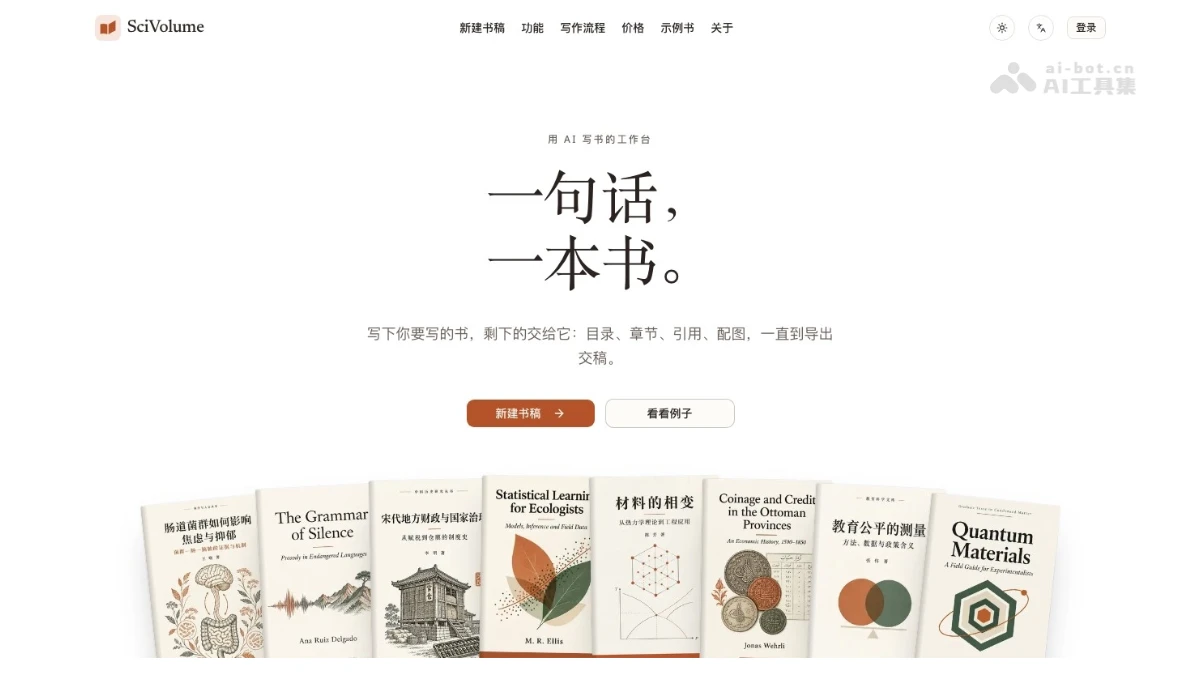
SciVolume – AI 寫書工作台,引用文獻真實可查
SciVolume是什麼 SciVolume 是專爲寫整本書設計的 AI 工作台,目標用戶是想把研究成果、講義或專業知識整理成書的高校教師、研究者與行業作者。用戶輸入題目、上傳論文或講義,AI 先生成目錄,確認後在後台逐章寫出初稿,只引用真實文獻,每段標註材料來源、每條引用可逐條覈查。SciVolume支持 AI 潤色、配圖與封面生成、術語統一、全書檢查、整本翻譯,最終導出 Word、LaTeX 或 PDF 書稿,適用專著、教材、行業手冊和科普讀物。 SciVolume的主要功能 目錄生成: 輸入題目一分鐘生成章節目錄,可自由改名、調序、增刪。 後台成書: 確認目錄後 AI 逐章自動寫作,完成後郵件通知,無需守在頁面。 真實文獻引用: 寫作時實時檢索學術索引,只引用真實文獻並自動生成參考文獻表。 資料導入: 支持 PDF、Word、Markdown、TXT、BibTeX、RIS 等格式,也可導入舊書稿。 引用格式切換: APA、Chicago、MLA、Harvard、IEEE、Nature、GB/T 7714 等一鍵全書切換。 AI 配圖與封面: 一句話生成配圖(每次三張候選)、公式、三線表和整書封面,編號自動管理。 AI 編輯助手: 選中段落即可潤色、擴寫、精簡,改動對比呈現,確認後才生效。 全書檢查: 統一術語、排查重複與前後矛盾,並逐條覈查引用是否被原文支持。 整本翻譯: 先定術語表再逐段翻譯,保留引用、公式與圖片,生成獨立譯本。 教材配套: 自動生成學習目標、章節小結、習題與答案、課件、教學大綱、前言、術語表和索引。 書稿導出: 輸出含封面、圖片、腳註與參考文獻的 Word 或 LaTeX 書稿包,可打印爲 PDF。 如何使用SciVolume 訪問官網:訪問SciVolume官網 https://scivolume.ai/zh/。 新建書稿: 訂閱後點擊「新建書稿」,寫下書名,上傳參考資料或導入已有的舊稿。 確認目錄: 調整 AI 生成的章節結構,確認無誤後開始後台自動寫作。 審閱修改: 逐章檢查初稿,用 AI 助手潤色擴寫,並生成所需配圖與封面。 全書覈查: 運行全書檢查和引用覈查,集中處理術語不一致和引用問題。 導出交稿: 確認定稿後導出 Word / LaTeX / PDF 書稿包,即可投稿或出版。 SciVolume的核心優勢 不編造文獻:引用只來自學術索引檢索結果或你上傳的資料,並能逐條覈對原文。 來源可追溯:每段標註材料來源比例,AI 補寫的部分一目瞭然,便於重點審讀。 面向「一本書」設計:目錄、正文、圖表、封面、譯本、教材配套都在同一個項目中完成。 全書一致:術語檢查、自動編號、引用格式一鍵切換,保證整本書風格統一。 中文學術友好:原生支持 GB/T 7714 和中文書稿,適合國內高校與科研院所。 數據安全:書稿不會用於訓練模型;中文界面,支持支付寶付款。 SciVolume的同類競品對比 對比項 SciVolume 通用 AI 聊天機器人 完全自己寫 整書結構 目錄驅動,逐章後台生成 一段段對話拼接 全部手工 參考文獻 檢索真實文獻,逐條覈查 可能編造,需自己核 手工檢索整理 來源標註 每段標註材料來源 無 無 術語與格式一致 全書檢查,一鍵切換格式 難以保證 靠人工反覆校對 配圖、公式、封面 一句話生成,自動編號 需另找工具 另找工具或外包 整本翻譯 術語表 + 逐段對照 需分段複製 另請譯者 導出交稿 Word / LaTeX / PDF 書稿包 需自行排版 需自行排版 SciVolume的應用場景 學術專著:把多年研究成果整理爲一本引用規範的專著。 博士論文出版:導入博士論文,重組章節,擴寫爲面向更廣讀者的學術圖書。 大學教材:基於講義編寫教材,並配套習題、課件與教學大綱。 行業手冊與白皮書:爲企業、機構撰寫資料可溯源的技術手冊和研究報告。 科普圖書:把專業知識寫成通俗、有據可查的科普讀物。 翻譯出版:將中文書稿譯爲英文(或反之),逐段對照,保留引用、公式與圖片。
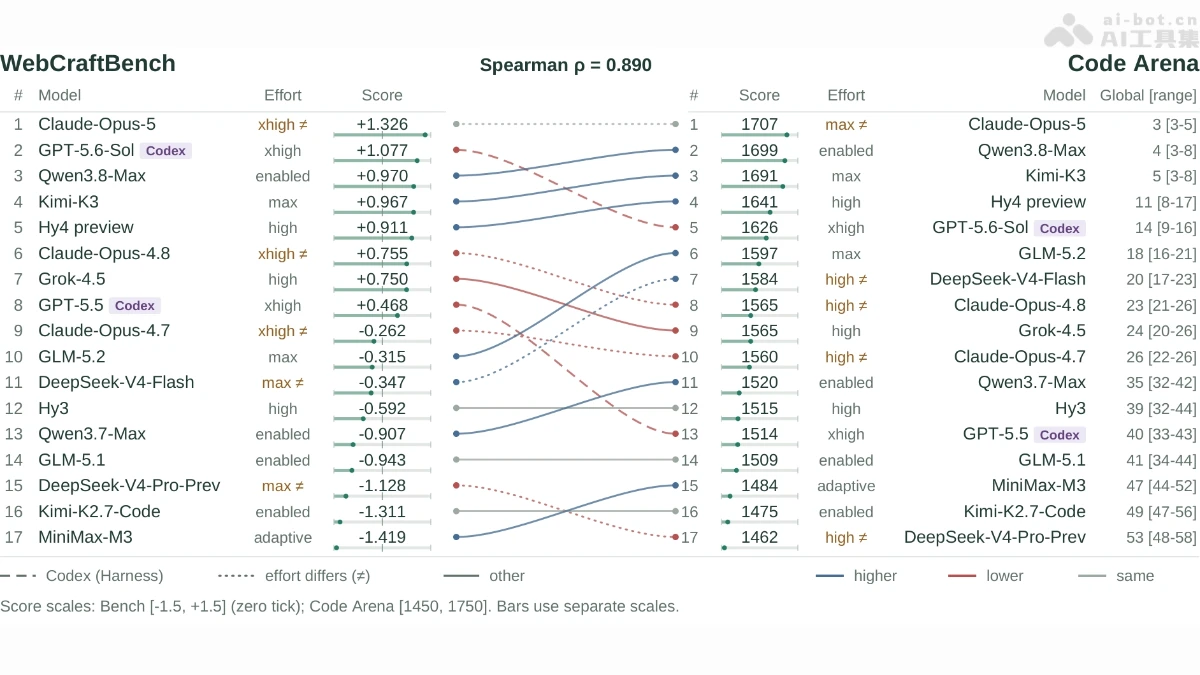
WebCraftBench – 騰訊聯合清華推出的AI網頁生成評測基準
WebCraftBench是什麼 WebCraftBench 是騰訊混元聯合清華、北大推出的 AI 網頁生成評測基準。WebCraftBench先給生成應用自動插樁,讓智能體通過 Playwright 實際操作網頁探索功能,用代碼覆蓋率引導查漏;再將交互記錄抽象成狀態圖,從美觀度、易用性、需求符合度三個維度分別打分。基準含 369 條真實需求、5,088 條人工覈驗的驗收標準,覆蓋 17 個前沿模型的 6,273 個應用,與人類偏好一致率達 85.3%。 WebCraftBench的主要功能 真實需求評測集:包含 369 條來自真實使用流量的用戶需求,配 5,088 條經人工覈驗的驗收標準,覆蓋功能、內容、視覺三類要求。 交互式自動探索:智能體通過 Playwright MCP 像測試人員一樣點擊、輸入、切換頁面,主動發現功能並測試邊界情況。 代碼覆蓋率引導:基於 Istanbul 自動插樁,實時監測覆蓋率,發現探索不足時由輔助模型提示未觸達的代碼方向。 狀態抽象與整理:將冗長的操作記錄去重、規範化,合併爲狀態轉移圖,提煉關鍵運行證據供評分使用。 三維獨立評分:分別評估美觀度、易用性、需求符合度,合成標準化綜合分。 人類偏好驗證:在獨立驗證集上與經複覈的人工投票對比,成對判斷一致率達 85.3%,驗證評測可靠性。 WebCraftBench的技術原理 自動插樁收集運行證據:系統在應用代碼中注入計數器,支持靜態 HTML、Vite、Next、CRA、Astro 等框架。應用啓動後,每次交互都會回傳代碼覆蓋率及增量,讓”哪些代碼被執行過”變得可觀測。 覆蓋率引導的智能體探索:探索智能體不看不源碼、不看驗收清單,按 GUI 測試流程操作網頁。當連續三次交互沒有帶來新增覆蓋時,系統請另一個模型分析尚未執行的代碼,將建議轉成自然語言交給探索智能體繼續嘗試。 狀態抽象壓縮交互軌跡 對頁面結構做規範化處理,相同頁面合併爲同一狀態,操作連接爲狀態轉移圖。避免重複截圖擠佔評分模型的上下文,讓故障路徑一目瞭然。 探索與評分分離的多維打分:探索階段收集證據時不看驗收清單,評分階段才逐條對照標準檢索證據。美觀度和易用性採用”找優點—挑缺陷—裁判定分”的三輪評議(;需求符合度每條判斷必須引用運行證據,按滿足比例計分。三個維度各佔綜合分三分之一。 如何使用WebCraftBench 準備生成應用:讓被評測的模型根據需求生成網頁應用,部署爲可運行狀態。 自動插樁:運行 WebCraftBench 的插樁工具,在應用代碼中注入覆蓋率計數器,使每次交互都能回傳代碼執行信息。 交互探索:啓動探索智能體,通過 Playwright MCP 操作網頁,執行點擊、輸入、切換頁面等動作,主動發現功能並測試邊界情況。 覆蓋率引導查漏:當連續三次交互無新增覆蓋時,系統由輔助模型分析未執行代碼,生成自然語言建議交給探索智能體繼續探索(最多 100 步)。 整理運行證據:系統自動對頁面結構做狀態抽象,將操作記錄去重合併爲狀態轉移圖,保留截圖與交互軌跡。 三維評分:評分智能體分別評估美觀度、易用性,逐條對照驗收標準檢查需求符合度,每條判斷須引用運行證據。 輸出結果:獲得三個維度的標準化分數及綜合總分,可與模型池排名對比,分差越大結果越可信。 WebCraftBench的核心優勢 實測導向:讓智能體真實操作網頁打分,而非只看代碼或截圖,能發現”入口按鈕壞了、首頁打不開”這類靜態評測漏掉的問題。 覆蓋率引導探索:用代碼覆蓋率做”查漏線索”,測試智能體找不到功能時由後台模型提示方向,減少把探索失敗誤判爲產品缺陷。 探索與評分分離:驗收清單隻在評分階段使用,既保留需求約束,又不限制清單之外的交互被觀察,擴大評測覆蓋範圍。 多維獨立評分:美觀度、易用性、需求符合度分開打分,避免”顏值高但一用就崩”的模型被單一總分掩蓋短板。 人類偏好高度一致:在 197 組經複覈的人工對比中判斷一致率達 85.3%,分差大時(≥0.75)一致率升至 98%,結果可信度高。 評測穩定性強:更換評分裁判模型後排名相關係數仍達 0.980,前四名順序不變,結論不依賴單一裁判。 WebCraftBench的項目地址 arXiv技術論文:https://arxiv.org/pdf/2609.15387 WebCraftBench的同類競品對比 對比維度 WebCraftBench WebArena 評測對象 AI 生成的網頁應用質量 智能體在現成真實網站上的任務完成能力 核心問題 “AI 寫的網頁好不好?” “智能體會不會用網頁?” 被測主體 生成模型(Claude、GPT、Qwen 等) 智能體(Agent)本身 評
Nature Skills – 開源的 AI 科研技能庫,聚焦論文全流程
Nature Skills是什麼 Nature ...
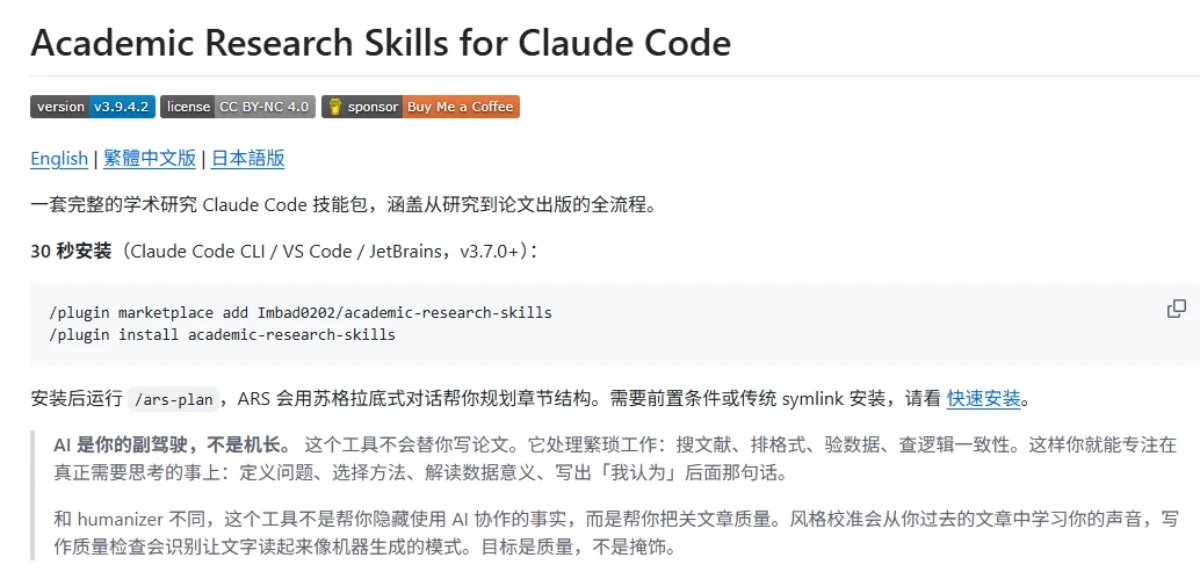
Claude Code學術研究技能包ARS,覆蓋論文寫作全流程
今天發點適合學術黨的東西。 ...
Paperpal – AI英文論文寫作工具,百萬篇學術文獻訓練而成
Paperpal是什麼 Paperpal是AI...

T5Gemma 2 – 谷歌開源的長上下文編碼器-解碼器模型
T5Gemma 2是什麼 T5Gemma 2 是谷歌開源的新型端側多模態長上下文編碼器 – 解碼器模型。模型迴歸優化了經典 Transformer 架構,引入綁定詞嵌入和合併注意力機制等創新,參數規模有 270M – 270M、1B – 1B 和 4B – 4B 等多種版本。模型在多模態性能、長上下文處理以及通用能力上均優於對應規模的 Gemma 3,支持超 140 種語言,適用手機等設備的快速實驗與部署,爲端側 AI 應用開闢了新道路。 T5Gemma 2的主要功能 多模態理解與生成 :同時處理文本和圖像信息,可執行視覺問答、多模態推理等任務,比如根據圖像內容回答相關問題,將圖像信息與文本描述相結合進行生成。 長上下文處理 :具備強大的長上下文能力,能處理長達 128K 個標記的上下文窗口,適合需要長文本理解和生成的場景,如長篇文檔的總結、長故事的續寫等。 編碼 – 解碼功能 :作爲編碼器 – 解碼器模型,將輸入的文本或圖像編碼成向量,通過解碼器生成目標文本,用於翻譯、文本改寫、摘要生成等多種自然語言處理任務。 多語言支持 :支持超過 140 種語言,滿足不同語言環境下的應用需求,實現跨語言的文本處理和生成。 端側高效部署 :模型參數緊湊,適合在手機、瀏覽器等端側設備上快速部署和運行,爲端側應用提供強大的 AI 能力支持。 T5Gemma 2的技術原理 編碼器 – 解碼器架構:T5Gemma 2 採用經典的編碼器 – 解碼器架構,編碼器負責處理輸入(如文本或圖像),生成語義向量;解碼器基於向量生成目標輸出(如文本描述)。 多模態能力:T5Gemma 2 集成一個高效的視覺編碼器(如 SigLIP),將圖像轉換爲 256 個嵌入向量,向量被輸入到編碼器中進行視覺理解。通過將視覺特徵和文本特徵融合,模型能同時處理文本和圖像信息,支持多模態任務,如視覺問答(VQA)和圖像描述生成。 長上下文處理:T5Gemma 2 採用交替局部和全局注意力機制,能處理長達 128K 的上下文窗口,顯著提升長上下文任務的性能。通過調整位置編碼的頻率,模型在處理長序列時能更好地捕捉局部和全局信息。 模型適配技術:T5Gemma 2 的參數初始化來自預訓練的純解碼器模型(如 Gemma 3),通過 UL2 預訓練目標進行適配,繼承預訓練模型的語言理解能力。這種適配策略不僅適用於文本任務,還擴展到了多模態和長上下文任務,證明了其通用性和高效性。 效率優化:T5Gemma 2 將編碼器和解碼器的詞嵌入層綁定在一起,共享參數,顯著減少模型的總參數量,提高模型的效率。將解碼器中的自注意力和交叉注意力合併爲一個統一的模塊,減少模型參數和架構複雜性,同時提高推理效率。 T5Gemma 2的項目地址 項目官網:https://blog.google/technology/developers/t5gemma-2/ HuggingFace模型庫:https://huggingface.co/collections/google/t5gemma-2 arXiv技術論文:https://arxiv.org/pdf/2512.14856 T5Gemma 2的應用場景 視覺問答:通過結合圖像和文本信息,爲用戶提供準確的視覺問答服務,適用於教育、智能客服等領域。 圖像描述生成:自動生成圖像描述文本,幫助用戶快速理解圖像內容,可用於社交媒體和輔助視障人士。 多模態推理:結合圖像和文本進行推理,判斷場景是否符合描述,應用於智能安防和自動駕駛等領域。 跨語言翻譯:將一種語言的文本翻譯成另一種語言,廣泛應用於在線翻譯服務和國際商務溝通。 手機語音助手:在手機上運行,提供語音交互功能,支持語音搜索和指令執行。
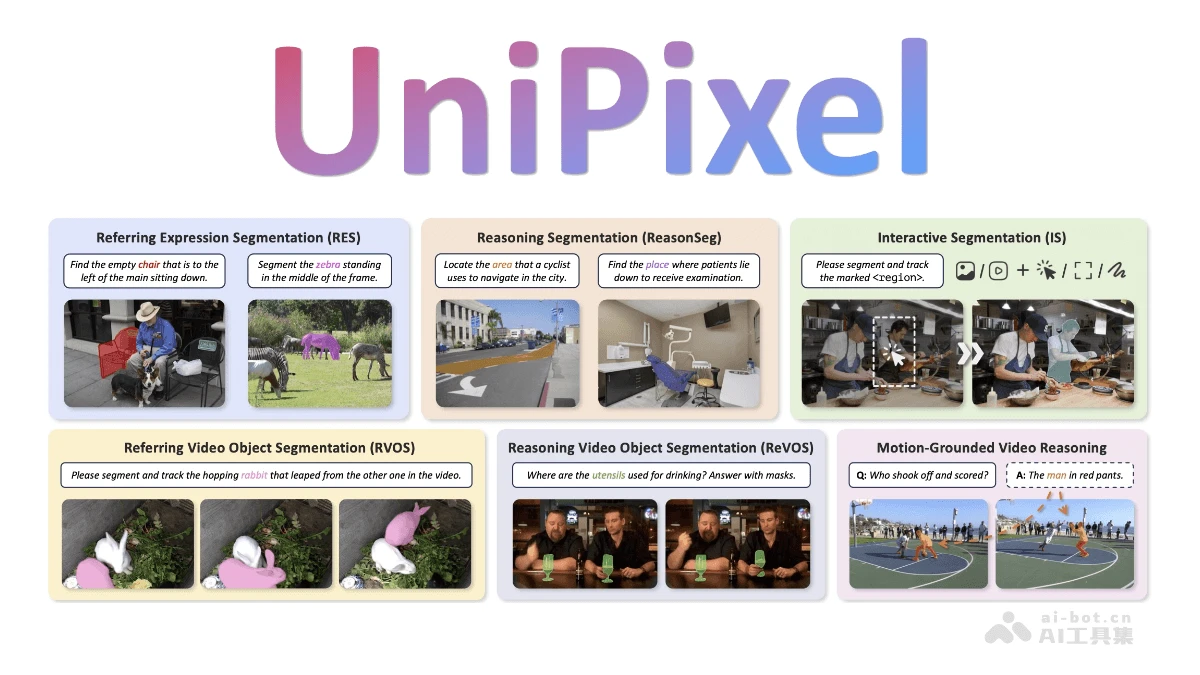
UniPixel – 香港理工聯合騰訊推出的像素級多模態大模型
UniPixel是什麼 UniPixel是香港理工大學和騰訊ARC Lab團隊開發的首個統一像素級多模態大模型,專注於圖像/視頻的精細理解與交互。能在單個模型中完成對象指代、像素級分割和區域推理三大任務,通過創新設計的”對象記憶機制”和統一視覺編碼方式,實現了對視頻中目標的精準追蹤與語義理解。模型基於Qwen2.5-VL框架,支持點、框、掩碼三種交互方式,在9項視覺任務基準測試中超越72B參數的傳統模型,開源了代碼和在線Demo。核心突破在於將視覺分割與語言推理深度融合,解決了傳統模型無法處理複雜指代和動態區域理解的問題。 UniPixel的主要功能 像素級視覺語言理解:專注於像素級視覺語言理解,能實現視覺信號與語言語義之間的像素級對齊,支持多種細粒度任務,包括圖像/視頻分割、區域理解以及PixelQA任務。 統一對象指代與分割:模型將對象指代和分割能力無縫集成,能根據視覺提示輸入生成相關的掩碼,並在推理過程中基於這些中間指針進行後續推理,實現細粒度的像素級推理。 多任務支持:在多個基準測試中表現出色,包括ReVOS推理分割基準、MeViS、Ref-YouTube-VOS、RefCOCO/+/g等數據集,設計了新的PixelQA任務,要求模型聯合進行對象指代、分割和問答。 靈活的視覺提示處理:能靈活處理視覺提示輸入,生成掩碼並進行推理,支持單幀和多幀的視頻區域理解,以及基於掩碼的問答任務。 UniPixel的技術原理 統一框架設計:UniPixel採用統一框架,將對象指代和分割能力整合到一個模型中,實現從粗粒度場景理解到細粒度像素推理的跨越,爲複雜視覺推理提供基礎。 對象記憶庫:模型包含對象記憶庫,存儲從指代任務中提取的對象特徵,爲後續的分割和推理任務提供上下文信息,增強模型在像素級任務上的性能。 多階段訓練策略:採用預訓練、指代任務微調和分割任務微調的多階段訓練策略,逐步提升模型在像素級任務上的性能,適應不同任務需求。 端到端掩碼生成:模型能根據語言描述直接生成像素級掩碼,實現語言與視覺的深度融合,支持多種細粒度任務,如圖像/視頻分割和區域理解。 靈活的視覺提示處理:能靈活處理視覺提示輸入,生成掩碼並進行推理,支持單幀和多幀的視頻區域理解,以及基於掩碼的問答任務,適應不同場景需求。 強大的推理能力:在VideoRefer-Bench-Q問答任務中,UniPixel-7B模型取得了74.1%的準確率,超越了包括GPT-4o在內的多個強大基準模型,顯示出其在複雜視覺推理任務中的強大能力。 模型權重與數據集提供:提供了UniPixel-3B和UniPixel-7B兩個版本的模型權重,以及23個指代/分割/QA數據集的原始圖像/視頻和預處理註釋,爲研究和應用提供豐富資源。 訓練與評估支持:代碼庫支持在23個數據集和基準測試上進行訓練和評估,支持靈活的硬件設置、高效的訓練技術、自定義基礎LLM和對話模板,以及通過Tensorboard/Wandb監控訓練過程,方便用戶使用和優化。 UniPixel的項目地址 項目官網:https://polyu-chenlab.github.io/unipixel/ Github倉庫:https://github.com/PolyU-ChenLab/UniPixel HuggingFace數據:https://huggingface.co/datasets/PolyU-ChenLab/UniPixel-SFT-1M arXiv技術論文:https://arxiv.org/pdf/2509.18094 在線體驗Demo:https://huggingface.co/spaces/PolyU-ChenLab/UniPixel UniPixel的應用場景 圖像分割:UniPixel能根據語言描述生成圖像中特定對象的像素級掩碼,適用於需要精確圖像分割的場景,如醫學圖像分析、自動駕駛中的目標分割等。 視頻分割:在視頻處理領域,UniPixel可以對視頻中的對象進行實時分割,支持視頻編輯、視頻監控和增強現實等應用。 區域理解:通過理解語言描述來識別和分割視頻中的特定區域,可用於視頻內容分析、智能監控系統和視頻會議中的背景分割等。 問答任務:UniPixel支持PixelQA任務,能夠根據語言描述和視覺信息回答問題,適用於教育、智能客服和信息檢索等場景。 多模態交互:在需要結合視覺和語言信息進行交互的場景中,如智能助手、虛擬現實和遊戲開發等,UniPixel能夠提供更自然和準確的交互體驗。 智能監控:在安防監控領域,UniPixel可以實時識別和分割監控視頻中的特定對象或區域,提高監控系統的智能化水平。
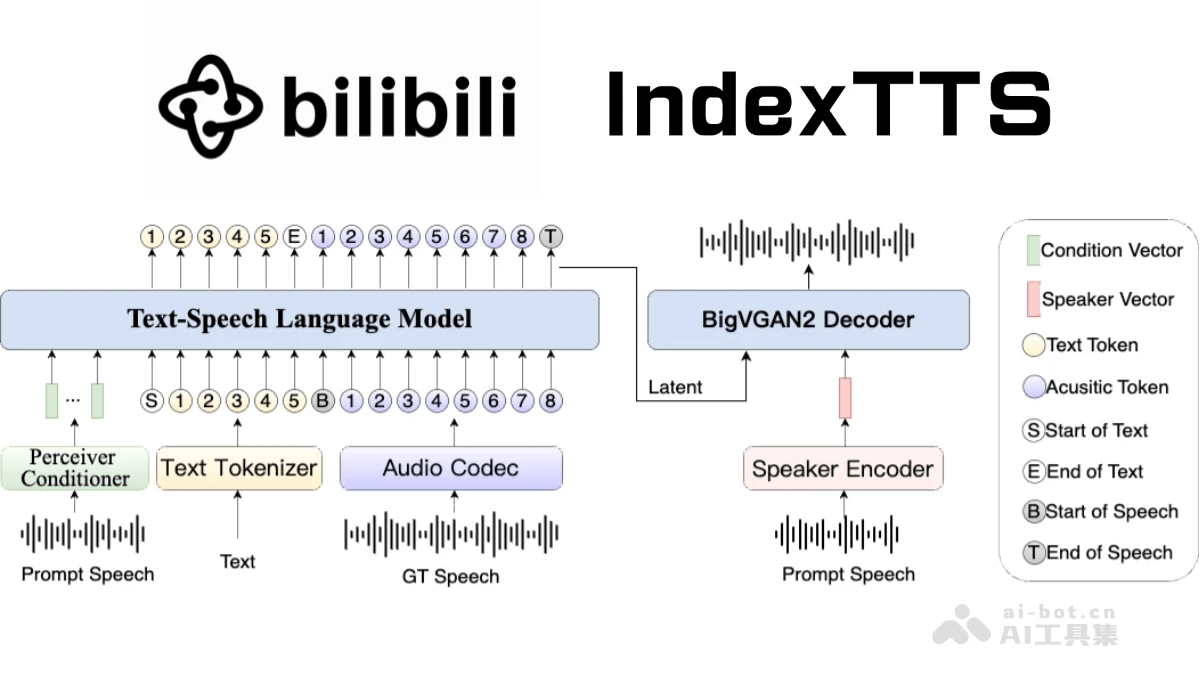
IndexTTS – B 站推出的文本轉語音模型,支持拼音糾正漢字發音
IndexTTS是什麼 IndexTTS 是 B 站推出的工業級可控文本轉語音(TTS)系統。基於 XTTS 和 Tortoise 模型開發,結合了 GPT 風格的生成技術,能將文本高效轉化爲自然流暢的語音。IndexTTS 的優勢是對中文文本的處理能力,支持拼音糾正漢字發音,可通過標點符號精準控制停頓,有效解決了多音字和長尾字符的發音問題。 採用混合建模方法,結合漢字和拼音,優化語音生成效果。在性能方面,IndexTTS 的字詞錯誤率(WER)僅爲 1.3%,揚聲器相似性(SS)達到 0.776,主觀音質評分(MOS)爲 4.01,表現出色。使用大量數據進行訓練,包括 2.5 萬小時的中文音頻和 9000 小時的英文音頻,確保了音質和音色的高質量。 最新自研的IndexTTS2 全新一代語音合成模型,能實現精準的時長控制和情感再現,支持音色與情緒獨立調整,能在多種語言和風格下生成自然流暢的語音,廣泛應用視頻配音、語言學習等領域,模型在情感表達和文本準確性上均達到行業領先水平。 IndexTTS的主要功能 拼音糾正與停頓控制:IndexTTS 在處理中文文本時,能通過拼音糾正漢字的發音,用標點符號在任意位置精準控制停頓,語音輸出更加自然流暢。 音質優化:引入了基於 Conformer 的條件編碼器和 BigVGAN2 語音解碼器,顯著提高了音質和音色相似性,MOS 評分達到 4.01。 多語言支持:目前支持中文和英文,計劃在未來擴展到更多語言。 IndexTTS的技術原理 混合建模方法:在中文場景下,IndexTTS 採用字符與拼音混合建模的方式。通過結合漢字和拼音,系統能快速糾正多音字和長尾字符的發音錯誤,提高語音合成的準確性和可控性。 語音編碼與解碼優化:IndexTTS 引入了基於 Conformer 的條件編碼器和 BigVGAN2 語音解碼器。Conformer 編碼器能夠更好地捕捉語音的音色特徵,BigVGAN2 解碼器則提升了音質和音色相似性。 零樣本語音克隆:IndexTTS 在零樣本語音克隆方面表現出色,能在沒有目標語音樣本的情況下生成高質量的語音。揚聲器相似性(SS)高達 0.776,MOS 評分達到 4.01,遠超現有系統。 高效的訓練與推理:系統經過數萬小時的數據訓練,訓練過程簡單且穩定,推理速度快。與 XTTS、CosyVoice2、Fish-Speech 和 F5-TTS 等系統相比,IndexTTS 在自然度、內容一致性和零樣本語音克隆方面表現出色。 IndexTTS的項目地址 IndexTTS: Github倉庫:https://github.com/index-tts/index-tts arXiv技術論文:https://arxiv.org/pdf/2502.05512 IndexTTS2: 項目官網:https://index-tts.github.io/index-tts2.github.io/ HuggingFace模型庫:https://huggingface.co/IndexTeam/IndexTTS-2 arXiv技術論文:https://arxiv.org/pdf/2506.21619 IndexTTS的應用場景 內容創作與視頻配音:IndexTTS 可以快速生成自然流暢的語音內容,幫助視頻創作者節省錄製時間,快速完成視頻配音。 有聲讀物與在線教育:支持中文和英文的高質量語音合成,能爲有聲讀物和在線教育平台提供自然的語音朗讀服務,提升用戶體驗。 智能客服與語音助手:IndexTTS 的零樣本語音克隆能力和高自然度表現適合用於智能客服和語音助手場景,能快速適應不同的語音風格和語速。 多媒體與娛樂:在多媒體和娛樂領域,IndexTTS 可以用於生成個性化語音內容,例如遊戲配音、虛擬角色對話等,爲用戶提供更具沉浸感的體驗。 無障礙輔助技術:高效的語音合成能力和低錯誤率,IndexTTS 可以爲視障人士提供語音輔助功能,幫助他們更好地獲取信息。
DeepCode – 港大實驗室推出的多Agent代碼生成平台
DeepCode是什麼 DeepCode 是香港大學數據智能實驗室推出的基於多智能體系統的代碼生成平台。DeepCode 能將研究論文、自然語言描述等轉化爲高質量的生產就緒代碼,支持多種編程語言和框架。平台具備 Paper2Code、Text2Web 和 Text2Backend 等功能,支持從算法實現到前後端開發的自動化。基於智能協調和高效記憶機制,DeepCode 提高了代碼生成的效率和質量,爲開發者提供強大的工具,加速從概唸到代碼的轉化過程。 DeepCode的主要功能 Paper2Code:將複雜算法從研究論文轉化爲高質量的生產就緒代碼。 Text2Web:將文本描述轉化爲功能齊全、視覺上吸引人的前端網頁代碼。 Text2Backend:從簡單文本輸入生成高效、支持擴展且功能豐富的後端代碼。 多接口支持:提供 CLI 和 Web 界面,滿足不同用戶需求。 自動化測試與文檔生成:自動生成單元測試和文檔,確保代碼質量。 智能檢索與推薦:基於 CodeRAG 系統提供全局代碼理解和推薦。 DeepCode的技術原理 多智能體架構: 中央協調智能體:負責整體工作流的執行和決策。 意圖理解智能體:解析用戶需求,提取功能規範和技術約束。 文檔解析智能體:處理技術文檔和研究論文,提取算法和方法。 代碼規劃智能體:進行架構設計和技術棧優化。 代碼引用挖掘智能體:發現相關代碼庫和框架,分析兼容性和集成潛力。 代碼索引智能體:構建代碼庫的知識圖譜,實現智能檢索和交叉引用。 代碼生成智能體:合成可執行代碼實現,生成測試套件和文檔。 智能協調與動態任務規劃:動態選擇最優處理策略,根據輸入複雜性調整工作流。平台支持實時任務分配和並行處理,提高效率。 高效記憶機制:基於智能壓縮和分層記憶結構,管理大規模代碼上下文,支持即時檢索,保持上下文一致性,確保代碼生成的準確性和連貫性。 高級 CodeRAG 系統:結合語義向量嵌入和基於圖的依賴分析,自動發現最優代碼庫和實現模式,提供全局代碼理解和推薦,提高代碼生成效率和質量。 自動化測試與文檔生成:自動生成單元測試和文檔,通過靜態分析和動態測試檢測潛在問題,降低代碼理解和維護難度。 DeepCode的項目地址 GitHub倉庫:https://github.com/HKUDS/DeepCode DeepCode的應用場景 學術研究:將研究論文中的算法轉化爲代碼,加速學術成果的驗證和應用。 軟件開發:快速生成前端和後端代碼,提高開發效率,減少重複工作。 企業級應用:生成可運行的原型代碼,加速產品迭代和市場驗證,降低開發成本。 教育與培訓:爲學生提供代碼生成工具,輔助教學,幫助理解編程概念。 數據分析與機器學習:自動生成數據處理和機器學習模型代碼,提高開發效率。
Deep Video Discovery – 微軟推出的深度視頻探索智能體
Deep Video Discovery是什麼 Deep Video Discovery(DVD)是微軟推出的深度視頻探索智能體,專爲理解和分析長視頻設計。Deep Video Discovery將長視頻分割成多個較短的片段,基於大型語言模型(LLM)的高級推理能力,自主地規劃和選擇合適的工具及參數來收集信息。Deep Video Discovery配備一套搜索中心的工具,包括全局瀏覽、片段搜索和幀檢查,能在不同層次上收集信息,基於迭代推理逐步構建對視頻內容的理解。在多個長視頻理解基準測試中,Deep Video Discovery均取得最先進的性能,顯著提高長視頻理解的準確性和效率。 Deep Video Discovery的主要功能 多粒度視頻理解:從全局、片段和幀三個層次理解和分析視頻內容,提供全面的視頻理解能力。 自主搜索與推理:自主地規劃和執行搜索策略,根據用戶查詢動態選擇合適的工具和參數,逐步收集信息並構建對視頻內容的理解。 高效信息檢索:基於全局瀏覽、片段搜索和幀檢查等工具,快速定位和提取與用戶查詢相關的視頻片段和細節。 長視頻理解:擅長處理長達數小時的信息密集型視頻,能有效解決長視頻理解中的時間和空間複雜性問題。 靈活的工具使用:根據不同的任務需求,靈活組合和使用多種工具,實現高效的視頻內容分析和問題回答。 Deep Video Discovery的技術原理 多粒度視頻數據庫構建:將長視頻均勻分割成多個較短的片段(clips),每個片段大約5秒。從全局、片段和幀三個層次提取視頻信息。全局層提供視頻的主體和事件總結,片段層提供文本描述(caption),幀層保留原始像素信息。構建一個包含解碼幀、文本描述和對應嵌入向量的結構化數據庫,支持快速檢索和詳細分析。 自主搜索與答案生成: 全局瀏覽(Global Browse):提供視頻的全局總結,幫助代理快速解視頻的主體和主要事件。 片段搜索(Clip Search):基於文本嵌入匹配,快速檢索與用戶查詢相關的視頻片段。 幀檢查(Frame Inspect):在特定時間範圍內進行細粒度的視覺問答(VQA),提取幀級別的詳細信息。 自主代理設計:Agent基於迭代的觀察-推理-行動循環,用LLM的推理能力,動態選擇和使用工具,逐步收集信息並構建對視頻內容的理解。 迭代推理:Agent根據當前的觀察狀態和推理結果,選擇合適的工具和參數,逐步細化查詢,最終生成準確的答案。 LLM驅動的推理:LLM作爲核心,負責推理和規劃。LLM根據當前的對話歷史和觀察結果,選擇合適的工具和參數,動態調整推理策略。根據任務需求,靈活組合和使用不同的工具,構建多步驟的工具使用鏈,解決複雜的查詢任務。 Deep Video Discovery的項目地址 arXiv技術論文:https://arxiv.org/pdf/2505.18079 Deep Video Discovery的應用場景 教育領域:在線教育平台分析長視頻課程,學生快速定位到課程中特定知識點或章節。 體育賽事分析:體育賽事分析比賽視頻,快速提取關鍵事件。 視頻監控:安防監控系統中,實時分析監控視頻,快速識別異常行爲或事件。 影視製作:影視後期製作團隊分析拍攝素材,快速找到所需鏡頭。 企業會議記錄:企業分析會議視頻,快速提取會議要點和關鍵決策。
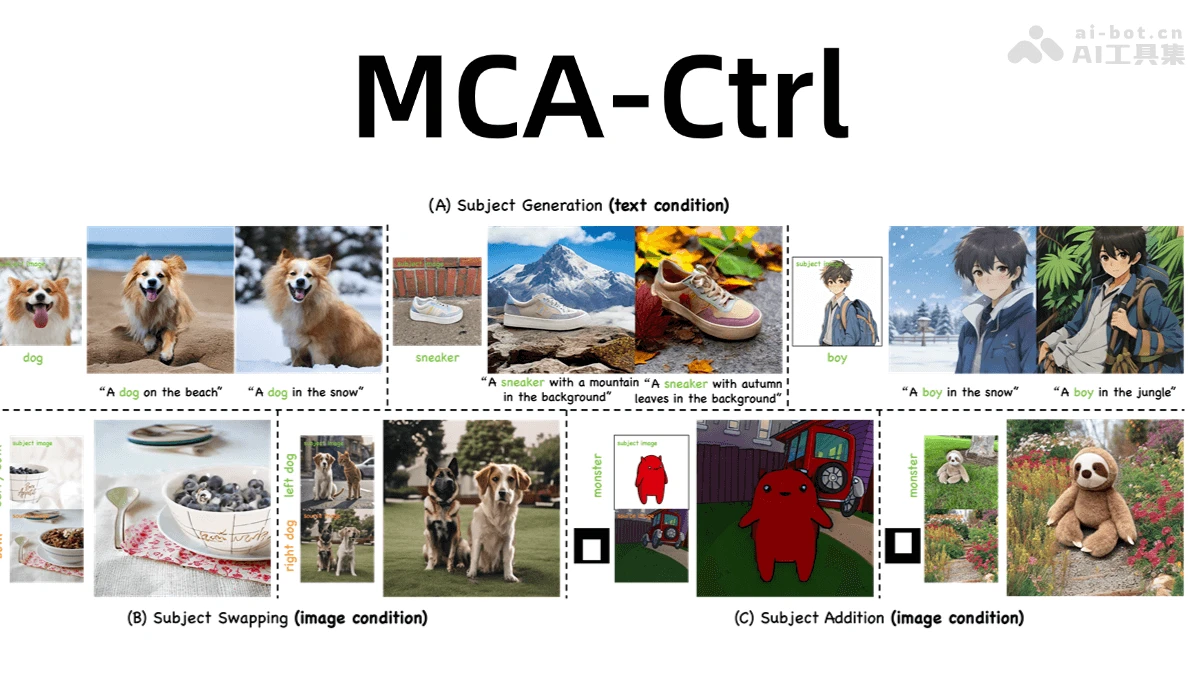
MCA-Ctrl – 中科院和中科大推出的圖像定製生成框架
MCA-Ctrl是什麼 MCA-Ctrl(Multi-party Collaborative Attention Control)是中科院計算所和中國科學院大學的推出的圖像定製生成框架,基於文本和複雜視覺條件實現高質量的圖像生成。MCA-Ctrl引入兩種注意力控制策略,Self-Attention Global Injection(SAGI)和Self-Attention Local Query(SALQ),及一個主體定位模塊(SLM),解決背景不一致、主體混淆等問題。MCA-Ctrl在零樣本圖像定製方面優於現有方法,能有效保持主體特徵和條件信息的一致性。 MCA-Ctrl的主要功能 高質量圖像定製:在文本或圖像條件下生成高質量的定製圖像,保持與條件輸入的語義一致性。 主體特徵保持:在複雜的視覺場景中,準確捕捉特定主體的外觀和內容,同時避免主體泄漏和混淆問題。 背景一致性:在圖像條件生成中,保持背景的一致性。 零樣本生成:支持直接在零樣本條件下生成高質量的圖像。 多種任務支持:支持多種圖像定製任務,包括主體生成、主體替換和主體添加等。 MCA-Ctrl的技術原理 多主體協同擴散過程:基於三個並行的擴散過程,主體擴散過程(Bsub)、條件擴散過程(Bcon)和目標擴散過程(Btgt)。主體擴散過程負責處理主體圖像,條件擴散過程處理條件圖像或文本,目標擴散過程生成最終的定製圖像。 自注意力層操作:Self-Attention Global Injection(SAGI)將主體和條件圖像的全局自注意力特徵注入到目標擴散過程中,增強目標圖像的細節真實性和內容一致性。SAGI操作有助於糾正由局部查詢引起的特徵混淆。目標擴散過程基於查詢主體和條件圖像的局部特徵,獲取主體的外觀和背景內容。SALQ操作確保生成的圖像在主體和背景上與條件圖像保持高度一致性。 主體定位模塊(SLM):爲在複雜視覺場景中準確識別和定位主體,引入主體定位模塊。SLM結合目標檢測模型(如DINO)和分割模型(如SAM),處理多模態指令,輸出精確的主體圖像層和可編輯圖像層,減少特徵混淆和僞影。 無調優框架:MCA-Ctrl不需要對每個主體進行單獨的微調訓練,基於注意力控制策略和主體定位模塊,在零樣本條件下實現高質量的圖像定製。 MCA-Ctrl的項目地址 GitHub倉庫:https://github.com/yanghan-yh/MCA-Ctrl arXiv技術論文:https://arxiv.org/pdf/2505.01428 MCA-Ctrl的應用場景 數字內容創作:快速生成遊戲、動畫中的角色和場景。 廣告與營銷:製作個性化廣告圖像和品牌推廣素材。 娛樂與社交媒體:生成個性化頭像、圖片和社交媒體內容。 教育與培訓:輔助教學材料製作,創建虛擬實驗室場景。 藝術與設計:提供藝術創作靈感,輔助室內設計預覽。
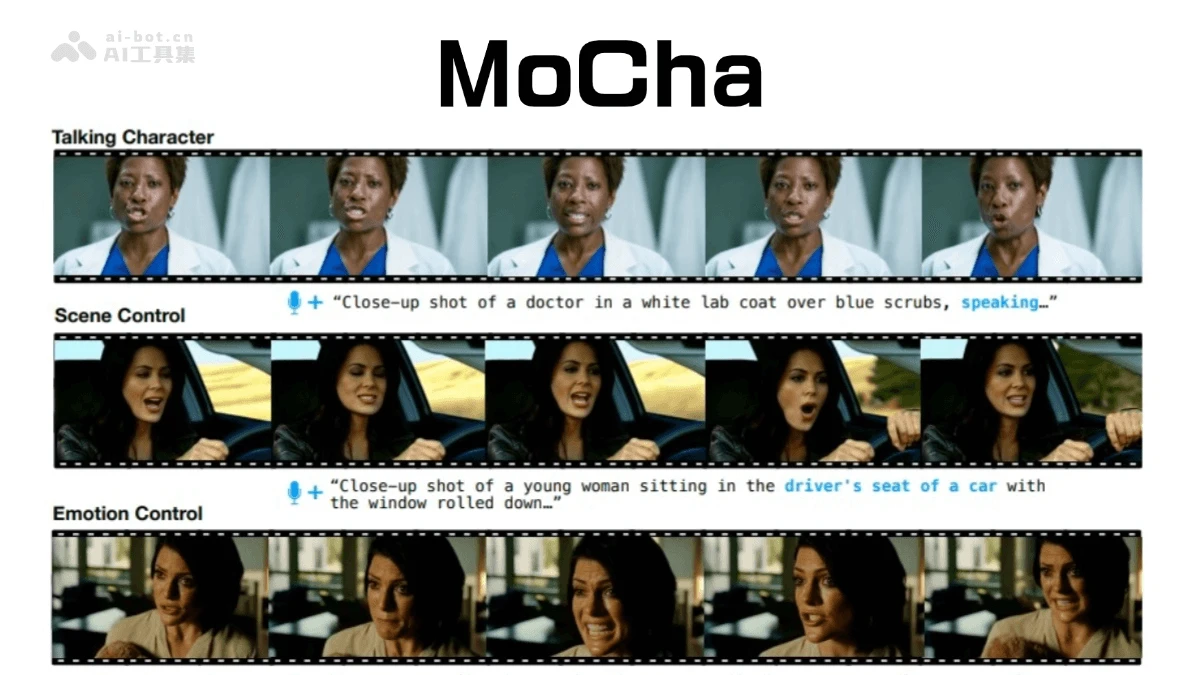
MoCha – Meta 聯合滑鐵盧大學推出的端到端對話角色視頻生成模型
MoCha是什麼 MoCha AI 是 Meta 和滑鐵盧大學聯合開發的端到端對話角色視頻生成模型。能根據文本或語音輸入生成帶有同步語音和自然動作的完整角色動畫。MoCha 採用語音-視頻窗口注意力機制,解決了視頻壓縮時音頻分辨率不匹配以及脣部動作錯位的問題。支持多角色輪換對話,能生成具有情感表達和全身動作的角色動畫。 MoCha的主要功能 語音驅動角色動畫生成:用戶輸入語音,MoCha 可以生成與語音內容同步的角色嘴型、面部表情、手勢及身體動作。 文本驅動角色動畫生成:用戶僅輸入文本腳本,MoCha 會先自動合成語音,再驅動角色進行完整的口型和動作表現。 全身動畫生成:與傳統僅生成面部表情或嘴型的模型不同,MoCha 能生成全身的自然運動,涵蓋嘴脣同步、手勢以及多角色之間的互動。 多角色輪番對話生成:MoCha 提供結構化提示模板與角色標籤,能自動識別對話輪次,實現角色間“你來我往”的自然對話呈現。在多角色場景中,用戶只需定義一次角色信息,可以通過簡單的標籤(如“人物1”“人物2”)在不同的場景中引用這些角色,無需重複描述。 MoCha的技術原理 擴散變壓器(DiT)架構:MoCha 基於擴散變壓器(Diffusion Transformer)架構,通過將文本和語音條件依次通過交叉注意力機制融入模型,有效捕捉語義和時間動態。能生成逼真且富有表現力的全身動作,同時確保角色動畫與輸入語音的精確同步。 語音-視頻窗口注意力機制:爲了解決視頻壓縮和並行生成帶來的語音-視頻對齊問題,MoCha 引入了語音-視頻窗口注意力機制。限制每個視頻標記只能關注與其時間上相鄰的音頻標記,提高口型同步的準確性和語音-視頻對齊效果。模擬了人類語音的運作方式,使角色的口型與對話內容精準匹配。 聯合訓練策略:MoCha 採用了聯合訓練策略,同時基於語音標註和文本標註的視頻數據進行訓練。增強了模型在多樣化角色動作上的泛化能力,通過自然語言提示實現對角色表情、動作、互動和環境的精細控制。 結構化提示模板:爲了簡化多角色對話的文本描述,MoCha 設計了結構化提示模板,通過爲每個角色分配唯一標籤在文本中使用這些標籤來描述角色的動作和互動。減少了冗餘,提高了模型在多角色場景中的生成效果。 多階段訓練框架:MoCha 採用了多階段訓練框架,根據鏡頭類型(如特寫鏡頭、中景鏡頭)對數據進行分類,逐步引入更復雜的任務。確保了模型在不同難度任務上的表現,同時提高了訓練效率。 MoCha的項目地址 項目官網:https://congwei1230.github.io/MoCha/ arXiv技術論文:https://arxiv.org/pdf/2503.23307 MoCha的應用場景 虛擬主播:MoCha 可以自動生成日常 Vlog、角色問答等內容。通過語音或文本輸入,生成與語音內容同步的角色嘴型、面部表情、手勢及身體動作,使虛擬主播更加生動自然。 動畫影視創作:MoCha 支持 AI 自動配音和自動動畫生成,能降低動畫影視創作的製作成本。能生成全身動畫,讓角色動作更加自然,接近電影級數字人演出。 教育內容創作:MoCha 可以作爲 AI 老師角色進行講課或互動。通過文本驅動的方式,生成與教學內容匹配的角色動畫,提高教育內容的趣味性和吸引力。 數字人客服:MoCha 可以用於擬人化企業客服、諮詢角色。通過語音或文本輸入,生成自然流暢的客服對話動畫,提升用戶體驗。
APB – 清華聯合騰訊等機構推出的分佈式長上下文推理框架
APB是什麼 APB(Accelerating Distributed Long-Context Inference by Passing Compressed Context Blocks across GPUs)是清華大學等機構聯合提出的分佈式長上下文推理框架。通過稀疏注意力機制和序列並行推理方式,有效解決了大模型處理長文本時的效率瓶頸。APB採用更小的Anchor block和Passing block,結合查詢感知的上下文壓縮技術,減少計算開銷的同時,精準傳遞關鍵信息,實現長距離語義依賴的高效處理。在128K文本上,APB推理速度比Flash Attention快約10倍,比英偉達的Star Attention快1.6倍,且性能優異。具備卓越的兼容性,能適應不同分佈式設定和模型大小。 APB的主要功能 加速長上下文推理:APB通過多主機近似注意力機制顯著提升推理速度,相比Flash Attention、Ring Attention和Star Attention分別實現了高達9.2倍、4.2倍和1.6倍的速度提升。通過序列並行化和近似注意力機制的結合,APB在保持任務性能的同時,大幅減少了計算量和通信開銷。 高效的分佈式計算: 上下文分割:輸入序列被均勻分配到多個主機上,在每個主機的本地上下文塊前附加一個錨點塊(Anchor Block),保留對輸入序列初始部分的可見性。 塊壓縮:在每個主機上,使用Locret的保留頭(Retaining Heads)對KV緩存進行壓縮,減少通信和計算開銷。 通信機制:通過AllGather通信機制,將壓縮後的上下文塊發送到所有主機,並構建傳遞塊(Passing Block),以傳遞前序主機的重要KV緩存單元。 計算:在每個主機上,結合錨點塊、傳遞塊和本地上下文塊進行注意力計算。傳遞塊在注意力計算後被丟棄,不參與後續計算。 適應性強:APB支持多種模型和並行配置,能適應不同的分佈式設置和模型大小,具有良好的可擴展性,通過調整錨點塊和傳遞塊的大小,APB可以在不同長度的輸入序列上實現最佳性能。 保持任務性能:在長上下文推理任務中,APB速度更快,在性能上與全注意力計算(Full Attention)相當,在某些任務上表現更好。通過查詢感知的上下文壓縮技術,APB能更精準地識別和傳遞與查詢相關的上下文信息,保持或提升任務性能。 APB的技術原理 稀疏注意力機制:APB框架整合了稀疏注意力機制,通過減少計算量來提升推理速度。通過以下方式實現稀疏注意力: 更小的Anchor block:與Star Attention相比,APB將Anchor block的大小縮小到上下文塊的1/4或1/8,從而減少了額外的計算開銷。 Passing block:爲了解決長距離語義依賴問題,APB通過構建Passing block來傳遞重要信息。Passing block由前面設備上的重要KV對組成,每個上下文塊被壓縮後通信到後續GPU上構建Passing block。 查詢感知的上下文壓縮:APB在Anchor block的開頭嵌入查詢,使上下文壓縮器能夠看到查詢的內容,更精準地識別出查詢相關的KV對,通過通信機制傳給後續設備。 序列並行推理:APB框架採用序列並行的方式,將長文本均勻分配到多個GPU上進行並行處理,同時通過局部KV緩存壓縮和精簡的跨GPU通信機制,解決了長上下文中的遠距離語義依賴問題。 APB的項目地址 Github倉庫:https://github.com/thunlp/APB arXiv技術論文:https://arxiv.org/pdf/2502.12085 APB的應用場景 長文本推理:如長文本生成、長文本問答等,需要處理極長輸入序列的應用。 多Agent協作:多個Agent需要協同處理長上下文信息的場景。 大規模模型服務:需要在分佈式環境中高效處理長上下文的模型服務。 知識圖譜構建:知識圖譜構建任務需要處理大量的文本數據,提取和整合知識。APB框架通過高效的上下文壓縮和傳遞機制,能顯著提升知識圖譜構建的效率。 實時交互系統:實時交互系統需要快速處理用戶的輸入生成準確的回覆。APB框架通過高效的上下文壓縮和傳遞機制,能顯著提升實時交互系統的效率。
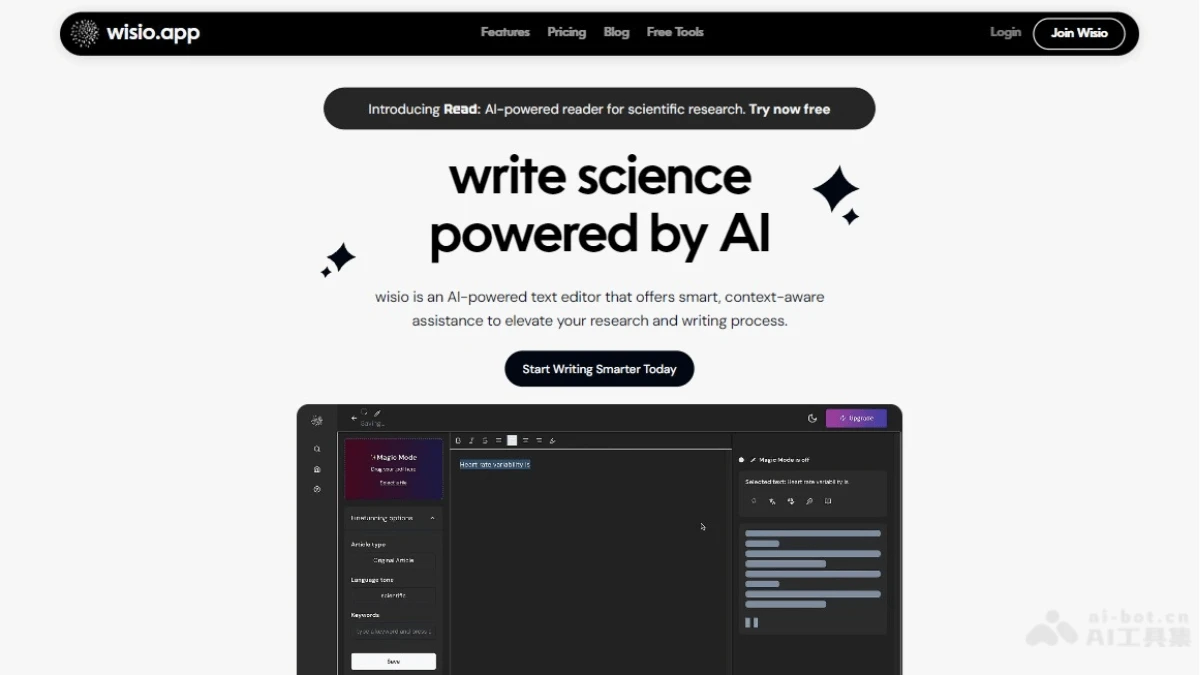
wisio.app – AI科研寫作助手,支持分析理解複雜學術論文
wisio.app是什麼 wisio.app ...
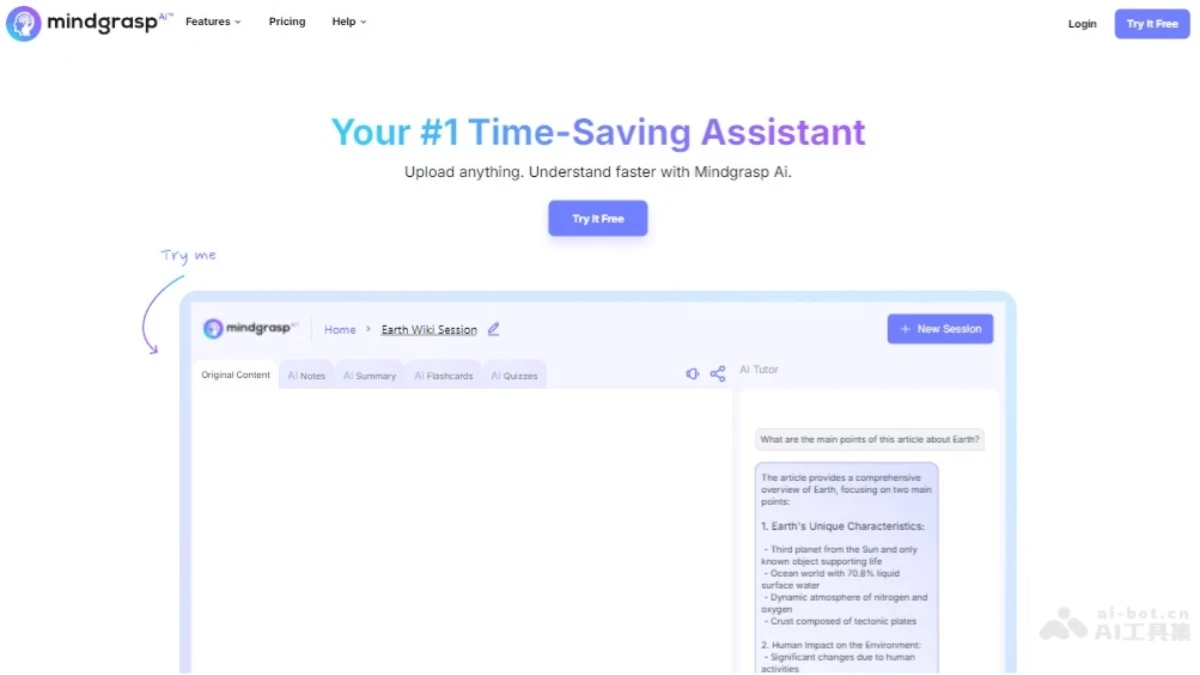
mindgrasp – AI學習和辦公助手,智能生成筆記摘要
mindgrasp是什麼 mindgrasp是一個AI驅動的學習工具,能快速從文檔、PDF、視頻、音頻等多種格式的文件中提取關鍵信息,並生成詳細的筆記、摘要、抽認卡和測驗。基於先進的人工智能技術,幫助用戶提高學習效率,加深對材料的理解。用戶可以上傳文件,提出問題,mindgrasp會即時提供答案和相關信息,是學生和專業人士提升學習和工作效率的得力助手。 mindgrasp的主要功能 智能筆記:自動從上傳的文檔、視頻、音頻等材料中提取關鍵信息,生成結構化的筆記。 問答系統:用戶可以就上傳的內容提出問題,mindgrasp利用AI技術提供準確的答案。 內容摘要:將長文檔或視頻內容進行壓縮,提供簡短的摘要,幫助用戶快速把握核心要點。 抽認卡:自動識別學習材料中的關鍵點,並生成抽認卡,幫助用戶通過間隔重複的方式加強記憶。 文件上傳:支持多種文件格式的上傳,包括PDF、MP3、MP4、PPT等。 網絡搜索:結合互聯網資源,爲用戶的問題提供更全面的答案。 mindgrasp的產品官網 產品官網:mindgrasp.ai mindgrasp的應用場景 學術研究:學生和研究人員可以用mindgrasp從大量文獻中提取關鍵信息,生成筆記和摘要,支持論文寫作和學術研究。 在線學習:在線課程學習者可以用來整理網絡課程內容,創建抽認卡,提高學習效率。 企業培訓:企業可以用mindgrasp來整理培訓材料,生成員工培訓手冊,提高培訓效率。 會議記錄:會議結束後,可以上傳會議錄音,mindgrasp會幫助生成會議紀要和行動項。 語言學習:語言學習者可以用它來分析語言材料,生成語言練習和抽認卡。 法律研究:法律專業人士可以用mindgrasp來分析案件文件,提取關鍵證據和法律條款。
Consensus – AI學術研究搜索引擎,超2億篇同行評審研究論文
Consensus是什麼 Consensus ...
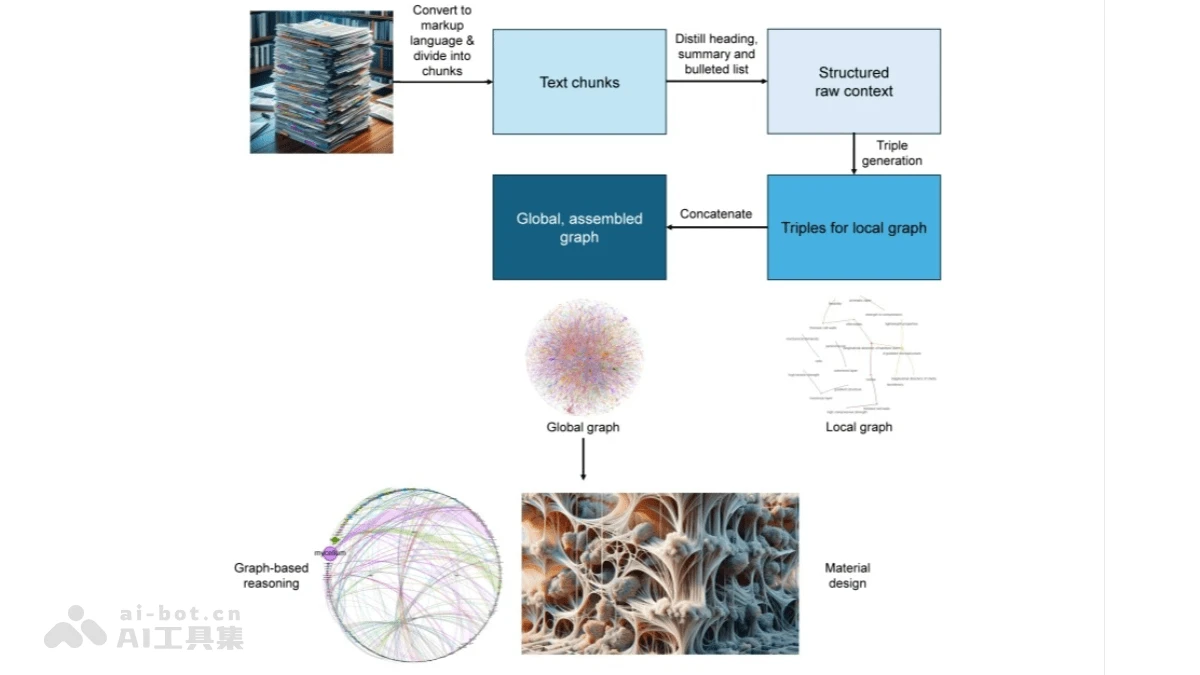
GraphReasoning – 將科學論文轉換成知識圖譜的AI應用框架
GraphReasoning是什麼 GraphR...