最好用的AI工具
搜尋:語音合成
20 個結果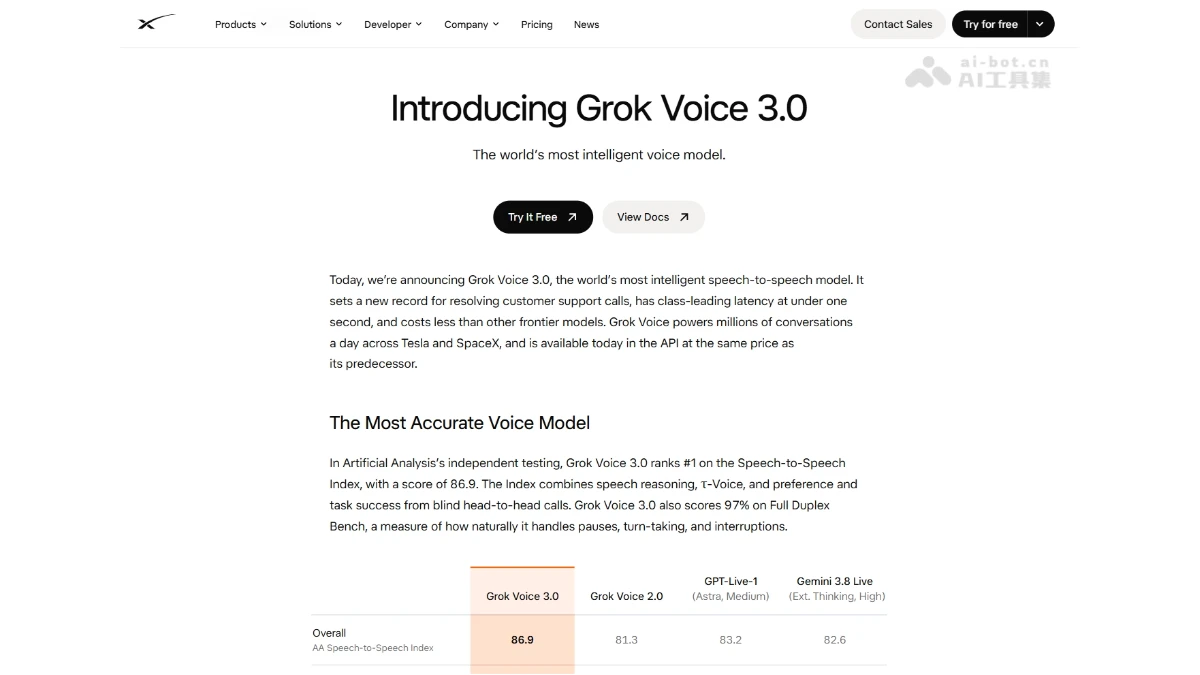
Grok Voice 3.0 – SpaceXSI 推出的端到端語音轉語音模型
Grok Voice 3.0是什麼 Grok Voice 3.0 是 SpaceXSI 推出的端到端語音轉語音模型,在獨立測試機構 Artificial Analysis 的語音綜合榜單以 86.9 分居首,響應延遲低於 1 秒,單次任務運行成本約 0.025 美元,低於同級別競品。目前每天支撐特斯拉車內數百萬次對話,星鏈客服中心依託模型日處理 2 萬通多語言來電,約七成無需人工介入可解決。 Grok Voice 3.0的主要功能 端到端語音對話:支持語音輸入直接生成語音輸出,無需文字中轉,實現自然流暢的實時人機對話。 全雙工交互:可智能處理停頓、對話輪替和插話,用戶隨時打斷,模型響應自然不僵硬。 複雜任務執行:依託 Connectors 和 Grok Bot,可完成查日程、回郵件、下單咖啡、預訂晚餐等免動手操作。 企業客服能力:單個智能體即可完成客戶身份覈驗、硬件故障排查、發放退款和補發設備全流程服務。 多語言支持:星鏈客服中心每天以多種語言承接約 2 萬通客戶來電。 Grok Voice 3.0的技術原理 端到端語音轉語音架構:傳統語音助手採用”語音識別→文本理解→文本生成→語音合成”的多模塊級聯方案,信息逐級損耗且延遲疊加。Grok Voice 3.0 採用語音到語音的直接建模,音頻信號進入模型後不經文本中間表示,直接輸出語音回覆,減少級聯誤差,是其首響延遲壓至 1 秒以內的結構基礎。 全雙工對話建模:模型能同時處理收聽與生成:通過流式編碼器持續捕捉用戶音頻流,結合對停頓、語氣詞和插話行爲的判別,動態決定何時續說、何時讓步,在 Full Duplex Bench 上取得 97% 的成績,是其車載免喚醒、可打斷交互體驗的核心支撐。 語音推理與智能體能力融合:模型將聽覺理解與大語言模型的推理規劃能力耦合,用戶語音被解析爲任務意圖後,由內置的智能體框架調用日程、郵件、下單等外部工具 Connectors 或 Grok Bot 完成任務,把執行結果用自然語音回饋用戶,形成”聽懂—規劃—執行—回覆”的閉環,是其客服場景能獨立完成退款、補發等操作的原因。 如何使用Grok Voice 3.0 普通用戶:在 Grok 應用、Grok Bot 或特斯拉車內直接開啓語音模式可對話,grok-voice-latest 用戶已自動升級無需操作。 開發者:註冊 API Console 獲取密鑰後,按官方文檔調用 Voice Agent API 接入應用。 Grok Voice 3.0的核心優勢 綜合智能第一:以 86.9 分登頂 Artificial Analysis 語音轉語音綜合榜,在語音推理、任務完成率和人類偏好上全面領先競品。 延遲行業領先:響應延遲低於 1 秒,比同級別 GPT-Live-1 低 40%,實現智能與速度的最優平衡。 運行成本更低:單次任務成本約 0.025 美元,低於 GPT-Live-1 和 GPT-Realtime-2.1,且 API 定價與上代持平不漲。 全雙工交互自然:Full Duplex Bench 拿下 97%,對停頓、輪替和插話的處理接近真人對話體驗。 企業場景驗證充分:EVA-Bench 以 74% 精度居首,星鏈實測日接 2 萬通電話、70% 無需人工、四分之一銷售通話直接成交。 Grok Voice 3.0的項目地址 項目官網:https://x.ai/news/grok-voice-3 Grok Voice 3.0的同類競品對比 對比維度 Grok Voice 3.0 Gemini 3.8 Live AA 語音綜合指數 86.9(第 1 名) 82.6 語音推理(Big Bench Audio) 98.5% 97.7% 人類偏好(Arena Elo) 1070 990 任務完成率 94.8% 89.1% 全雙工(Full Duplex Bench) 97.0% 91.9% τ-Voice 客服場景 71.6% 68.6% 單次任務成本 $0.025 更高(未列具體值) EVA-Bench 企業客服精度 74%(最高) 未領先 Grok Voice 3.0的應用場景 智能車載語音助手(特斯拉):駕駛員全程免動手,通過 Connectors 查詢日程、回覆郵件,或用 Grok Bot 完成下單咖啡、預訂晚餐等複雜任務,目前每天處理數百萬次車內對話。 企業客服中心(星鏈):星鏈客服依託 Grok Voice 每天多語言接聽約 2 萬通來電,約 70% 無需人工介入即可解決,單個智能體可獨立完成身份覈驗、故障排查、退款和設備補發。 電話銷售轉化:約四分之一的銷售通話在客戶掛斷前即促成下
Breeze TTS 2 – BreezeBlue 推出的新一代語音合成模型
Breeze TTS 2是什麼 Breeze T...
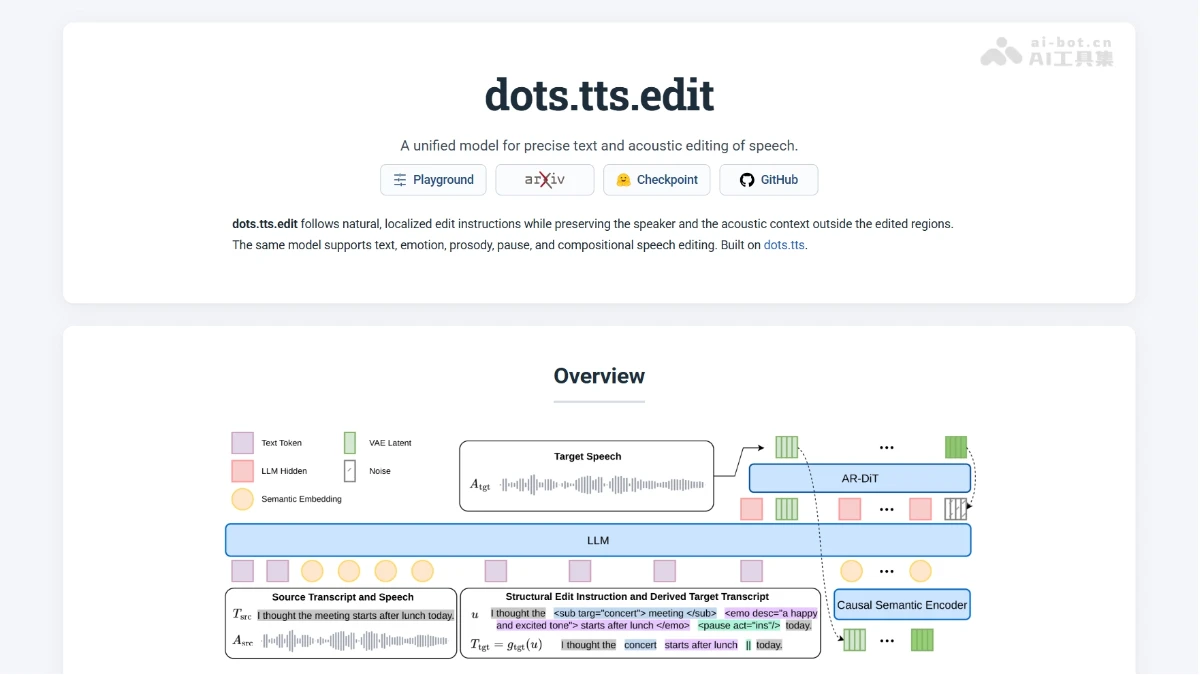
dots.tts – 小紅書聯合上海交大開源的語音合成基座模型
dots.tts是什麼 dots.tts 是...
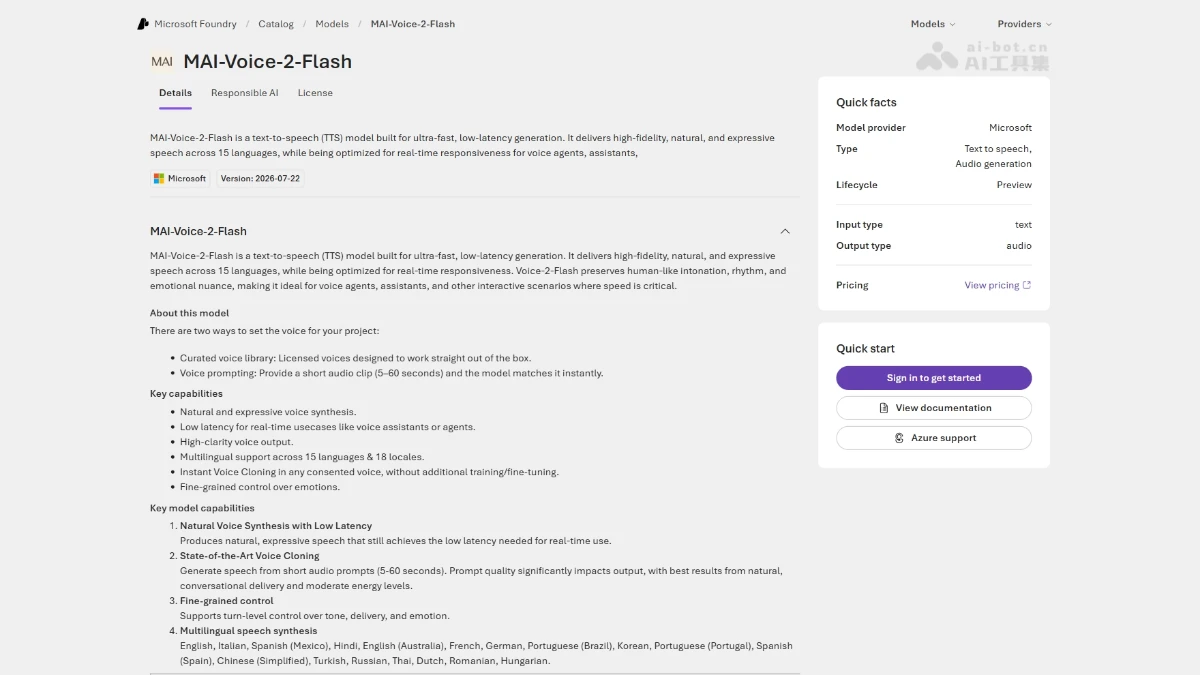
MAI-Voice-2-Flash – 微軟推出的高速語音合成模型
MAI-Voice-2-Flash是什麼 MAI...
Qwen-Audio-3.0-TTS – 阿里通義千問推出的語音合成模型
Qwen-Audio-3.0-TTS是什麼 Qw...
Confucius4-TTS – 網易有道開源的多語言語音合成引擎
Confucius4-TTS是什麼 Confuc...
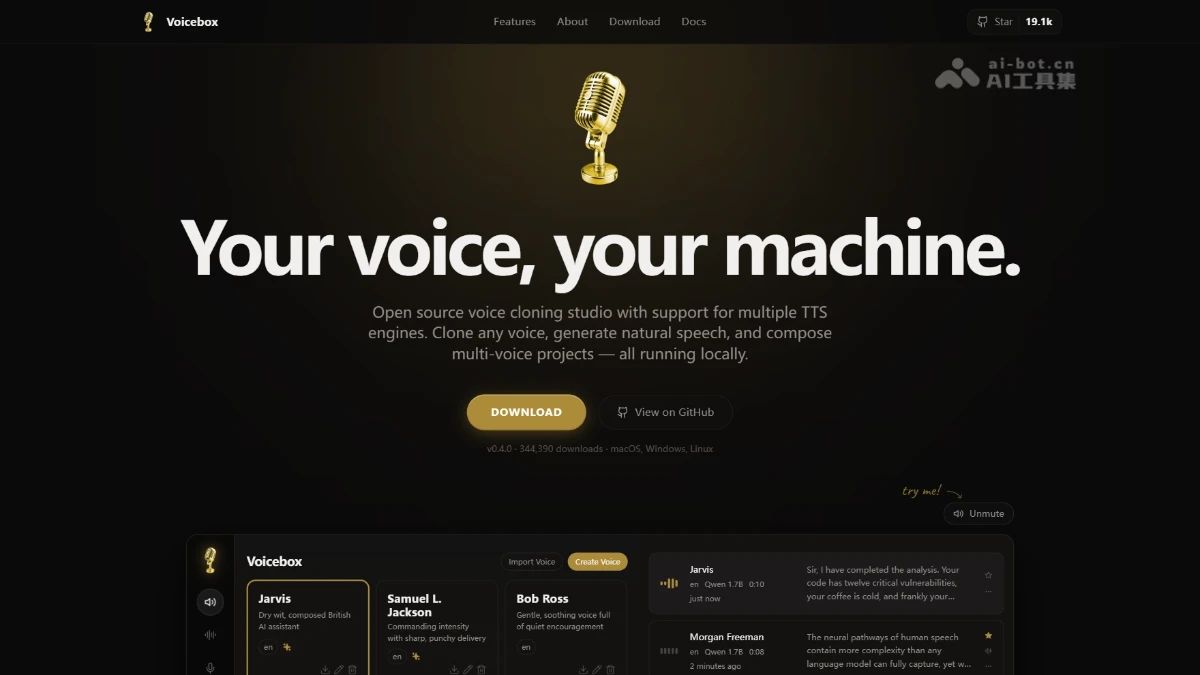
Voicebox – 開源本地語音合成工具,ElevenLabs 開源平替
Voicebox是什麼 Voicebox 是...
VoxCPM2 – OpenBMB開源的語音合成模型
VoxCPM2是什麼 VoxCPM2是Open...
Xiaomi MiMo-V2-TTS – 小米推出的語音合成大模型
Xiaomi MiMo-V2-TTS是什麼 Xi...

Ming-omni-tts – 螞蟻集團開源的統一音頻生成模型
Ming-omni-tts是什麼 Ming-omni-tts 是螞蟻集團開源的統一音頻生成模型,採用自迴歸架構實現語音、音樂和音效的聯合生成。模型支持通過自然語言指令對語速、音調、音量、情感和方言進行細粒度控制,粵語方言控制準確率達93%,情感控制準確率46.7%,超越CosyVoice3。技術上採用統一連續音頻Tokenizer和Diffusion Transformer架構,以12.5Hz幀率處理多模態音頻,通過”Patch-by-Patch”壓縮策略將LLM推理幀率降至3.1Hz,在降低延遲的同時保持音質。16.8B參數版本在Seed-tts-eval中文測試集上WER僅0.83%,超越SeedTTS和GLM-TTS。模型內置100+優質音色,支持零樣本聲音設計,提供Docker鏡像和Gradio演示,適用於有聲書、播客、多語言內容創作等場景。 Ming-omni-tts的主要功能 統一多模態音頻生成:業界首個自迴歸模型,可在單通道中聯合生成語音、環境音和音樂,實現”身臨其境”的聽覺體驗。 細粒度語音控制:支持通過簡單指令精確控制語速、音調、音量、情感和方言,粵語方言控制準確率高達93%,情感控制準確率達46.7%。 智能聲音設計:內置100+優質音色,支持通過自然語言描述進行零樣本聲音設計。 高效推理優化:採用”Patch-by-Patch”壓縮策略,將LLM推理幀率降至3.1Hz,顯著降低延遲。 專業文本歸一化:準確解析和朗讀複雜數學表達式、化學方程式等專業格式,內部測試集CER僅1.97%。 多語言支持:支持中文、英文等多種語言的語音合成與跨語言遷移。 零樣本TTS:僅需3-10秒參考音頻即可克隆任意音色,在Seed-tts-eval上WER低至0.83%。 Ming-omni-tts的技術原理 統一連續音頻Tokenizer:基於VAE的連續Tokenizer,以12.5Hz幀率將語音、音樂和通用音頻整合到統一潛空間,支持多模態音頻的聯合建模。 Diffusion Transformer (DiT) Head:採用擴散頭架構增強音頻生成質量,提升音質細膩度和自然度。 Patch生成策略:採用patch大小爲4、回溯歷史爲32的生成策略,在局部聲學細節和長期結構連貫性之間取得平衡。 自迴歸生成架構:業界首個在單通道中聯合生成語音、音樂和音效的自迴歸模型,實現統一音頻生成。 “Patch-by-Patch”壓縮機制:通過壓縮策略將LLM推理幀率從原始頻率降至3.1Hz,大幅降低計算延遲和推理成本。 指令微調對齊:通過指令微調實現對語速、音調、音量、情感和方言的細粒度控制,支持自然語言指令解析。 Ming-omni-tts的項目地址 GitHub倉庫:https://github.com/inclusionAI/Ming-omni-tts Hugging Face模型庫: https://modelscope.cn/models/inclusionAI/Ming-omni-tts-16.8B-A3B https://huggingface.co/inclusionAI/Ming-omni-tts-0.5B Ming-omni-tts的應用場景 有聲書與播客製作:支持長文本語音合成,Podcast TTS任務CER僅1.84%,適合有聲讀物、新聞播報和播客內容生成。 多語言內容創作:支持中文、英文等多語言語音合成與跨語言音色遷移,滿足全球化內容生產需求。 遊戲音效設計:可聯合生成語音、環境音和音樂,爲遊戲場景提供沉浸式音頻體驗。 教育培訓領域:準確朗讀複雜數學表達式、化學方程式等專業內容,適用於在線教育課件和學術講解。 智能客服與助手:內置100+優質音色,支持零樣本聲音克隆,可快速定製品牌專屬語音助手。 廣告與營銷配音:通過情感控制和方言支持,生成富有感染力的廣告配音和本地化營銷內容。
Maya1 – Maya Research團隊開源的語音合成模型
Maya1是什麼 Maya1 是 Maya R...
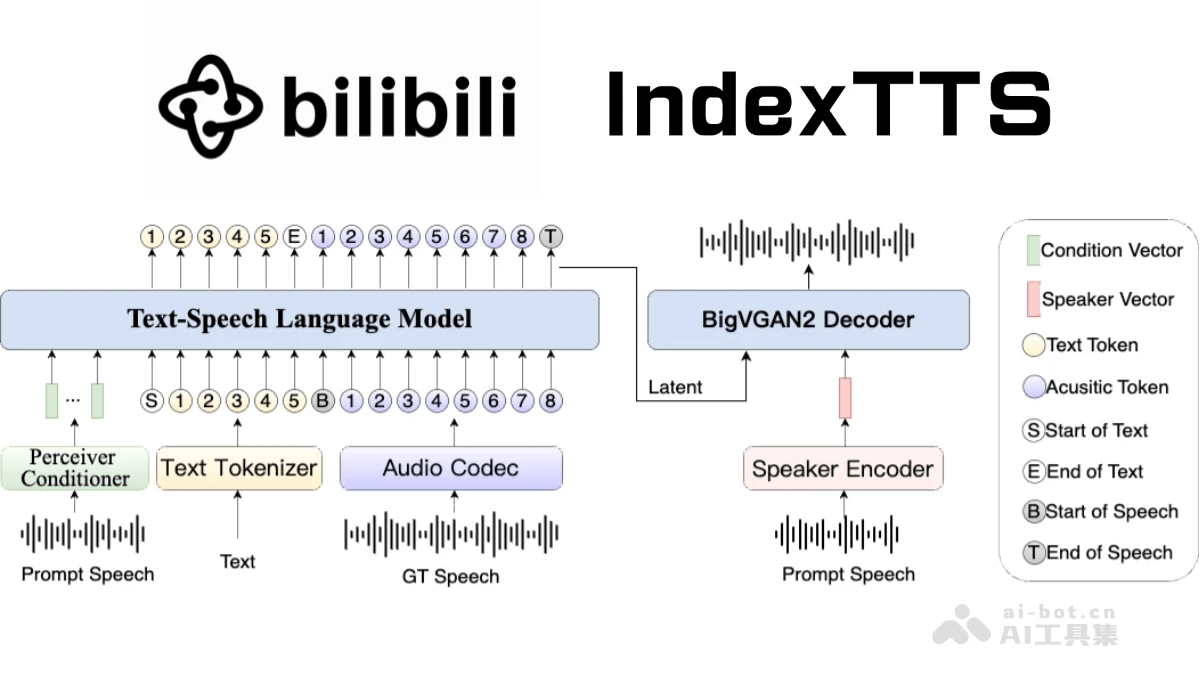
IndexTTS – B 站推出的文本轉語音模型,支持拼音糾正漢字發音
IndexTTS是什麼 IndexTTS 是 B 站推出的工業級可控文本轉語音(TTS)系統。基於 XTTS 和 Tortoise 模型開發,結合了 GPT 風格的生成技術,能將文本高效轉化爲自然流暢的語音。IndexTTS 的優勢是對中文文本的處理能力,支持拼音糾正漢字發音,可通過標點符號精準控制停頓,有效解決了多音字和長尾字符的發音問題。 採用混合建模方法,結合漢字和拼音,優化語音生成效果。在性能方面,IndexTTS 的字詞錯誤率(WER)僅爲 1.3%,揚聲器相似性(SS)達到 0.776,主觀音質評分(MOS)爲 4.01,表現出色。使用大量數據進行訓練,包括 2.5 萬小時的中文音頻和 9000 小時的英文音頻,確保了音質和音色的高質量。 最新自研的IndexTTS2 全新一代語音合成模型,能實現精準的時長控制和情感再現,支持音色與情緒獨立調整,能在多種語言和風格下生成自然流暢的語音,廣泛應用視頻配音、語言學習等領域,模型在情感表達和文本準確性上均達到行業領先水平。 IndexTTS的主要功能 拼音糾正與停頓控制:IndexTTS 在處理中文文本時,能通過拼音糾正漢字的發音,用標點符號在任意位置精準控制停頓,語音輸出更加自然流暢。 音質優化:引入了基於 Conformer 的條件編碼器和 BigVGAN2 語音解碼器,顯著提高了音質和音色相似性,MOS 評分達到 4.01。 多語言支持:目前支持中文和英文,計劃在未來擴展到更多語言。 IndexTTS的技術原理 混合建模方法:在中文場景下,IndexTTS 採用字符與拼音混合建模的方式。通過結合漢字和拼音,系統能快速糾正多音字和長尾字符的發音錯誤,提高語音合成的準確性和可控性。 語音編碼與解碼優化:IndexTTS 引入了基於 Conformer 的條件編碼器和 BigVGAN2 語音解碼器。Conformer 編碼器能夠更好地捕捉語音的音色特徵,BigVGAN2 解碼器則提升了音質和音色相似性。 零樣本語音克隆:IndexTTS 在零樣本語音克隆方面表現出色,能在沒有目標語音樣本的情況下生成高質量的語音。揚聲器相似性(SS)高達 0.776,MOS 評分達到 4.01,遠超現有系統。 高效的訓練與推理:系統經過數萬小時的數據訓練,訓練過程簡單且穩定,推理速度快。與 XTTS、CosyVoice2、Fish-Speech 和 F5-TTS 等系統相比,IndexTTS 在自然度、內容一致性和零樣本語音克隆方面表現出色。 IndexTTS的項目地址 IndexTTS: Github倉庫:https://github.com/index-tts/index-tts arXiv技術論文:https://arxiv.org/pdf/2502.05512 IndexTTS2: 項目官網:https://index-tts.github.io/index-tts2.github.io/ HuggingFace模型庫:https://huggingface.co/IndexTeam/IndexTTS-2 arXiv技術論文:https://arxiv.org/pdf/2506.21619 IndexTTS的應用場景 內容創作與視頻配音:IndexTTS 可以快速生成自然流暢的語音內容,幫助視頻創作者節省錄製時間,快速完成視頻配音。 有聲讀物與在線教育:支持中文和英文的高質量語音合成,能爲有聲讀物和在線教育平台提供自然的語音朗讀服務,提升用戶體驗。 智能客服與語音助手:IndexTTS 的零樣本語音克隆能力和高自然度表現適合用於智能客服和語音助手場景,能快速適應不同的語音風格和語速。 多媒體與娛樂:在多媒體和娛樂領域,IndexTTS 可以用於生成個性化語音內容,例如遊戲配音、虛擬角色對話等,爲用戶提供更具沉浸感的體驗。 無障礙輔助技術:高效的語音合成能力和低錯誤率,IndexTTS 可以爲視障人士提供語音輔助功能,幫助他們更好地獲取信息。
ViiTor AI – AI視頻翻譯、語音克隆、動態語音合成技術等多功能AI平台
ViiTor AI是什麼 ViiTor AI是...
Muyan-TTS – 開源文本轉語音模型,零樣本語音合成
Muyan-TTS是什麼 Muyan-TTS ...
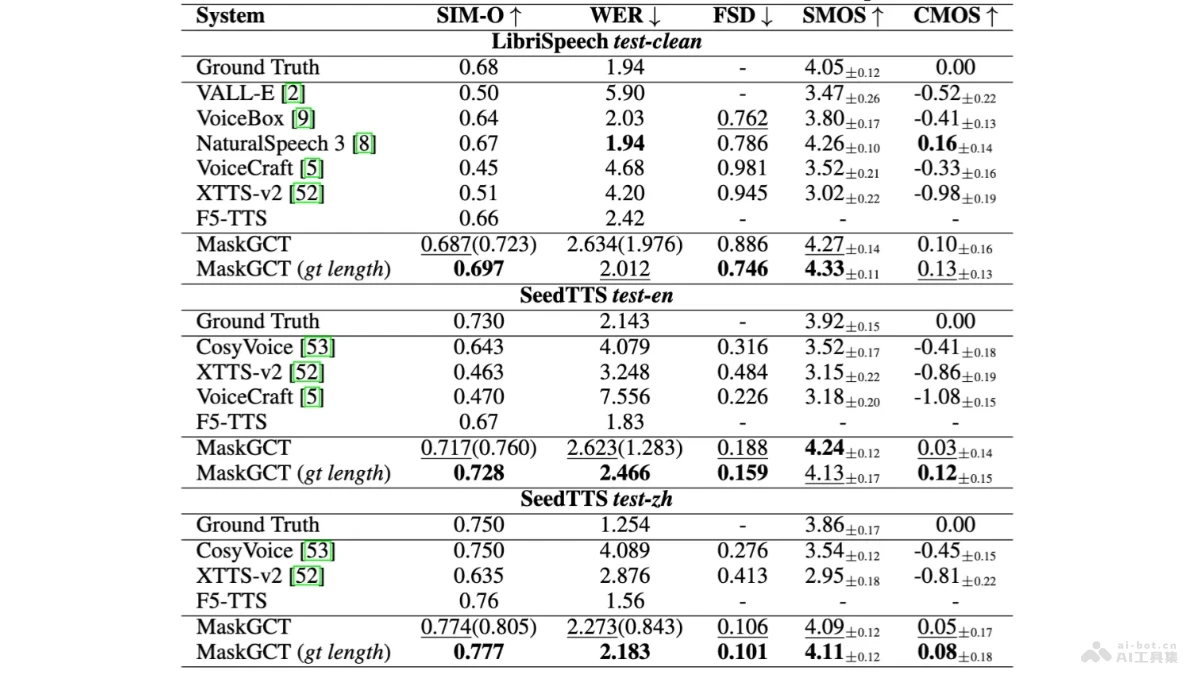
MaskGCT – 趣丸科技聯合香港中文大學推出的語音合成大模型
MaskGCT是什麼 MaskGCT是趣丸...
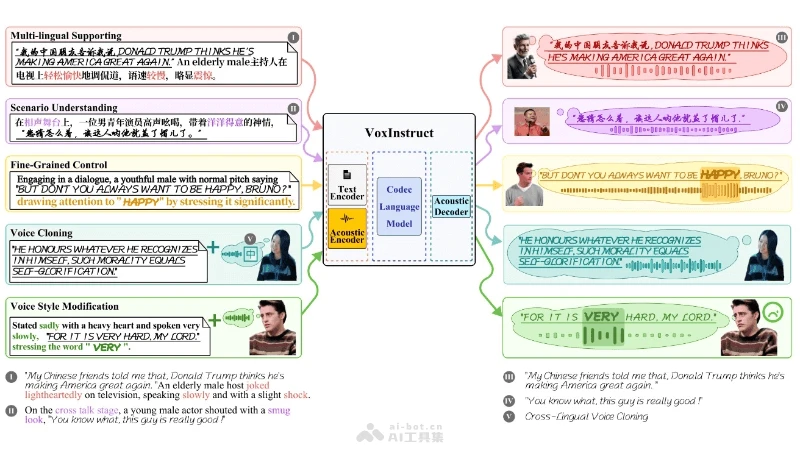
VoxInstruct – 清華推出的開源語音合成技術,支持多語言和跨語言合成
VoxInstruct是什麼 VoxInstru...
Fish Speech – 開源的高效文本到語音合成TTS工具
Fish Speech是什麼 Fish Spee...
ChatTTS – 開源的用於對話的生成式語音合成模型
ChatTTS是什麼 ChatTTS是一款...
Voice Engine – OpenAI公佈的AI語音合成和聲音克隆模型
Voice Engine是什麼 Voice En...
Voice Engine - OpenAI公佈的AI語音合成和聲音克隆模型
Voice Engine是什麼 Voice En...