最好用的AI工具
搜尋:語音克隆
7 個結果
IndexTTS-2.5 – Bilibili 開源的工業級零樣本語音克隆模型
IndexTTS-2.5是什麼 IndexTTS...
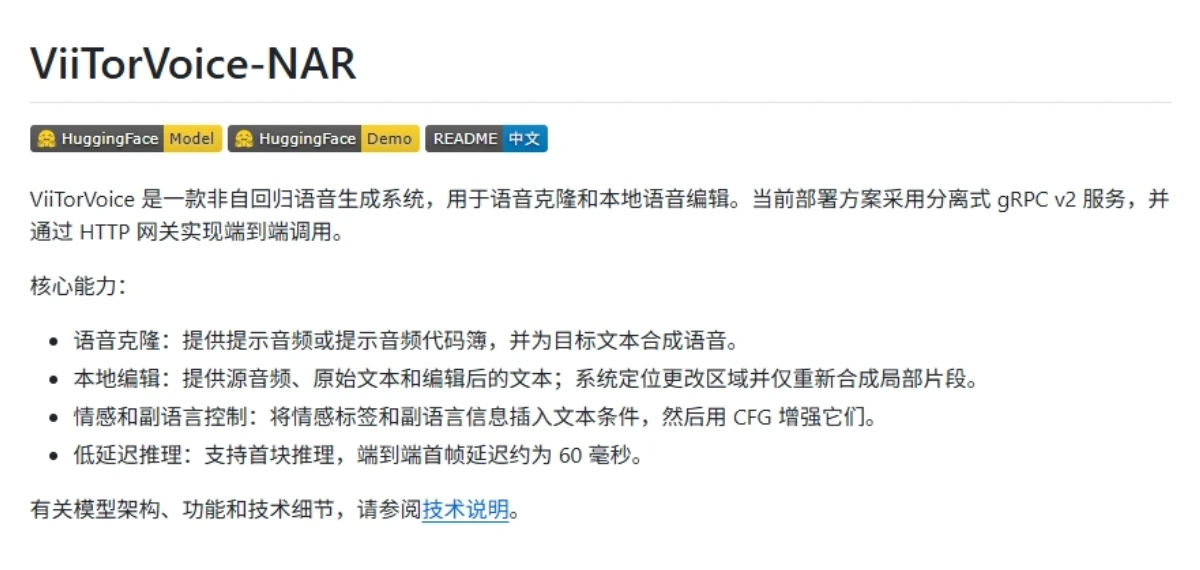
ViiTorVoice-NAR實測 – 開源免費的語音克隆工具
今天發點適合做音色復刻的東...
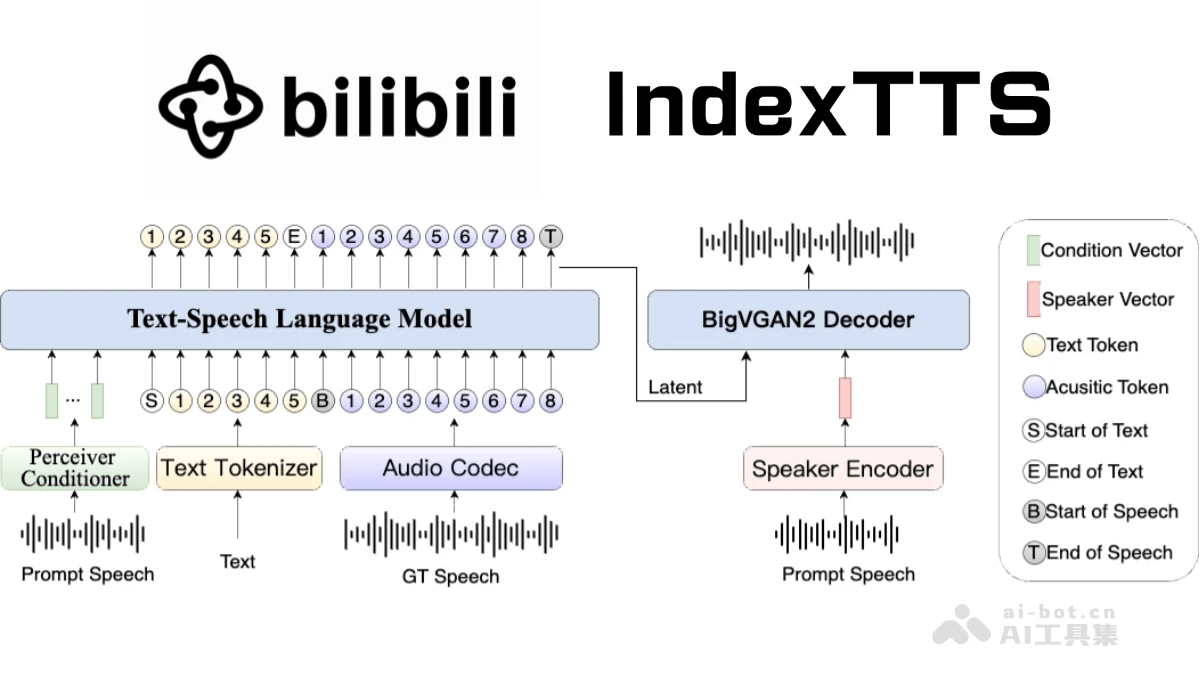
IndexTTS – B 站推出的文本轉語音模型,支持拼音糾正漢字發音
IndexTTS是什麼 IndexTTS 是 B 站推出的工業級可控文本轉語音(TTS)系統。基於 XTTS 和 Tortoise 模型開發,結合了 GPT 風格的生成技術,能將文本高效轉化爲自然流暢的語音。IndexTTS 的優勢是對中文文本的處理能力,支持拼音糾正漢字發音,可通過標點符號精準控制停頓,有效解決了多音字和長尾字符的發音問題。 採用混合建模方法,結合漢字和拼音,優化語音生成效果。在性能方面,IndexTTS 的字詞錯誤率(WER)僅爲 1.3%,揚聲器相似性(SS)達到 0.776,主觀音質評分(MOS)爲 4.01,表現出色。使用大量數據進行訓練,包括 2.5 萬小時的中文音頻和 9000 小時的英文音頻,確保了音質和音色的高質量。 最新自研的IndexTTS2 全新一代語音合成模型,能實現精準的時長控制和情感再現,支持音色與情緒獨立調整,能在多種語言和風格下生成自然流暢的語音,廣泛應用視頻配音、語言學習等領域,模型在情感表達和文本準確性上均達到行業領先水平。 IndexTTS的主要功能 拼音糾正與停頓控制:IndexTTS 在處理中文文本時,能通過拼音糾正漢字的發音,用標點符號在任意位置精準控制停頓,語音輸出更加自然流暢。 音質優化:引入了基於 Conformer 的條件編碼器和 BigVGAN2 語音解碼器,顯著提高了音質和音色相似性,MOS 評分達到 4.01。 多語言支持:目前支持中文和英文,計劃在未來擴展到更多語言。 IndexTTS的技術原理 混合建模方法:在中文場景下,IndexTTS 採用字符與拼音混合建模的方式。通過結合漢字和拼音,系統能快速糾正多音字和長尾字符的發音錯誤,提高語音合成的準確性和可控性。 語音編碼與解碼優化:IndexTTS 引入了基於 Conformer 的條件編碼器和 BigVGAN2 語音解碼器。Conformer 編碼器能夠更好地捕捉語音的音色特徵,BigVGAN2 解碼器則提升了音質和音色相似性。 零樣本語音克隆:IndexTTS 在零樣本語音克隆方面表現出色,能在沒有目標語音樣本的情況下生成高質量的語音。揚聲器相似性(SS)高達 0.776,MOS 評分達到 4.01,遠超現有系統。 高效的訓練與推理:系統經過數萬小時的數據訓練,訓練過程簡單且穩定,推理速度快。與 XTTS、CosyVoice2、Fish-Speech 和 F5-TTS 等系統相比,IndexTTS 在自然度、內容一致性和零樣本語音克隆方面表現出色。 IndexTTS的項目地址 IndexTTS: Github倉庫:https://github.com/index-tts/index-tts arXiv技術論文:https://arxiv.org/pdf/2502.05512 IndexTTS2: 項目官網:https://index-tts.github.io/index-tts2.github.io/ HuggingFace模型庫:https://huggingface.co/IndexTeam/IndexTTS-2 arXiv技術論文:https://arxiv.org/pdf/2506.21619 IndexTTS的應用場景 內容創作與視頻配音:IndexTTS 可以快速生成自然流暢的語音內容,幫助視頻創作者節省錄製時間,快速完成視頻配音。 有聲讀物與在線教育:支持中文和英文的高質量語音合成,能爲有聲讀物和在線教育平台提供自然的語音朗讀服務,提升用戶體驗。 智能客服與語音助手:IndexTTS 的零樣本語音克隆能力和高自然度表現適合用於智能客服和語音助手場景,能快速適應不同的語音風格和語速。 多媒體與娛樂:在多媒體和娛樂領域,IndexTTS 可以用於生成個性化語音內容,例如遊戲配音、虛擬角色對話等,爲用戶提供更具沉浸感的體驗。 無障礙輔助技術:高效的語音合成能力和低錯誤率,IndexTTS 可以爲視障人士提供語音輔助功能,幫助他們更好地獲取信息。
ViiTor AI – AI視頻翻譯、語音克隆、動態語音合成技術等多功能AI平台
ViiTor AI是什麼 ViiTor AI是...
Videco – AI營銷視頻生成平台,支持多語言語音克隆和動態變量
Videco是什麼 Videco 是專注...
Zonos – ZyphraAI 開源的多語言 TTS 模型
Zonos是什麼 Zonos是Zyphra推出的高保真文本到語音(TTS)模型。Zonos包含兩個模型:16億參數的Transformer模型和SSM混合模型,均在Apache 2.0許可下開源。Zonos根據文本提示和說話人嵌入生成自然、高表達性的語音,支持語音克隆功能,可調節語速、音高、情感等參數,輸出採樣率爲44kHz。模型基於約20萬小時的多語言語音數據訓練,主要支持英語,對其他語言的支持有限。Zonos提供優化的推理引擎,支持快速生成語音,適合實時應用。 Zonos的主要功能 零樣本TTS與語音克隆:輸入文本和10-30秒的說話者樣本,能生成高質量的TTS輸出。 音頻前綴輸入:基於添加文本和音頻前綴,更精確地匹配說話者的聲音,和實現難以通過說話者嵌入複製的行爲,如耳語。 多語言支持:支持英語、日語、中文、法語和德語。 音頻質量和情感控制:支持精細控制語速、音高、最大頻率、音頻質量和各種情感。 Zonos的技術原理 文本預處理:基於eSpeak工具進行文本歸一化和音素化,將輸入文本轉換爲音素序列。 特徵預測:用Transformer或混合骨幹網絡(Hybrid Backbone)預測DAC(Discrete Audio Codec)標記。 語音生成:基於預測的DAC標記,用自編碼器(Autoencoder)解碼生成高質量的語音輸出。 Zonos的項目地址 項目官網:https://www.zyphra.com/post/beta-release-of-zonos-v0-1 GitHub倉庫:https://github.com/Zyphra/Zonos Zonos的應用場景 有聲讀物與在線教育:將文本內容轉換爲自然流暢的語音,爲有聲讀物和在線課程提供高質量的語音旁白。 虛擬助手與客服:在虛擬助手和客服系統中,生成自然的語音交互,提供更人性化的用戶體驗。 多媒體內容創作:在視頻製作、動畫和廣告中,生成高質量的旁白和配音。 無障礙技術:爲視障人士提供語音閱讀服務,將網頁、文檔和書籍的內容轉換爲語音,幫助他們更好地獲取信息。 遊戲與互動娛樂:在遊戲和互動娛樂應用中,生成角色對話和旁白,增強遊戲的沉浸感。
OpenVoice - 免費開源的AI語音克隆項目
OpenVoice是由MyShell推出的...