最好用的AI工具
搜尋:視頻
290 個結果
Vidu Claw – Vidu AI推出的 AI 視頻創作 Agent
Vidu Claw是什麼 Vidu Claw「...
微信編輯器哪個好用?新手TOP級公衆號排版工具用這個就夠了
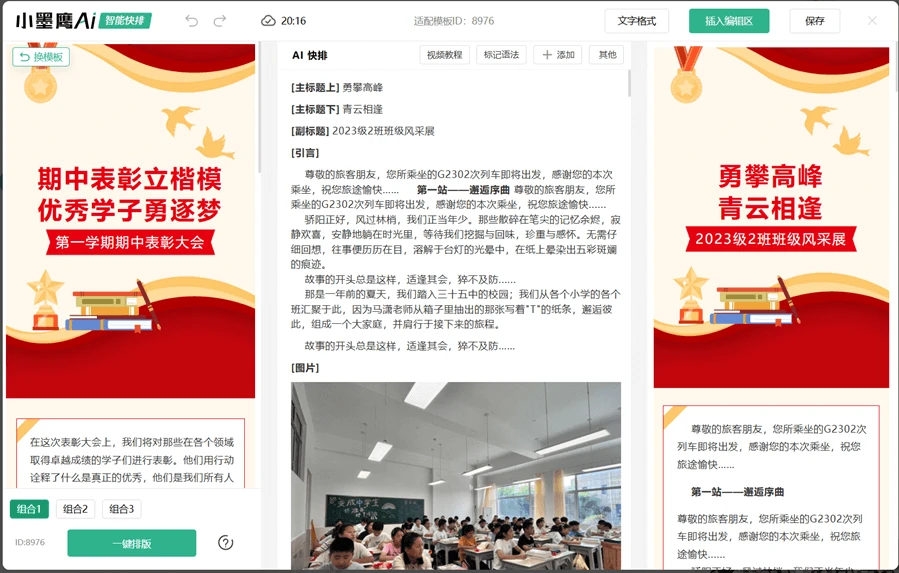
“一篇推文寫了2小時,排版卻花了半天!” “老闆要求精美動效,可我連SVG代碼都不懂…” “明天要發5條推文,今晚又要通宵改格式了…” 如果你也是公衆號運營者,這些哭訴一定不陌生。傳統排版工作佔用了內容創作者60%以上的時間——找模板、調格式、對齊圖片、設置動效、反覆預覽,一套流程下來早已精疲力盡。 市場上微信編輯器琳琅滿目,各自的功能差異明顯,究竟哪款更適合新手或者自己呢? 今天,小墨鷹編輯器用AI徹底改變了這個現狀。經過10年技術深耕,服務500萬用戶,能讓30秒完成專業級排版,效率直接提升300%。 下面,我將結合數據和實際測評,詳細解析爲什麼小墨鷹編輯器成爲最值得推薦的新手公衆號排版工具。 01. 極致排版體驗 AI快排:30秒完成3小時工作量 這是行業內首創的AI全自動排版功能。你只需: 導入Word文檔或直接撰寫內容 AI自動識別標題層級、段落結構、圖文關係(準確率達96%) 30秒內自動匹配模板、配色、配圖方案 實測案例:某企業市場專員導入一份產品手冊,AI自動拆解出”大標題+引言+3個賣點+對比表格+二維碼”結構,全程0手動操作,直接生成商務風精美排版。 25萬+模板庫,冷門行業也有專屬設計 市面上編輯器模板往往只有幾千套,小墨鷹擁有25萬+單素材: 45大行業全覆蓋:教育、醫療、政務、科技、母嬰、金融… 每日更新:連”世界廁所日”這種冷門節日都有專屬模板 一鍵秒刷換色:選中模板後,一鍵切換企業品牌色 傻瓜式SVG動效:無需代碼,替換文字即可 想做出點擊展開、圖片輪播、滑動切換的效果? 傳統方式:學習SVG代碼,調試3小時起步 小墨鷹方式:選擇3000+現成動效素材 → 彈窗中替換文字和圖片 → 直接發佈 某幼兒園老師反饋:”用輪播SVG展示孩子們的活動照片,家長閱讀量提升了200%!” 安全合規雙認證,大企業都在用 不同於市面上”三無”排版工具,小墨鷹已完成: 《互聯網信息服務算法備案》(網信算備號可查) 微信開發平台官方認證 02. 實操指南:新手5分鐘完成專業推文 第一步:快速註冊登錄 訪問官網:https://www.xmyeditor.com,支持PC端+手機端跨設備操作,雲端自動保存草稿。 第二步:選擇創作方式 有現成文檔:直接導入Word/PPT/PDF,AI自動識別結構 從零撰寫:在編輯區寫作,實時使用”AI續寫”功能輔助創作 熱點跟進:使用內置”熱點日曆”查看今日可借勢話題 第三步:AI一鍵排版,點擊【AI快排】按鈕,系統會: 分析文章類型(活動通知/產品介紹/政策解讀) 自動推薦3-5套匹配模板 完成字體、配色、間距、配圖的全局優化 第四步:添加互動效果(可選),在【素材庫】→【SVG動效】中選擇: 點擊展開:適合放置活動詳情或優惠碼 自動輪播:展示多張產品圖或團隊照片 滑動解鎖:增加閱讀趣味性 操作:選中素材 → 彈窗提示替換文字/圖片 → 確認即可,全程鼠標點擊,零代碼。 第五步:多平台分發 同步公衆號:一鍵授權至微信後台,支持定時羣發 導出長圖:生成最高10萬像素長圖,適合朋友圈傳播 導出PDF:直接打印成宣傳手冊 03. 案例分享 案例1:幼師張女士(教育行業) 背景:幼兒園需要每週發佈3篇活動推文,之前找設計師外包,單篇成本200元,耗時2天。 使用小墨鷹後: 直接導入活動策劃Word文檔 → AI快排30秒生成 使用”卡通可愛”風格模板+SVG照片輪播 單篇製作時間從2天縮短至15分鐘 家長閱讀量提升200%,園方決定取消外包,全部自營 案例2:某政務新媒體(政府宣傳) 背景:需要發佈政策解讀類文章,要求紅色政務風格+嚴肅排版+版權安全。 使用小墨鷹後: 選用”紅色政務”專題模板,確保視覺規範 利用正版商用字體,避免法律風險 通過AI快排快速響應熱點,從撰稿到發佈縮短至1小時內 案例3:連鎖餐飲品牌(商業營銷) 背景:管理5個區域公衆號賬號,需要統一品牌風格但內容不同。 使用小墨鷹後: 綁定多賬號(支持3-20個號),切換自如 設置品牌專屬模板庫,加盟商直接調用 參數二維碼功能追蹤各門店推廣效果 04. FAQ:新手最關心的問題 Q:完全沒有設計基礎,能上手嗎? A:小墨鷹定位就是“新手TOP級工具”,86%的用戶推薦率來自零基礎用戶。AI快排全程自動,SVG動效也是傻瓜式操作,官網有3分鐘視頻教程包教包會。 Q:免費版和付費版有什麼區別? A:免費版已包含大量基礎模板和AI快排功能,足夠個人使用;付費版(價格親民)解鎖25萬+全行業模板、AI去水印、多賬號管理等進階功能,
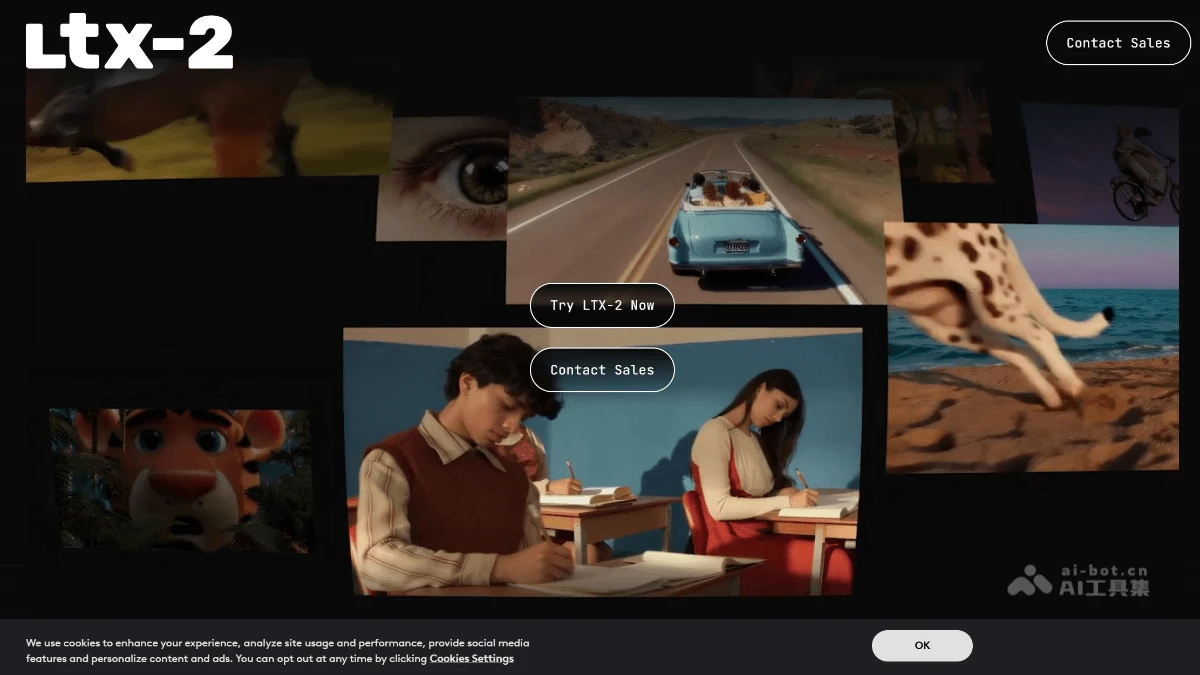
LTX-2 – Lightricks推出的電影級AI視頻生成模型
LTX-2是什麼 LTX-2 是 Lightr...
UniPixel – 香港理工聯合騰訊推出的像素級多模態大模型
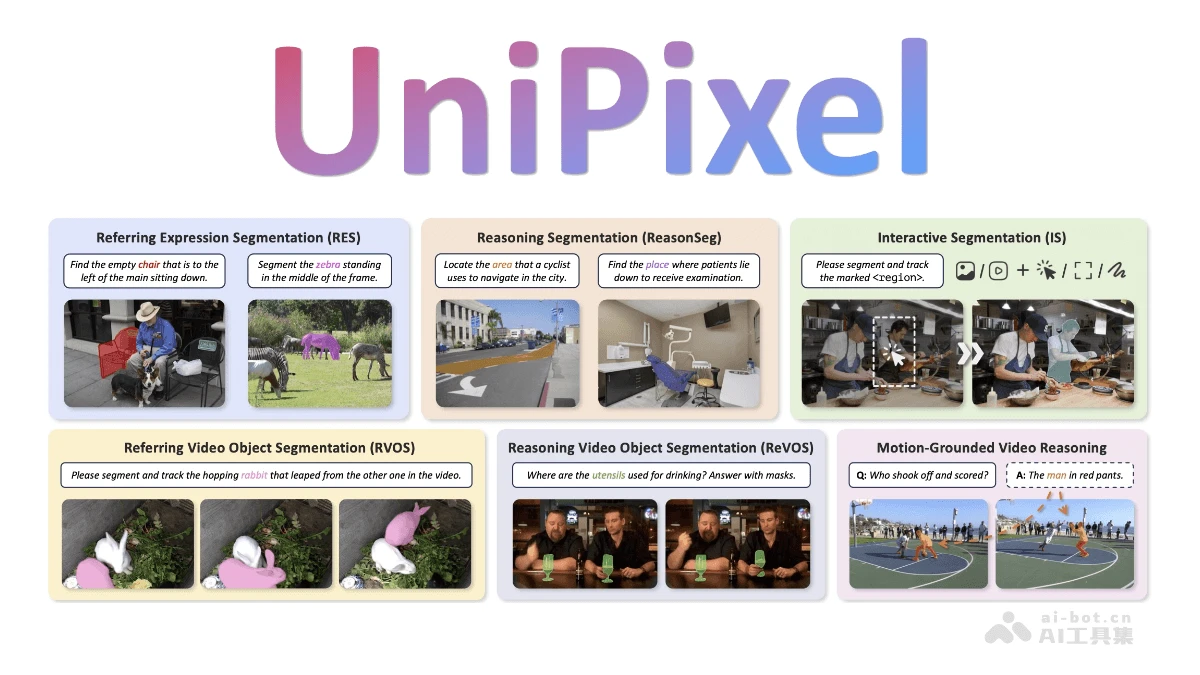
UniPixel是什麼 UniPixel是香港理工大學和騰訊ARC Lab團隊開發的首個統一像素級多模態大模型,專注於圖像/視頻的精細理解與交互。能在單個模型中完成對象指代、像素級分割和區域推理三大任務,通過創新設計的”對象記憶機制”和統一視覺編碼方式,實現了對視頻中目標的精準追蹤與語義理解。模型基於Qwen2.5-VL框架,支持點、框、掩碼三種交互方式,在9項視覺任務基準測試中超越72B參數的傳統模型,開源了代碼和在線Demo。核心突破在於將視覺分割與語言推理深度融合,解決了傳統模型無法處理複雜指代和動態區域理解的問題。 UniPixel的主要功能 像素級視覺語言理解:專注於像素級視覺語言理解,能實現視覺信號與語言語義之間的像素級對齊,支持多種細粒度任務,包括圖像/視頻分割、區域理解以及PixelQA任務。 統一對象指代與分割:模型將對象指代和分割能力無縫集成,能根據視覺提示輸入生成相關的掩碼,並在推理過程中基於這些中間指針進行後續推理,實現細粒度的像素級推理。 多任務支持:在多個基準測試中表現出色,包括ReVOS推理分割基準、MeViS、Ref-YouTube-VOS、RefCOCO/+/g等數據集,設計了新的PixelQA任務,要求模型聯合進行對象指代、分割和問答。 靈活的視覺提示處理:能靈活處理視覺提示輸入,生成掩碼並進行推理,支持單幀和多幀的視頻區域理解,以及基於掩碼的問答任務。 UniPixel的技術原理 統一框架設計:UniPixel採用統一框架,將對象指代和分割能力整合到一個模型中,實現從粗粒度場景理解到細粒度像素推理的跨越,爲複雜視覺推理提供基礎。 對象記憶庫:模型包含對象記憶庫,存儲從指代任務中提取的對象特徵,爲後續的分割和推理任務提供上下文信息,增強模型在像素級任務上的性能。 多階段訓練策略:採用預訓練、指代任務微調和分割任務微調的多階段訓練策略,逐步提升模型在像素級任務上的性能,適應不同任務需求。 端到端掩碼生成:模型能根據語言描述直接生成像素級掩碼,實現語言與視覺的深度融合,支持多種細粒度任務,如圖像/視頻分割和區域理解。 靈活的視覺提示處理:能靈活處理視覺提示輸入,生成掩碼並進行推理,支持單幀和多幀的視頻區域理解,以及基於掩碼的問答任務,適應不同場景需求。 強大的推理能力:在VideoRefer-Bench-Q問答任務中,UniPixel-7B模型取得了74.1%的準確率,超越了包括GPT-4o在內的多個強大基準模型,顯示出其在複雜視覺推理任務中的強大能力。 模型權重與數據集提供:提供了UniPixel-3B和UniPixel-7B兩個版本的模型權重,以及23個指代/分割/QA數據集的原始圖像/視頻和預處理註釋,爲研究和應用提供豐富資源。 訓練與評估支持:代碼庫支持在23個數據集和基準測試上進行訓練和評估,支持靈活的硬件設置、高效的訓練技術、自定義基礎LLM和對話模板,以及通過Tensorboard/Wandb監控訓練過程,方便用戶使用和優化。 UniPixel的項目地址 項目官網:https://polyu-chenlab.github.io/unipixel/ Github倉庫:https://github.com/PolyU-ChenLab/UniPixel HuggingFace數據:https://huggingface.co/datasets/PolyU-ChenLab/UniPixel-SFT-1M arXiv技術論文:https://arxiv.org/pdf/2509.18094 在線體驗Demo:https://huggingface.co/spaces/PolyU-ChenLab/UniPixel UniPixel的應用場景 圖像分割:UniPixel能根據語言描述生成圖像中特定對象的像素級掩碼,適用於需要精確圖像分割的場景,如醫學圖像分析、自動駕駛中的目標分割等。 視頻分割:在視頻處理領域,UniPixel可以對視頻中的對象進行實時分割,支持視頻編輯、視頻監控和增強現實等應用。 區域理解:通過理解語言描述來識別和分割視頻中的特定區域,可用於視頻內容分析、智能監控系統和視頻會議中的背景分割等。 問答任務:UniPixel支持PixelQA任務,能夠根據語言描述和視覺信息回答問題,適用於教育、智能客服和信息檢索等場景。 多模態交互:在需要結合視覺和語言信息進行交互的場景中,如智能助手、虛擬現實和遊戲開發等,UniPixel能夠提供更自然和準確的交互體驗。 智能監控:在安防監控領域,UniPixel可以實時識別和分割監控視頻中的特定對象或區域,提高監控系統的智能化水平。
Storyroll – AI視頻創作平台,生成無限時長視頻
Storyroll是什麼 Storyroll ...
HuMo – 清華聯合字節推出的多模態視頻生成框架
HuMo是什麼 HuMo是清華大學和...
IndexTTS – B 站推出的文本轉語音模型,支持拼音糾正漢字發音
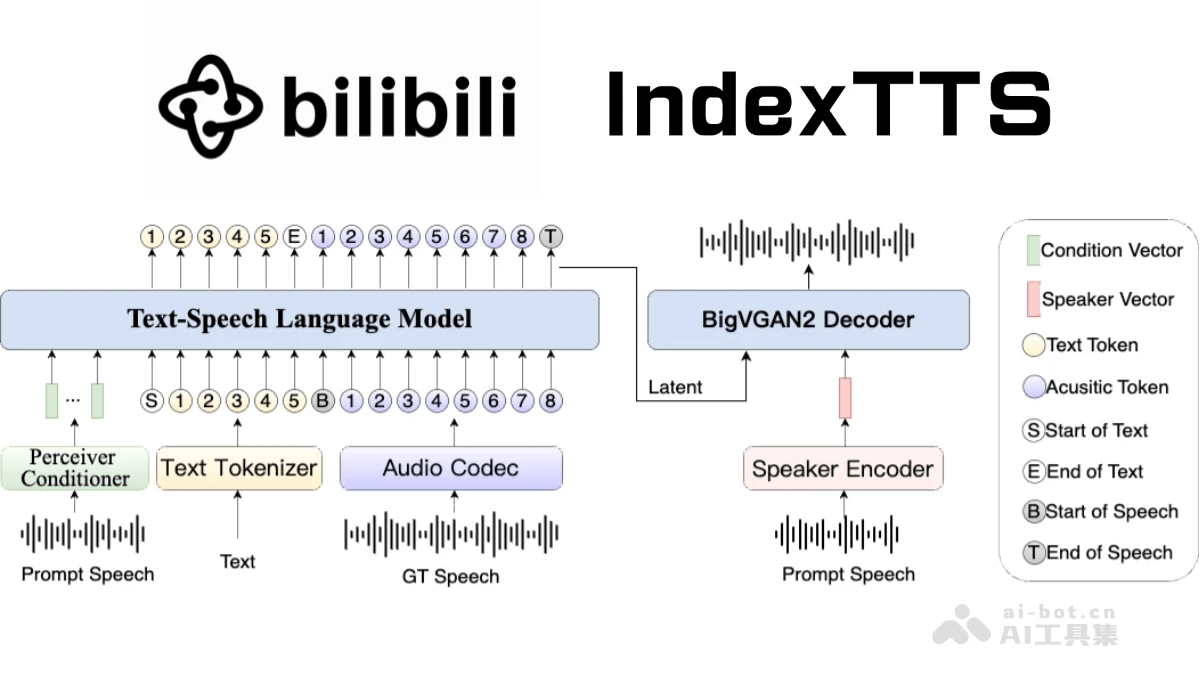
IndexTTS是什麼 IndexTTS 是 B 站推出的工業級可控文本轉語音(TTS)系統。基於 XTTS 和 Tortoise 模型開發,結合了 GPT 風格的生成技術,能將文本高效轉化爲自然流暢的語音。IndexTTS 的優勢是對中文文本的處理能力,支持拼音糾正漢字發音,可通過標點符號精準控制停頓,有效解決了多音字和長尾字符的發音問題。 採用混合建模方法,結合漢字和拼音,優化語音生成效果。在性能方面,IndexTTS 的字詞錯誤率(WER)僅爲 1.3%,揚聲器相似性(SS)達到 0.776,主觀音質評分(MOS)爲 4.01,表現出色。使用大量數據進行訓練,包括 2.5 萬小時的中文音頻和 9000 小時的英文音頻,確保了音質和音色的高質量。 最新自研的IndexTTS2 全新一代語音合成模型,能實現精準的時長控制和情感再現,支持音色與情緒獨立調整,能在多種語言和風格下生成自然流暢的語音,廣泛應用視頻配音、語言學習等領域,模型在情感表達和文本準確性上均達到行業領先水平。 IndexTTS的主要功能 拼音糾正與停頓控制:IndexTTS 在處理中文文本時,能通過拼音糾正漢字的發音,用標點符號在任意位置精準控制停頓,語音輸出更加自然流暢。 音質優化:引入了基於 Conformer 的條件編碼器和 BigVGAN2 語音解碼器,顯著提高了音質和音色相似性,MOS 評分達到 4.01。 多語言支持:目前支持中文和英文,計劃在未來擴展到更多語言。 IndexTTS的技術原理 混合建模方法:在中文場景下,IndexTTS 採用字符與拼音混合建模的方式。通過結合漢字和拼音,系統能快速糾正多音字和長尾字符的發音錯誤,提高語音合成的準確性和可控性。 語音編碼與解碼優化:IndexTTS 引入了基於 Conformer 的條件編碼器和 BigVGAN2 語音解碼器。Conformer 編碼器能夠更好地捕捉語音的音色特徵,BigVGAN2 解碼器則提升了音質和音色相似性。 零樣本語音克隆:IndexTTS 在零樣本語音克隆方面表現出色,能在沒有目標語音樣本的情況下生成高質量的語音。揚聲器相似性(SS)高達 0.776,MOS 評分達到 4.01,遠超現有系統。 高效的訓練與推理:系統經過數萬小時的數據訓練,訓練過程簡單且穩定,推理速度快。與 XTTS、CosyVoice2、Fish-Speech 和 F5-TTS 等系統相比,IndexTTS 在自然度、內容一致性和零樣本語音克隆方面表現出色。 IndexTTS的項目地址 IndexTTS: Github倉庫:https://github.com/index-tts/index-tts arXiv技術論文:https://arxiv.org/pdf/2502.05512 IndexTTS2: 項目官網:https://index-tts.github.io/index-tts2.github.io/ HuggingFace模型庫:https://huggingface.co/IndexTeam/IndexTTS-2 arXiv技術論文:https://arxiv.org/pdf/2506.21619 IndexTTS的應用場景 內容創作與視頻配音:IndexTTS 可以快速生成自然流暢的語音內容,幫助視頻創作者節省錄製時間,快速完成視頻配音。 有聲讀物與在線教育:支持中文和英文的高質量語音合成,能爲有聲讀物和在線教育平台提供自然的語音朗讀服務,提升用戶體驗。 智能客服與語音助手:IndexTTS 的零樣本語音克隆能力和高自然度表現適合用於智能客服和語音助手場景,能快速適應不同的語音風格和語速。 多媒體與娛樂:在多媒體和娛樂領域,IndexTTS 可以用於生成個性化語音內容,例如遊戲配音、虛擬角色對話等,爲用戶提供更具沉浸感的體驗。 無障礙輔助技術:高效的語音合成能力和低錯誤率,IndexTTS 可以爲視障人士提供語音輔助功能,幫助他們更好地獲取信息。
AutoClip – 開源免費AI視頻剪輯工具,自動識別高光片段
AutoClip是什麼 AutoClip是開...
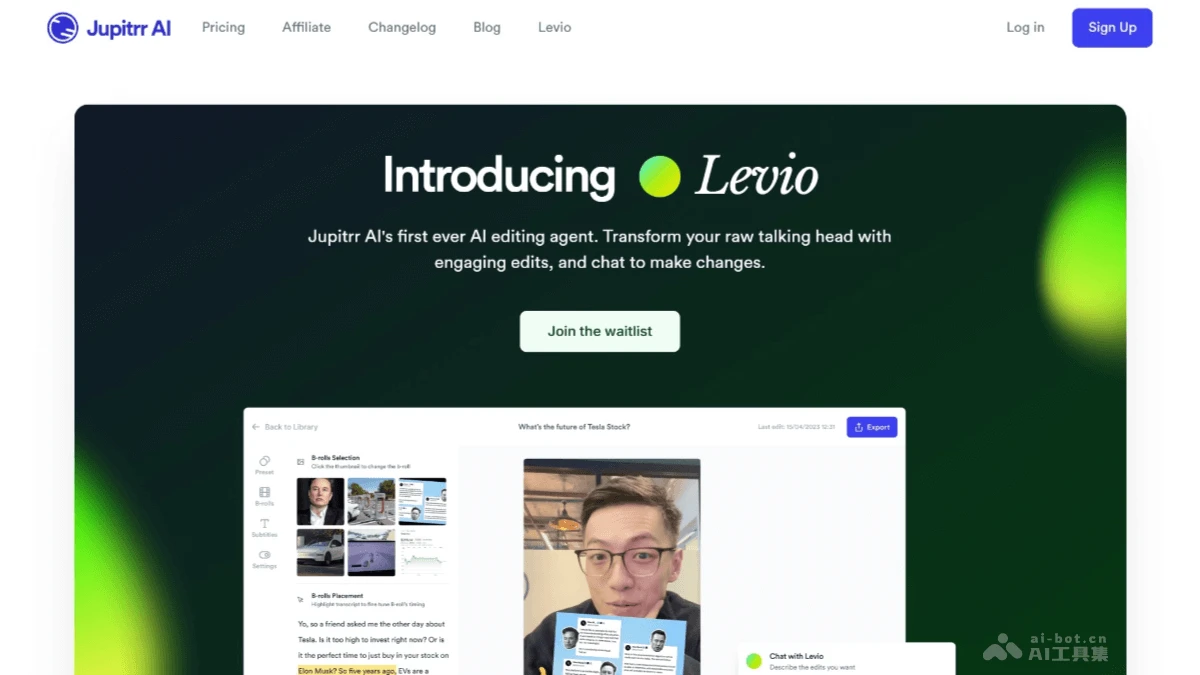
Jupitrr AI – AI視頻編輯工具,自動生成多語言字幕
Jupitrr AI是什麼 Jupitrr AI...
Deep Video Discovery – 微軟推出的深度視頻探索智能體
Deep Video Discovery是什麼 Deep Video Discovery(DVD)是微軟推出的深度視頻探索智能體,專爲理解和分析長視頻設計。Deep Video Discovery將長視頻分割成多個較短的片段,基於大型語言模型(LLM)的高級推理能力,自主地規劃和選擇合適的工具及參數來收集信息。Deep Video Discovery配備一套搜索中心的工具,包括全局瀏覽、片段搜索和幀檢查,能在不同層次上收集信息,基於迭代推理逐步構建對視頻內容的理解。在多個長視頻理解基準測試中,Deep Video Discovery均取得最先進的性能,顯著提高長視頻理解的準確性和效率。 Deep Video Discovery的主要功能 多粒度視頻理解:從全局、片段和幀三個層次理解和分析視頻內容,提供全面的視頻理解能力。 自主搜索與推理:自主地規劃和執行搜索策略,根據用戶查詢動態選擇合適的工具和參數,逐步收集信息並構建對視頻內容的理解。 高效信息檢索:基於全局瀏覽、片段搜索和幀檢查等工具,快速定位和提取與用戶查詢相關的視頻片段和細節。 長視頻理解:擅長處理長達數小時的信息密集型視頻,能有效解決長視頻理解中的時間和空間複雜性問題。 靈活的工具使用:根據不同的任務需求,靈活組合和使用多種工具,實現高效的視頻內容分析和問題回答。 Deep Video Discovery的技術原理 多粒度視頻數據庫構建:將長視頻均勻分割成多個較短的片段(clips),每個片段大約5秒。從全局、片段和幀三個層次提取視頻信息。全局層提供視頻的主體和事件總結,片段層提供文本描述(caption),幀層保留原始像素信息。構建一個包含解碼幀、文本描述和對應嵌入向量的結構化數據庫,支持快速檢索和詳細分析。 自主搜索與答案生成: 全局瀏覽(Global Browse):提供視頻的全局總結,幫助代理快速解視頻的主體和主要事件。 片段搜索(Clip Search):基於文本嵌入匹配,快速檢索與用戶查詢相關的視頻片段。 幀檢查(Frame Inspect):在特定時間範圍內進行細粒度的視覺問答(VQA),提取幀級別的詳細信息。 自主代理設計:Agent基於迭代的觀察-推理-行動循環,用LLM的推理能力,動態選擇和使用工具,逐步收集信息並構建對視頻內容的理解。 迭代推理:Agent根據當前的觀察狀態和推理結果,選擇合適的工具和參數,逐步細化查詢,最終生成準確的答案。 LLM驅動的推理:LLM作爲核心,負責推理和規劃。LLM根據當前的對話歷史和觀察結果,選擇合適的工具和參數,動態調整推理策略。根據任務需求,靈活組合和使用不同的工具,構建多步驟的工具使用鏈,解決複雜的查詢任務。 Deep Video Discovery的項目地址 arXiv技術論文:https://arxiv.org/pdf/2505.18079 Deep Video Discovery的應用場景 教育領域:在線教育平台分析長視頻課程,學生快速定位到課程中特定知識點或章節。 體育賽事分析:體育賽事分析比賽視頻,快速提取關鍵事件。 視頻監控:安防監控系統中,實時分析監控視頻,快速識別異常行爲或事件。 影視製作:影視後期製作團隊分析拍攝素材,快速找到所需鏡頭。 企業會議記錄:企業分析會議視頻,快速提取會議要點和關鍵決策。
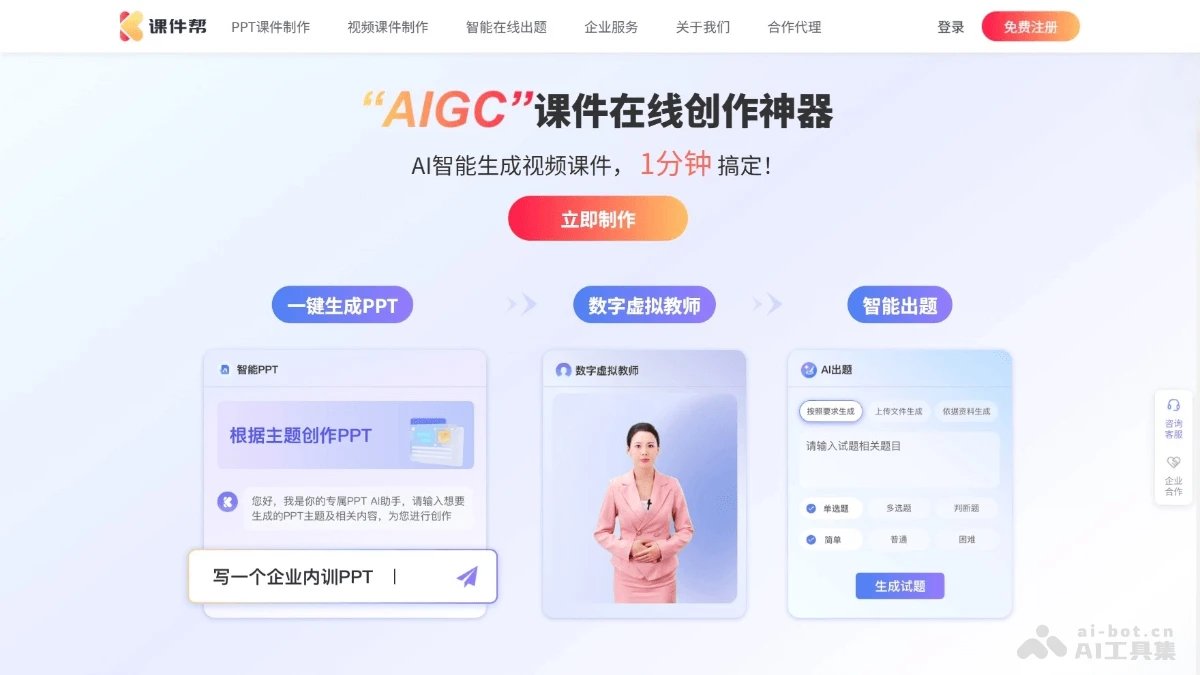
課件幫 – AI課件製作平台,一鍵生成數字人視頻課件
課件幫是什麼 課件幫是數字人...
MAGREF – 字節跳動推出的多主體視頻生成框架
MAGREF是什麼 MAGREF(Masked...
Seedance 1.0 – 字節跳動推出的視頻生成模型
Seedance 1.0是什麼 Seedance...
ViiTor AI – AI視頻翻譯、語音克隆、動態語音合成技術等多功能AI平台
ViiTor AI是什麼 ViiTor AI是...
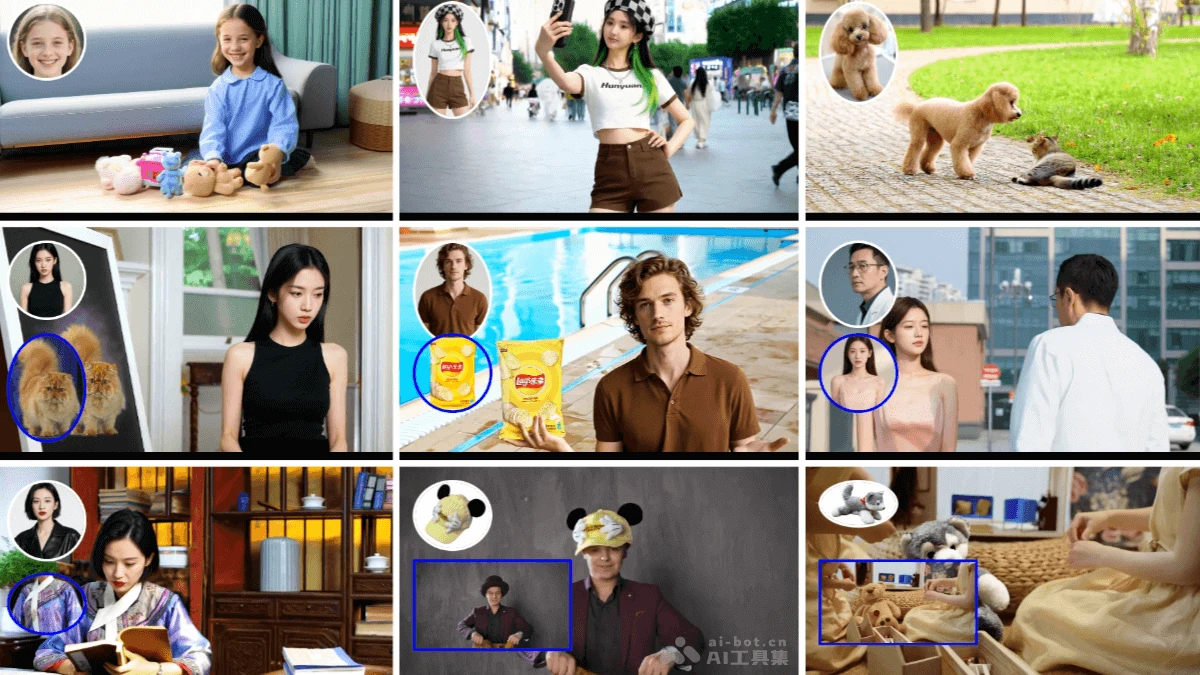
HunyuanCustom – 騰訊混元開源的多模態定製視頻生成框架
HunyuanCustom是什麼 Hunyuan...
BoomCut – 小影科技推出的AI跨境營銷視頻本地化工具
BoomCut是什麼 BoomCut(爆剪...
Seaweed-7B – 字節推出的視頻生成模型
Seaweed-7B是什麼 Seaweed-7B...
妙構 – AI視頻內容分析平台,解碼爆款視頻創作規律
妙構是什麼 妙構是專業的AI視...
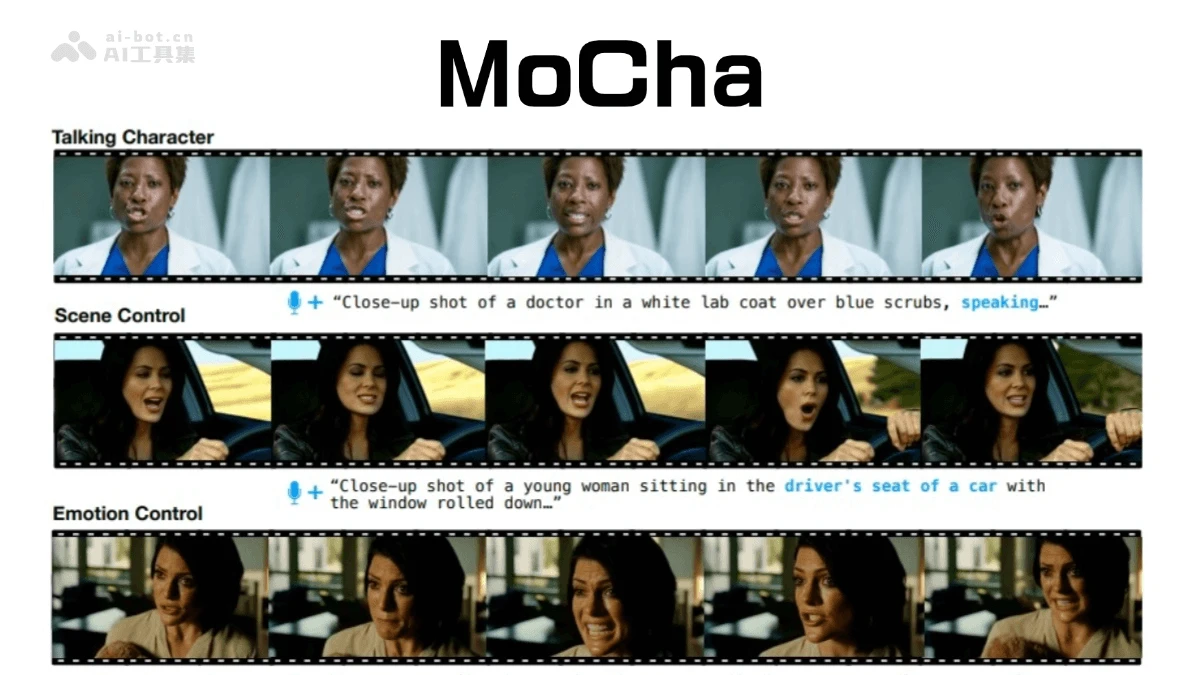
MoCha – Meta 聯合滑鐵盧大學推出的端到端對話角色視頻生成模型
MoCha是什麼 MoCha AI 是 Meta 和滑鐵盧大學聯合開發的端到端對話角色視頻生成模型。能根據文本或語音輸入生成帶有同步語音和自然動作的完整角色動畫。MoCha 採用語音-視頻窗口注意力機制,解決了視頻壓縮時音頻分辨率不匹配以及脣部動作錯位的問題。支持多角色輪換對話,能生成具有情感表達和全身動作的角色動畫。 MoCha的主要功能 語音驅動角色動畫生成:用戶輸入語音,MoCha 可以生成與語音內容同步的角色嘴型、面部表情、手勢及身體動作。 文本驅動角色動畫生成:用戶僅輸入文本腳本,MoCha 會先自動合成語音,再驅動角色進行完整的口型和動作表現。 全身動畫生成:與傳統僅生成面部表情或嘴型的模型不同,MoCha 能生成全身的自然運動,涵蓋嘴脣同步、手勢以及多角色之間的互動。 多角色輪番對話生成:MoCha 提供結構化提示模板與角色標籤,能自動識別對話輪次,實現角色間“你來我往”的自然對話呈現。在多角色場景中,用戶只需定義一次角色信息,可以通過簡單的標籤(如“人物1”“人物2”)在不同的場景中引用這些角色,無需重複描述。 MoCha的技術原理 擴散變壓器(DiT)架構:MoCha 基於擴散變壓器(Diffusion Transformer)架構,通過將文本和語音條件依次通過交叉注意力機制融入模型,有效捕捉語義和時間動態。能生成逼真且富有表現力的全身動作,同時確保角色動畫與輸入語音的精確同步。 語音-視頻窗口注意力機制:爲了解決視頻壓縮和並行生成帶來的語音-視頻對齊問題,MoCha 引入了語音-視頻窗口注意力機制。限制每個視頻標記只能關注與其時間上相鄰的音頻標記,提高口型同步的準確性和語音-視頻對齊效果。模擬了人類語音的運作方式,使角色的口型與對話內容精準匹配。 聯合訓練策略:MoCha 採用了聯合訓練策略,同時基於語音標註和文本標註的視頻數據進行訓練。增強了模型在多樣化角色動作上的泛化能力,通過自然語言提示實現對角色表情、動作、互動和環境的精細控制。 結構化提示模板:爲了簡化多角色對話的文本描述,MoCha 設計了結構化提示模板,通過爲每個角色分配唯一標籤在文本中使用這些標籤來描述角色的動作和互動。減少了冗餘,提高了模型在多角色場景中的生成效果。 多階段訓練框架:MoCha 採用了多階段訓練框架,根據鏡頭類型(如特寫鏡頭、中景鏡頭)對數據進行分類,逐步引入更復雜的任務。確保了模型在不同難度任務上的表現,同時提高了訓練效率。 MoCha的項目地址 項目官網:https://congwei1230.github.io/MoCha/ arXiv技術論文:https://arxiv.org/pdf/2503.23307 MoCha的應用場景 虛擬主播:MoCha 可以自動生成日常 Vlog、角色問答等內容。通過語音或文本輸入,生成與語音內容同步的角色嘴型、面部表情、手勢及身體動作,使虛擬主播更加生動自然。 動畫影視創作:MoCha 支持 AI 自動配音和自動動畫生成,能降低動畫影視創作的製作成本。能生成全身動畫,讓角色動作更加自然,接近電影級數字人演出。 教育內容創作:MoCha 可以作爲 AI 老師角色進行講課或互動。通過文本驅動的方式,生成與教學內容匹配的角色動畫,提高教育內容的趣味性和吸引力。 數字人客服:MoCha 可以用於擬人化企業客服、諮詢角色。通過語音或文本輸入,生成自然流暢的客服對話動畫,提升用戶體驗。
Product AnyShoot – TopView AI 推出的AI電商產品視頻生成工具
Product AnyShoot是什麼 Prod...