最好用的AI工具
搜尋:文生圖
15 個結果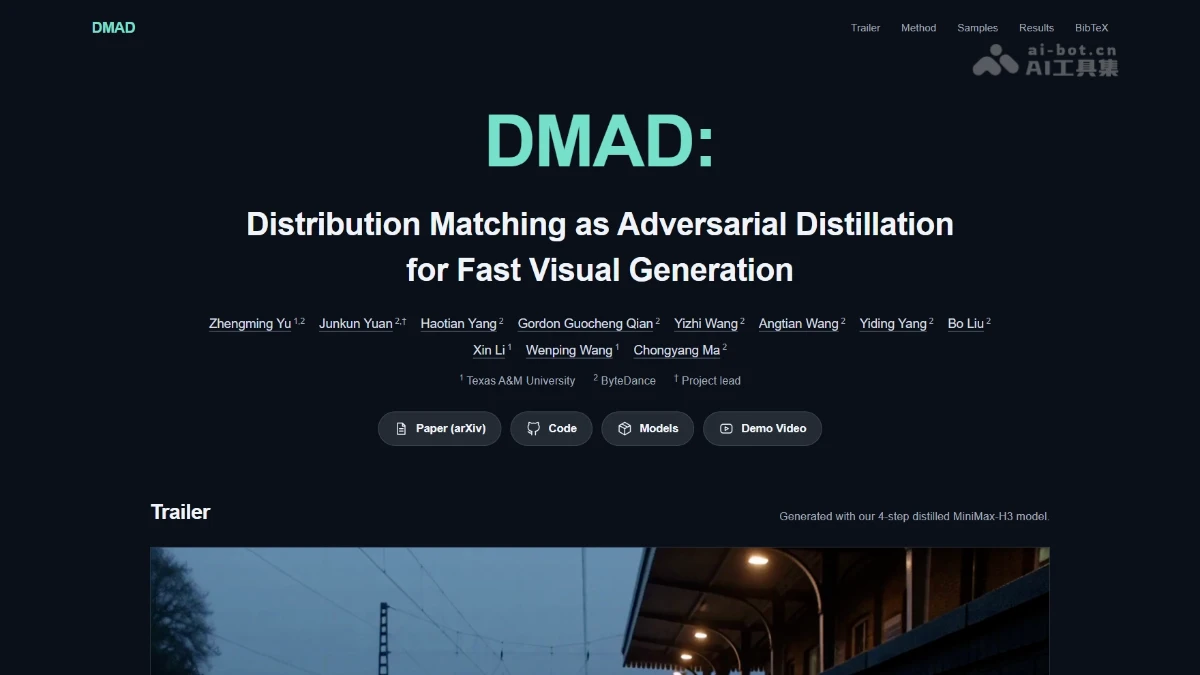
DMAD – 字節聯合德州農工開源的擴散模型少步蒸餾技術
DMAD是什麼 DMAD(Distribution Matching as Adversarial Distillation)是字節跳動與德州農工大學聯合開源的少步蒸餾框架,用於加速擴散模型生成。DMAD訓練二分類判別器直接學習目標分佈與學生分佈的差異,省去輔助擴散模型,將50步教師模型蒸餾爲4步學生模型。已支持ImageNet、SDXL、Wan2.1及MiniMax-H3-33B,8GB顯存可生成約5秒1344×768有聲視頻。 DMAD的主要功能 少步圖像生成:將 ImageNet-64 的 EDM 模型蒸餾至 1 步採樣,FID 低至 1.04,SDXL 僅需 4 步可文生圖。 少步文生視頻:把 Wan2.1-T2V-14B 蒸餾爲 4 步學生模型,VBench 達 85.15。 聯合音視頻生成:將 MiniMax-H3-33B 的 50 步教師模型蒸餾爲 4 步,輸出 1344×768 視頻與 32kHz 原生立體聲音頻。 消費級硬件支持:提供 8GB 顯存 ComfyUI 工作流與低顯存命令行推理,8GB 顯卡可生成約 5 秒、12GB 約 15 秒有聲視頻。 訓練與推理全開源:發佈蒸餾方法、訓練代碼、推理腳本及多模型 LoRA 權重,覆蓋命令行與 ComfyUI 兩種使用方式。 DMAD的技術原理 分佈匹配即對抗蒸餾:DMAD 爲訓練二分類判別器區分目標樣本與學生樣本,最優判別器的 logit 等於兩分佈的對數密度比,對其輸入求梯度即得 score 差,直接給出學生的修正方向,省掉輔助 score 擬合模型。 共享骨幹、雙頭判別器:判別器採用單一共享特徵骨幹、兩個判別頭,教師頭區分教師樣本與學生樣本,真實數據頭區分真實樣本與學生樣本,均用二元交叉熵訓練;學生用兩個 logit 的加權線性損失更新,更新時凍結判別器參數但保留梯度回傳。 噪聲區間動態加權:教師樣本與真實數據的分佈差異隨噪聲水平變化,DMAD 用真實數據頭在兩類樣本上的平均 logit 差作爲經驗信號,以 0.99 衰減的指數移動平均追蹤各噪聲區間,差距小的區間獲得更高教師權重,歸一化後參與學生損失。 離線教師樣本加速訓練:教師只提供預生成並緩存的樣本,訓練時無需在線調用教師。4 卡 H200、MiniMax-H3 rank-128 LoRA 配置下,每次學生更新及關聯判別器更新耗時從 818.1 秒降至 233.3 秒,實現約 3.51 倍訓練加速。 微信關注回覆“開源”,加入AI開源項目交流羣 如何使用DMAD 克隆倉庫:git clone https://github.com/Yzmblog/DMAD.git 並進入項目目錄。 創建環境:用 conda 創建 Python 3.12 環境並激活。 安裝依賴:按官方固定版本安裝 PyTorch 2.11.0(cu126)、torchvision、torchaudio,再執行 pip install -r requirements.txt 和 pip install -U modelscope-hub。 準備硬件:確保有支持 CUDA 的 NVIDIA 顯卡,並預留約 64GB 系統內存與 170GB 磁盤空間。 下載基礎模型:通過 modelscope download MiniMax/MiniMax-H3 下載 MiniMax-H3 基礎模型。 下載蒸餾權重:從魔搭下載 DMAD 的 4 步 LoRA。 命令行推理:運行 inference.py,指定模型路徑、LoRA、提示詞文件、--steps 4、--height 768 --width 1344,按顯存選擇 --low-vram 8或 --low-vram 12。 查看輸出:輸出目錄包含 0000.mp4、提示詞 txt 和 settings.json,跑通後可替換爲自己的提示詞文件。 DMAD的核心優勢 推理大幅提速:將 50 步教師模型蒸餾爲 4 步學生模型,去噪迭代減少 92% 以上,同時保持接近教師的生成質量。 訓練效率更高:判別器直接學習分佈差異,省去輔助擴散模型,4 卡 H200 上訓練更新加速約 3.51 倍。 生成質量領先:ImageNet-64 一步生成 FID 達 1.04,優於 DMD2、SiDA 等方法;人類評估中對 DMD2 總體偏好率 79.1%、對 rCM 達 84.6%。 覆蓋多模態全場景:同一框架統一支持圖像、文生視頻和聯合音視頻生成。 DMAD的項目地址 項目官網:https://yzmblog.github.io/projects/DMAD/ GitHub倉庫:https://github.com/Yzmblog/DMAD Huggin
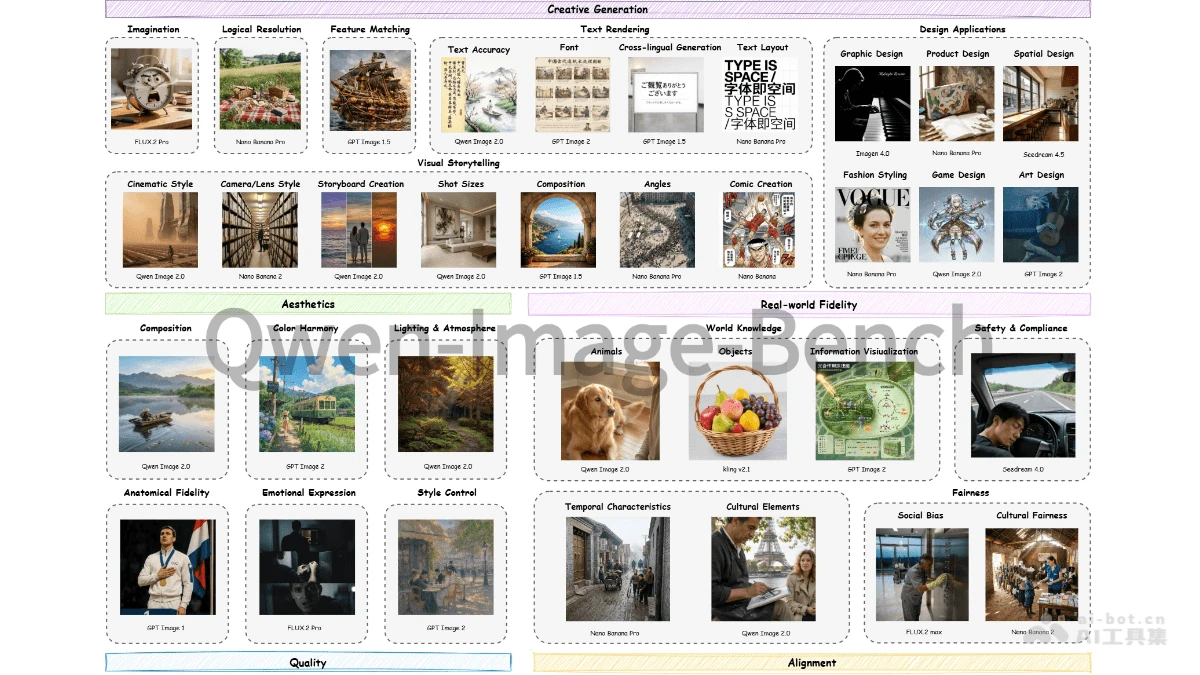
Qwen-Image-Bench – 通義千問推出的文生圖模型評測基準
Qwen-Image-Bench是什麼 Qwen...
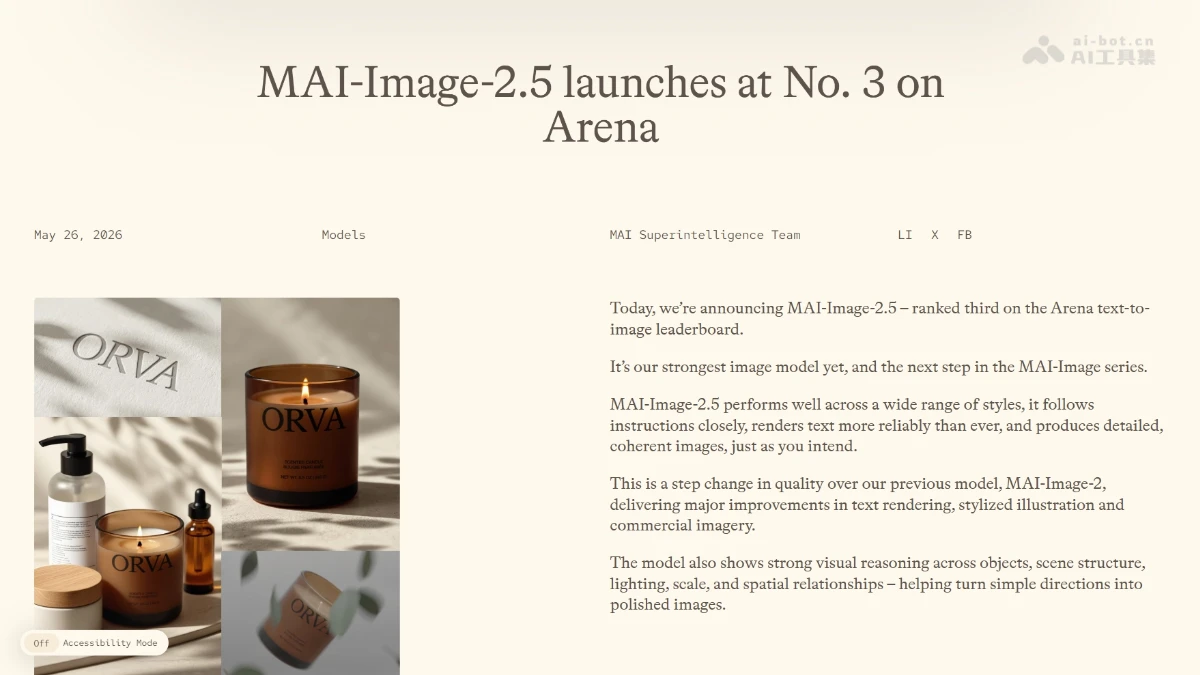
MAI-Image-2.5 – 微軟推出的旗艦級文生圖模型
MAI-Image-2.5是什麼 MAI-Ima...
MAI-Image-2-Efficient – 微軟推出的輕量版文生圖模型
MAI-Image-2-Efficient是什麼...
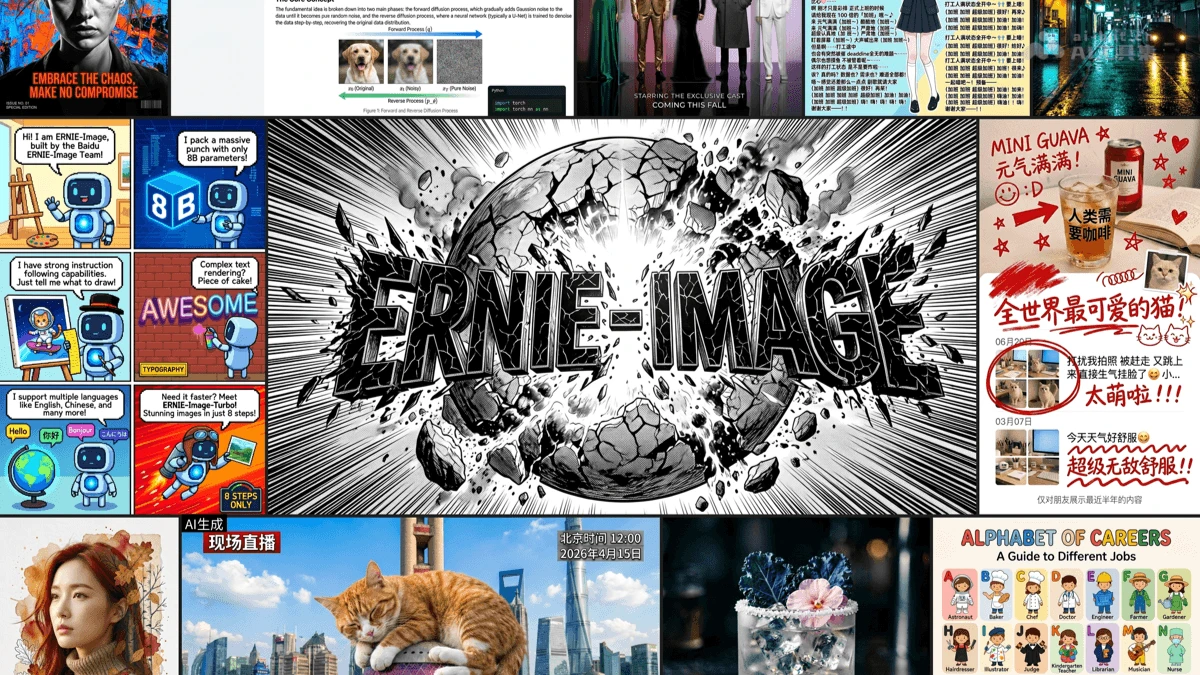
ERNIE-Image – 百度文心開源的文生圖模型
ERNIE-Image是什麼 ERNIE-Ima...
MAI-Image-2 – 微軟推出的文生圖模型
MAI-Image-2 是什麼 MAI-Imag...
Ideogram 2a – Ideogram 最新推出的文生圖模型
Ideogram 2a是什麼 Ideogram 2a 是 AI 圖像生成公司 Ideogram 最新發布的文生圖模型,模型在 Ideogram 2.0 的基礎上進行了優化,主打高效性和實用性,生成速度顯著提升,成本降低了一半。在圖形設計和攝影方面表現卓越,支持高質量的文本渲染,在英文排版上幾乎媲美專業人類設計師。 Ideogram 2a的主要功能 高效生成:通過 Turbo 加速模式,圖像生成時間可壓縮至 5 秒,相比常規模式提速 100%,顯著提升了創作效率。 成本優化:生成成本降低 50%,爲企業級批量應用提供了更具性價比的選擇。 高質量文本渲染:在文本渲染的準確性和創意圖像生成方面表現出色,尤其在英文字體排版上幾乎媲美專業人類設計師。 多風格支持:提供多種藝術風格選擇,包括寫實、設計、3D 和動漫等,滿足不同場景需求。 支持中文提示:能準確理解中文提示詞,生成符合要求的圖像。 圖像重構與改圖:支持對上傳圖片進行風格轉換、重構或再創作,幫助用戶在現有作品基礎上創造新效果。 Ideogram 2a的項目地址 訪問官網:訪問 Ideogram 2a 的官方網站。 註冊與登錄:用戶可以通過賬號登錄,免費版賬號可體驗基礎功能。 輸入提示詞:在文本提示框中輸入描述圖像的文本,支持中文或英文。如果不確定如何寫提示詞,可以開啓 Magic Prompt 功能,系統會自動優化提示詞並翻譯成英文。 設置參數 選擇風格:可選擇寫實、設計、3D、動漫等風格。 設置圖片比例:選擇寬高比,部分自定義比例需要付費。 渲染模式:可選擇快速(約 5 秒)、默認(約 12 秒)或高質量(約 20 秒)。 其他選項:設置是否公開到社區、選擇模型版本(推薦使用默認的 2.0 模型)。 生成圖像:點擊生成按鈕,等待圖像生成。如果對結果不滿意,可以調整參數或重新生成。 查看與下載:生成的圖像可以查看並下載到本地。點擊“My images”可查看歷史生成的圖片。 Ideogram 2a的應用場景 平面設計:Ideogram 2a 可用於快速生成海報、廣告、賀卡、插圖等設計素材。 數字營銷:在數字營銷領域,Ideogram 2a 能爲電子郵件活動、網絡橫幅廣告或社交媒體內容生成高質量的視覺素材。 攝影與視覺藝術:Ideogram 2a 優化了攝影風格的圖像生成,能生成具有專業攝影質量的圖像。 藝術創作:對於藝術家和創作者,Ideogram 2a 提供了強大的工具來探索新的藝術風格和創意表達。用戶可以生成包含文本元素的數字藝術作品,突破傳統與數字藝術的界限。
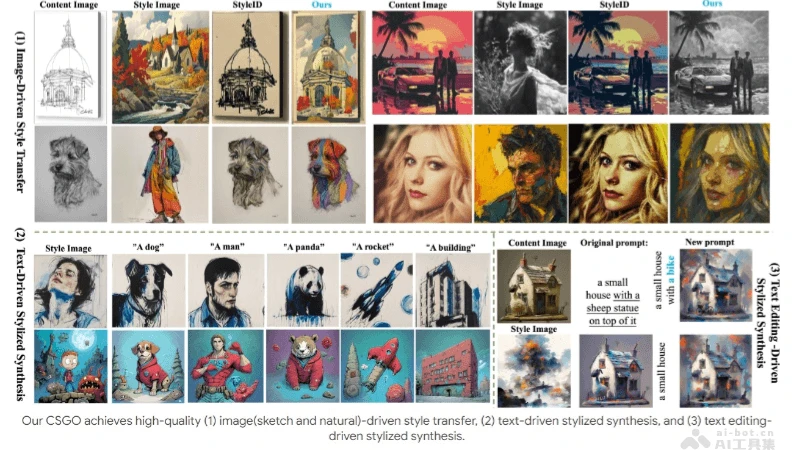
CSGO AI – 小紅書聯合南理工推出的AI文生圖項目
CSGO是什麼 CSGO(Content-St...
CogView-3-Plus – 智譜AI最新推出的AI文生圖模型,媲美 MJ-V6 和 FLUX
CogView-3-Plus是什麼 CogVie...
AuraFlow – Fal團隊推出的開源AI文生圖模型
AuraFlow v0.1是什麼 AuraFlo...
Stability AI開源Stable Diffusion 3 Medium文生圖模型
6月12日晚間消息,人工智能初...
混元DiT - 騰訊混元開源的文生圖擴散模型Hunyuan-DiT
混元DiT是什麼 混元DiT(Huny...
PixArt-Σ - 華爲推出的可生成4K高清圖像的文生圖模型
PixArt-Σ是什麼 PixArt-Σ是由...
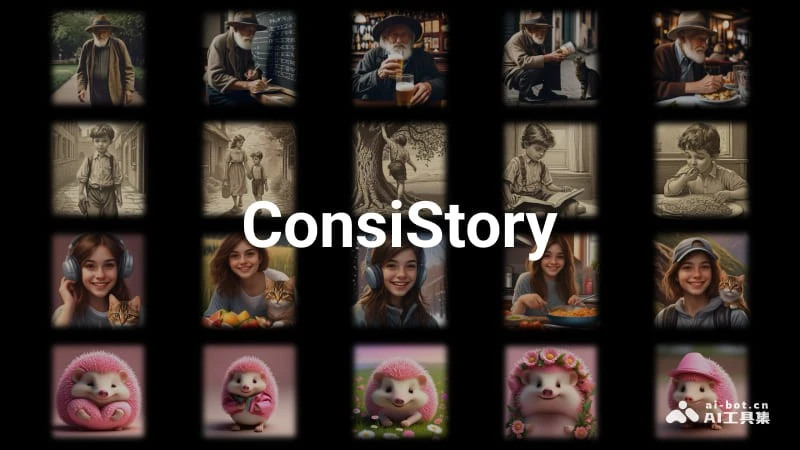
ConsiStory - 免訓練實現主題一致性的文生圖方法
ConsiStory是什麼 ConsiStory...
AnimateDiff - 擴展文生圖模型生成動畫的框架
AnimateDiff是什麼? Animate...