最好用的AI工具
搜尋:大語言模型
25 個結果
Grok Voice 3.0 – SpaceXSI 推出的端到端語音轉語音模型
Grok Voice 3.0是什麼 Grok Voice 3.0 是 SpaceXSI 推出的端到端語音轉語音模型,在獨立測試機構 Artificial Analysis 的語音綜合榜單以 86.9 分居首,響應延遲低於 1 秒,單次任務運行成本約 0.025 美元,低於同級別競品。目前每天支撐特斯拉車內數百萬次對話,星鏈客服中心依託模型日處理 2 萬通多語言來電,約七成無需人工介入可解決。 Grok Voice 3.0的主要功能 端到端語音對話:支持語音輸入直接生成語音輸出,無需文字中轉,實現自然流暢的實時人機對話。 全雙工交互:可智能處理停頓、對話輪替和插話,用戶隨時打斷,模型響應自然不僵硬。 複雜任務執行:依託 Connectors 和 Grok Bot,可完成查日程、回郵件、下單咖啡、預訂晚餐等免動手操作。 企業客服能力:單個智能體即可完成客戶身份覈驗、硬件故障排查、發放退款和補發設備全流程服務。 多語言支持:星鏈客服中心每天以多種語言承接約 2 萬通客戶來電。 Grok Voice 3.0的技術原理 端到端語音轉語音架構:傳統語音助手採用”語音識別→文本理解→文本生成→語音合成”的多模塊級聯方案,信息逐級損耗且延遲疊加。Grok Voice 3.0 採用語音到語音的直接建模,音頻信號進入模型後不經文本中間表示,直接輸出語音回覆,減少級聯誤差,是其首響延遲壓至 1 秒以內的結構基礎。 全雙工對話建模:模型能同時處理收聽與生成:通過流式編碼器持續捕捉用戶音頻流,結合對停頓、語氣詞和插話行爲的判別,動態決定何時續說、何時讓步,在 Full Duplex Bench 上取得 97% 的成績,是其車載免喚醒、可打斷交互體驗的核心支撐。 語音推理與智能體能力融合:模型將聽覺理解與大語言模型的推理規劃能力耦合,用戶語音被解析爲任務意圖後,由內置的智能體框架調用日程、郵件、下單等外部工具 Connectors 或 Grok Bot 完成任務,把執行結果用自然語音回饋用戶,形成”聽懂—規劃—執行—回覆”的閉環,是其客服場景能獨立完成退款、補發等操作的原因。 如何使用Grok Voice 3.0 普通用戶:在 Grok 應用、Grok Bot 或特斯拉車內直接開啓語音模式可對話,grok-voice-latest 用戶已自動升級無需操作。 開發者:註冊 API Console 獲取密鑰後,按官方文檔調用 Voice Agent API 接入應用。 Grok Voice 3.0的核心優勢 綜合智能第一:以 86.9 分登頂 Artificial Analysis 語音轉語音綜合榜,在語音推理、任務完成率和人類偏好上全面領先競品。 延遲行業領先:響應延遲低於 1 秒,比同級別 GPT-Live-1 低 40%,實現智能與速度的最優平衡。 運行成本更低:單次任務成本約 0.025 美元,低於 GPT-Live-1 和 GPT-Realtime-2.1,且 API 定價與上代持平不漲。 全雙工交互自然:Full Duplex Bench 拿下 97%,對停頓、輪替和插話的處理接近真人對話體驗。 企業場景驗證充分:EVA-Bench 以 74% 精度居首,星鏈實測日接 2 萬通電話、70% 無需人工、四分之一銷售通話直接成交。 Grok Voice 3.0的項目地址 項目官網:https://x.ai/news/grok-voice-3 Grok Voice 3.0的同類競品對比 對比維度 Grok Voice 3.0 Gemini 3.8 Live AA 語音綜合指數 86.9(第 1 名) 82.6 語音推理(Big Bench Audio) 98.5% 97.7% 人類偏好(Arena Elo) 1070 990 任務完成率 94.8% 89.1% 全雙工(Full Duplex Bench) 97.0% 91.9% τ-Voice 客服場景 71.6% 68.6% 單次任務成本 $0.025 更高(未列具體值) EVA-Bench 企業客服精度 74%(最高) 未領先 Grok Voice 3.0的應用場景 智能車載語音助手(特斯拉):駕駛員全程免動手,通過 Connectors 查詢日程、回覆郵件,或用 Grok Bot 完成下單咖啡、預訂晚餐等複雜任務,目前每天處理數百萬次車內對話。 企業客服中心(星鏈):星鏈客服依託 Grok Voice 每天多語言接聽約 2 萬通來電,約 70% 無需人工介入即可解決,單個智能體可獨立完成身份覈驗、故障排查、退款和設備補發。 電話銷售轉化:約四分之一的銷售通話在客戶掛斷前即促成下
Beam – Reflection AI 開源的首款大語言模型
Beam是什麼 Beam 是 Reflection AI 推出的首款開源大語言模型,採用 501B 參數的稀疏 MoE 架構,每 token 僅激活 23B,支持 100 萬 token 上下文,預訓練消耗 23.8T token。Beam 的訓練過程堪稱重工業級別的算力展示,預訓練用 6,144 張 GB300 不到四周跑完,用 10,500 張 GB300 進行爲期四周、超 1 億次 rollout 的大規模強化學習。 Beam的主要功能 編程開發:在軟件工程任務上達到 GLM-5.2 同級水平,是面向企業編碼負載的主力模型。 Agent 執行:具備工具調用、終端操作、網頁搜索等能力,可自主完成多步任務,甚至學會調用其他大模型和 OCR API。 長文本處理:支持 100 萬 token 上下文,能從超長代碼庫和文檔中定位並關聯關鍵信息。 可調推理強度:用戶通過 reasoning effort 參數在短回覆與長推理之間靈活切換,匹配不同任務和算力預算。 Beam的技術原理 稀疏 MoE 架構:模型總參數 501B,但每次只激活 23B,通過細粒度路由專家配合輔助損失無關的負載均衡實現近均勻的專家利用率,最忙專家負載僅 1.04×,是 Beam 推理高效的硬件級基礎。 兩階段大規模訓練:預訓練在 6,144 張 GB300 上用不到四周消化 23.8T token,配合拓撲感知調度器和靜默數據損壞檢測,goodput 達 92.3%;之後用 10.5K 張 GB300 做四周強化學習,產生超 1 億次 rollout,期間平均維持 11 萬併發 rollout 和 17 萬併發沙盒。 全異步 RL 系統:採用異步 policy gradients,支持 rollout 與訓練並行,通過給每個 token 標記生成它的模型版本處理策略陳舊問題,即使樣本落後當前策略一天(107 個版本)數值依然穩定;新權重經 RoCE 分層分發到推理集羣僅需中位數 12 秒。 長度可控的推理學習:在 RL 中加入長度懲罰項,讓模型先學會用更少 token 解題、再在 agentic 能力增強後自然擴展推理長度,形成能力-token 消耗的最優權衡,由用戶按需調節。 微信關注回覆“開源”,加入AI開源項目交流羣 如何使用Beam 當前階段權重未放出,僅向部分用戶提供預覽版,訪問 https://platform.reflection.ai/ 可申請早期體驗。 Beam的核心優勢 推理效率極高:用 3–4 倍低於 GLM-5.2 的推理算力達到同級推理水平,比 Qwen 3.8-Max 等 2T+ 模型節省更多,智能密度突出。 激活參數極小:501B 總參中每 token 僅激活 23B,稀疏 MoE 設計大幅壓低部署和推理成本。 RL 規模業界罕見:10.5K 張 GB300 連續四周、超 1 億次 rollout,是開放實驗室中迄今最大規模的 RL 訓練之一。 訓練穩定性強:預訓練全程僅 9 次半自動回滾、goodput 達 92.3%,訓練曲線無失穩,工程成熟度極高。 推理長度可控:用戶可通過 reasoning effort 參數自由調節推理深度,在性能與成本間按需權衡。 Beam的項目地址 項目官網:https://reflection.ai/blog/introducing-beam Beam的同類競品對比 維度 Beam(Reflection AI) GLM-5.2(Z.ai / 智譜) 總參數 / 激活參數 501B / 23B 744B / 40B 激活佔比 約 4.6%(更稀疏) 約 5.4% 上下文窗口 1M tokens 1M tokens 預訓練數據量 23.8T tokens 28.5T tokens 架構特點 細粒度 MoE + 輔助損失無關負載均衡,52 層殘差流全程穩定 MoE + MLA + 稀疏注意力(DSA/IndexShare),78 層(前 3 層稠密) 後訓練 10.5K 張 GB300 跑 4 周 RL,超 1 億次 rollout,異步 policy gradients slime 異步 RL 基礎設施,長程 agentic 訓練 能力定位 對標 GLM-5.2,官方承認落後 Kimi K3,優勢在推理效率 開源模型推理/編程最強檔,GPQA Diamond 89%,SWE-bench Pro 62.1% 推理效率 達到同級推理水平僅用 GLM-5.2 約 1/3–1/4 算力 基準參照物,40B 激活已屬高效 許可協議 Apache 2.0 MIT 開源權重(已可下載) 當前可用性 wait
Muse Glimmer – Meta 開源的 300 億參數大語言模型
Muse Glimmer是什麼 Muse Gli...
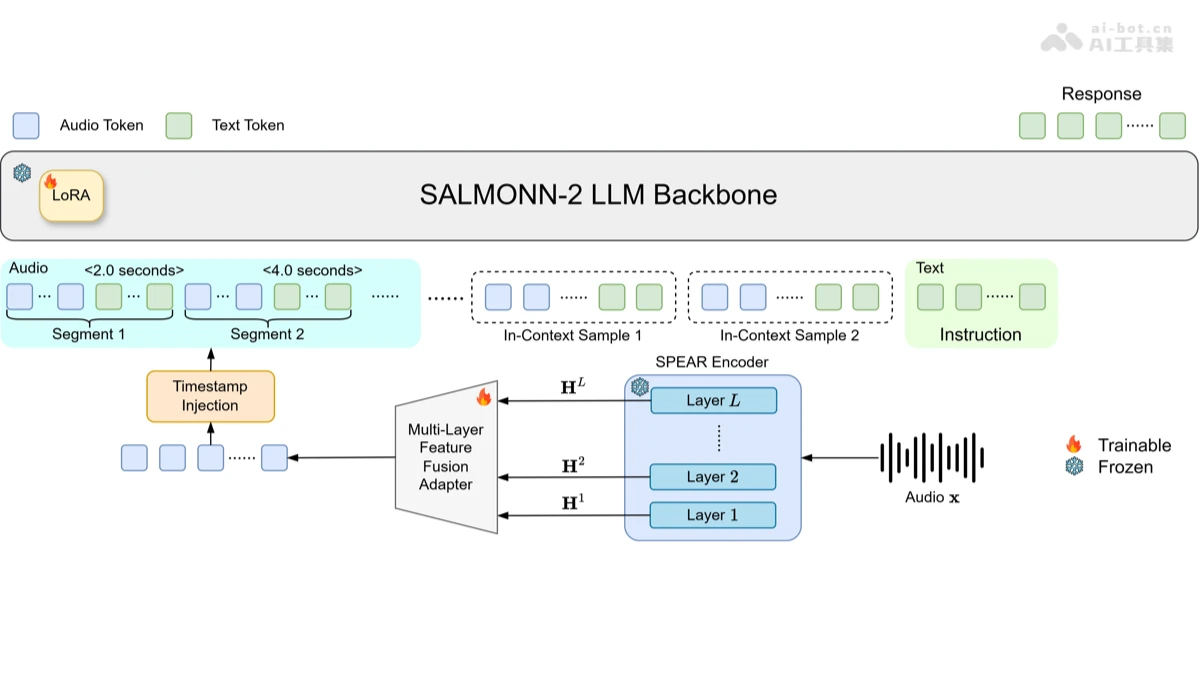
SALMONN-2 – 清華等開源的通用音頻大語言模型
SALMONN-2是什麼 SALMONN-2 ...
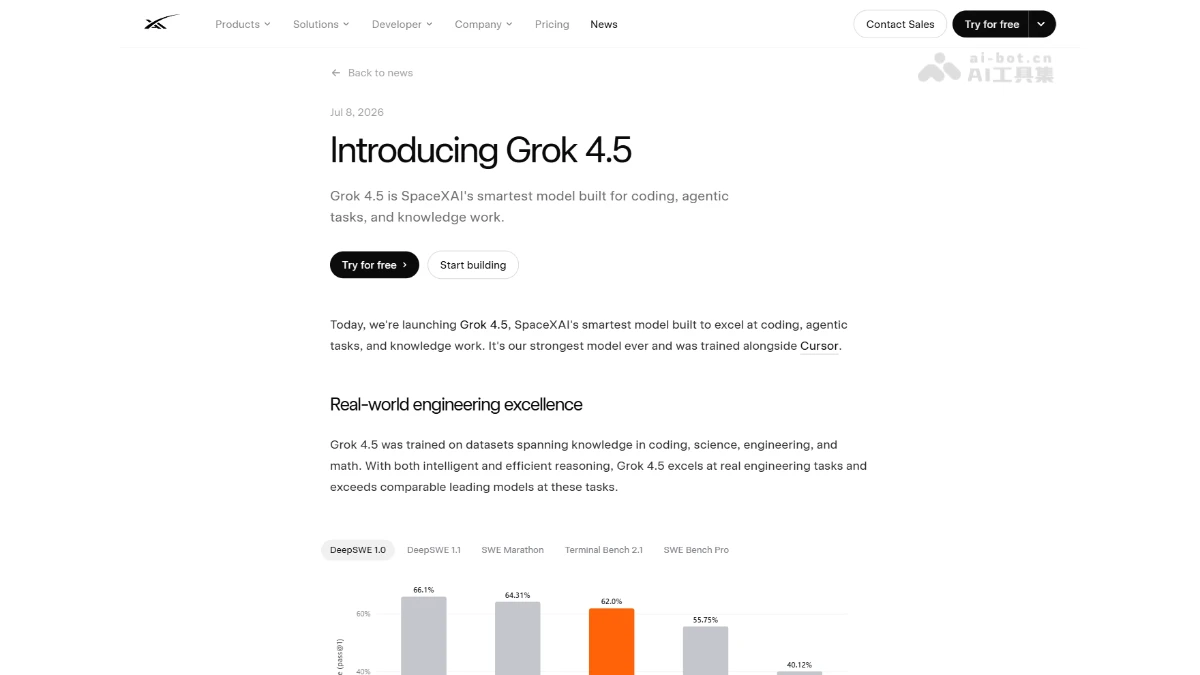
Grok 4.5 – SpaceXAI推出的新一代旗艦大語言模型
Grok 4.5是什麼 Grok 4.5是Sp...
Claude Opus 4.8 – Anthropic 推出的旗艦級大語言模型
Claude Opus 4.8是什麼 Claud...
星火X2-Flash – 科大訊飛推出的MoE架構大語言模型
星火X2-Flash是什麼 星火X2-F...
DeepSeek-V4 – DeepSeek推出的新一代大語言模型系列
DeepSeek-V4是什麼 DeepSeek-...
Elephant – 螞蟻Inclusion AI團隊推出的大語言模型
Elephant是什麼 Elephant(大...
什麼是大語言模型?一文看懂
大語言模型(LLM)是一種通過...
LaWGPT – 南京大學推出的中文法律大語言模型
LaWGPT是什麼 LaWGPT 是南京...
unsloth – 開源的大語言模型微調工具
unsloth是什麼 unsloth 是開...
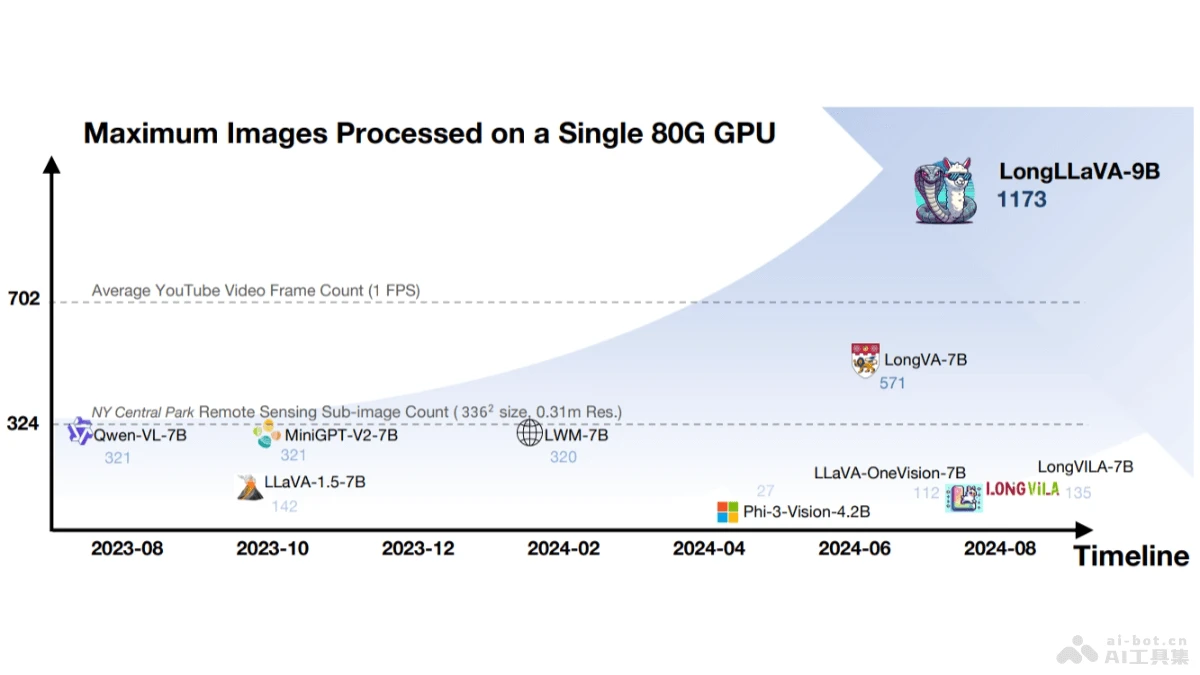
LongLLaVA – 香港中文大學推出的多模態上下文混合架構大語言模型
LongLLaVA是什麼 LongLLaVA是...
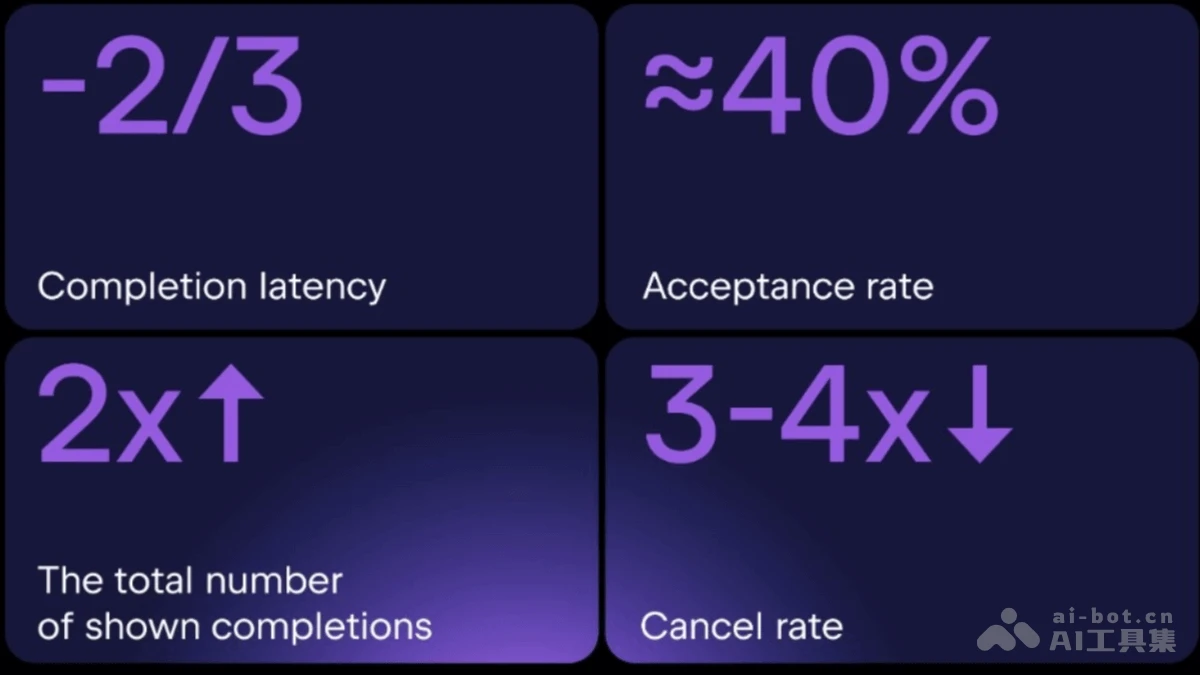
Mellum – JetBrains 推出專爲開發者設計的大語言模型
Mellum是什麼 Mellum 是 JetB...
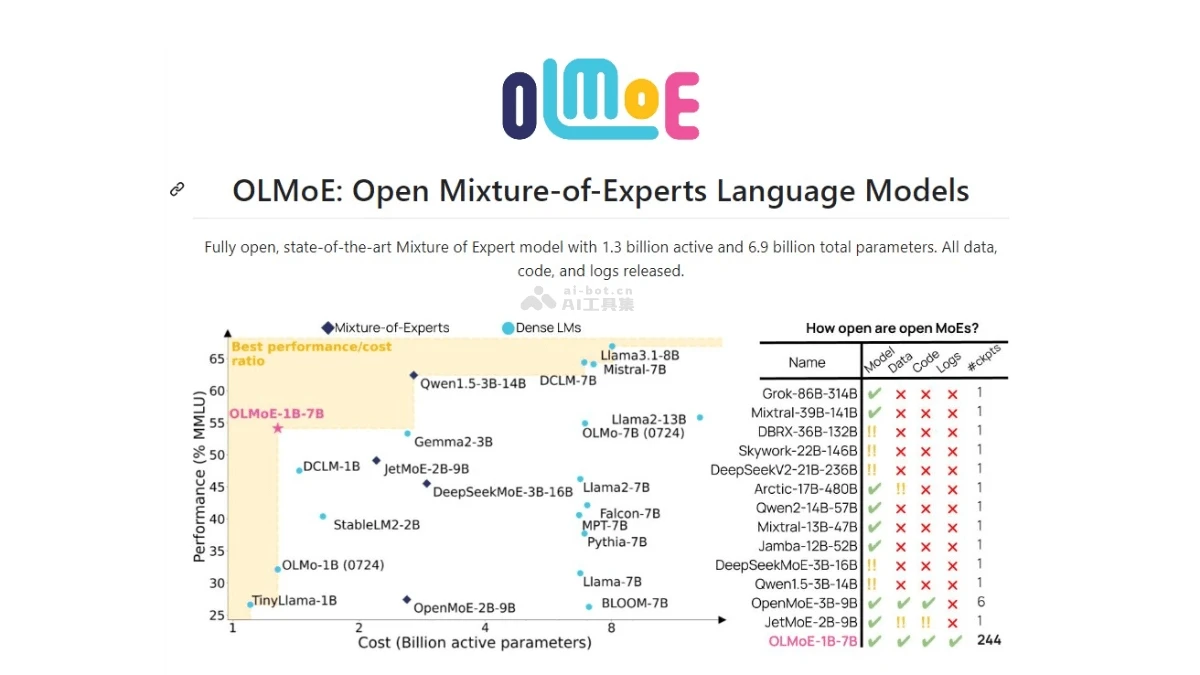
OLMoE – 完全開源的大語言模型,基於混合專家(MoE)架構
OLMoE是什麼 OLMoE(Open Mix...
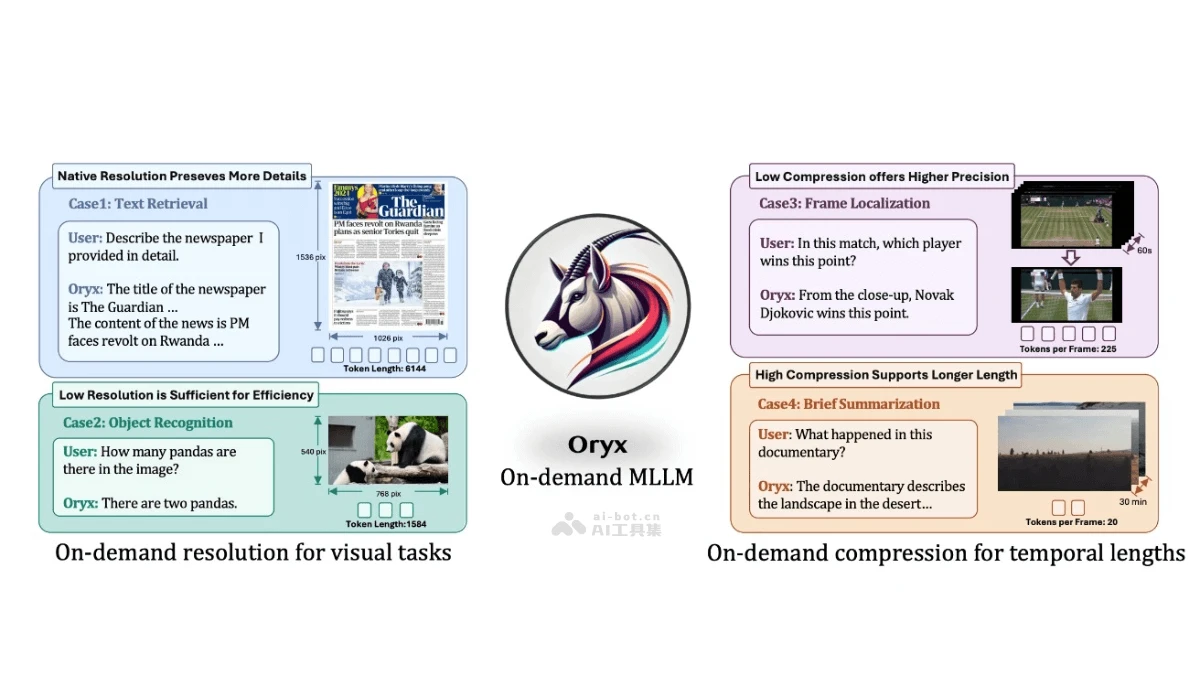
Oryx – 騰訊聯合清華和南洋理工大學推出的多模態大語言模型
Oryx是什麼 Oryx是由清華大學...
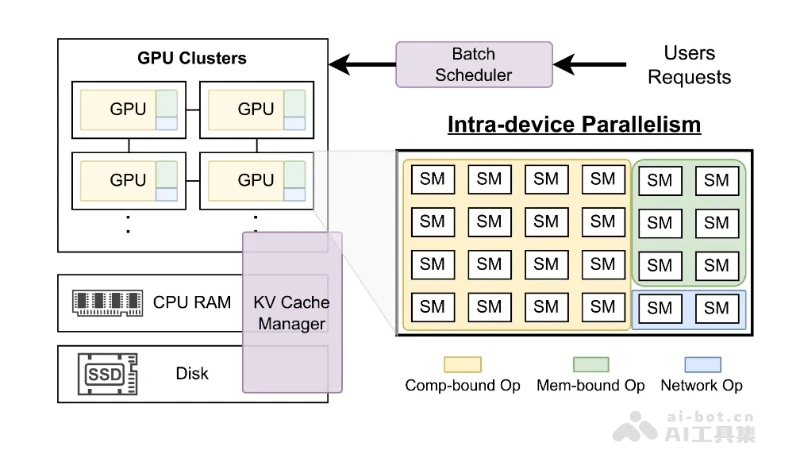
NanoFlow – 優化大語言模型推理吞吐量的服務框架
NanoFlow是什麼 NanoFlow 是...
Mem0 – 一款開源的大語言模型記憶增強工具
Mem0 是什麼 Mem0 是一款開源...
Llama 3 – Meta開源推出的新一代大語言模型
Llama 3是什麼 Llama 3是Meta...

Llama 3 - Meta開源推出的新一代大語言模型
Llama 3是什麼 Llama 3是Meta...