最好用的AI工具
搜尋:口型同步
3 個結果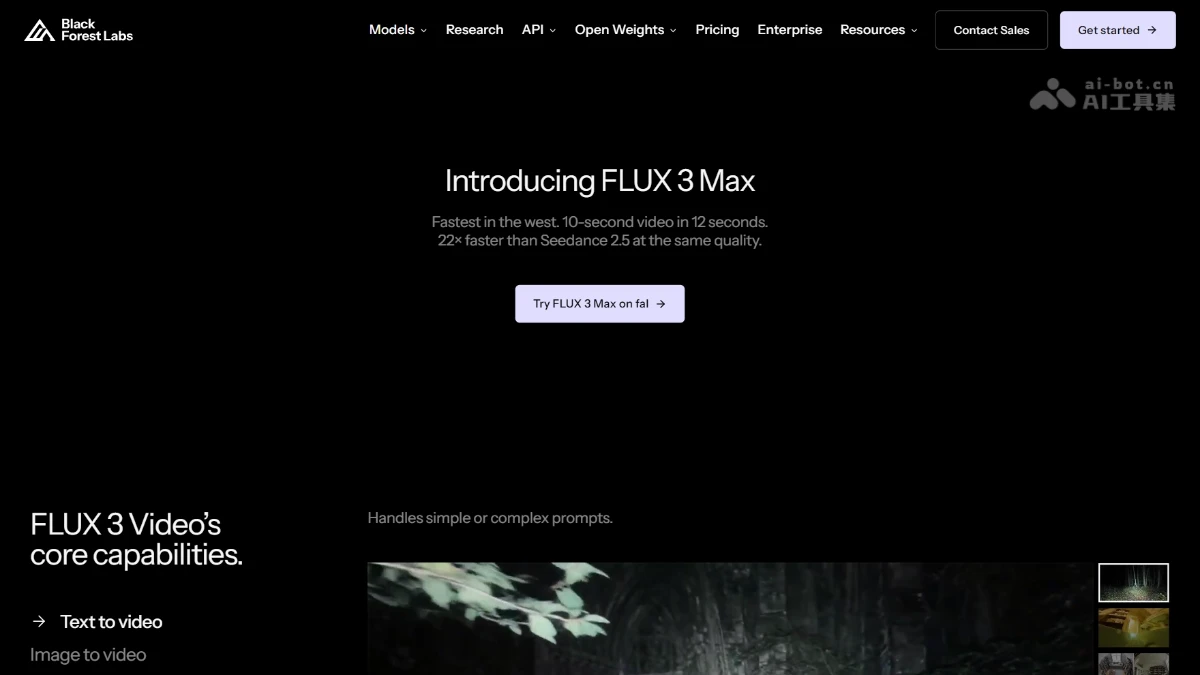
FLUX 3 Max – fal 與 Black Forest Labs 推出的視頻生成模型
FLUX 3 Max是什麼 FLUX 3 Max 是 fal Research 與 Black Forest Labs 聯合推出的後訓練視頻模型,支持文生視頻、圖生視頻與關鍵幀插值,可生成5–20秒、720p/1080p、帶原生音頻的視頻。FLUX 3 Max 主打極致速度,10秒成片約12秒生成,官方稱同畫質下比 Seedance 2.5 快22倍。 FLUX 3 Max的主要功能 文生視頻:一句話提示詞可生成 5–20 秒的完整視頻片段。 圖生視頻:輸入參考圖作爲起始幀,可選指定結束幀,實現首尾幀之間的受控生成。 音畫同步:原生生成配套音頻與人物口型對話,無需後期配音合成。 Draft 草稿模式:極低成本快速出預覽稿,確認後同提示詞一鍵渲染爲全質量成片。 極致速度:10 秒視頻約 12 秒生成,官方稱同畫質下比 Seedance 2.5 快 22 倍。 靈活輸出:720p/1080p 兩檔分辨率,通過 fal 等平台統一 API 調用。 FLUX 3 Max的技術原理 多模態統一底座:FLUX 3 Max 基於 Black Forest Labs 的 FLUX 3 基礎模型,後者將多模態生成與理解整合在同一底層架構中,圖像、視頻、音頻、文本共享一套表示空間,各模態能力互相增強。 Self-Flow 對齊方法:相比傳統 Flow Matching,Self-Flow 在各模態上的生成誤差更低,且經微調後在四組操控任務上的成功率更高,更易被精確控制。 後訓練效率特化:”Max”版本是 fal Research 與 BFL 在 FLUX 3 底座上做的後訓練版本,目標是推理效率:通過蒸餾等手段大幅減少採樣步數與計算開銷,在畫質基本無損的前提下把延遲壓低。 生態化推理部署:經 fal 統一 API 輸出,同時接入 Comfy、OpenRouter、Runware、HeyGen 等 17 家平台,配合 Draft 模式的先草稿後精修工作流,把創作端的試錯成本一併壓低。 如何使用FLUX 3 Max 打開入口:訪問 fal 官網,註冊或登錄賬號,或 Black Forest Labs 官網 https://bfl.ai/。 選擇模式:選文生視頻(純提示詞)、圖生視頻(上傳起始幀圖)或關鍵幀插值(首尾幀)。 輸入素材:文生視頻填寫提示詞,圖生視頻上傳圖片,可選配結束幀控制鏡頭走向。 設置參數:設定時長(5–20 秒)、分辨率(720p/1080p)及是否同步生成音頻。 先試草稿:用 Draft 模式跑一版低成本預覽,確認構圖和動作滿意後再渲染全質量成片。 API 接入:生產環境通過 fal 統一 API 調用(文檔見 fal.ai/docs),可走 Comfy、OpenRouter、Runware 等第三方接入。 FLUX 3 Max的核心優勢 質量第一梯隊:在獨立第三方 Artificial Analysis 圖生視頻榜單上並列第一(Elo 約 1138 分)。 價格最低檔:號稱同質量級別最便宜的前沿視頻模型。 音畫一體:原生同步生成音頻與口型對話,無需後期配音。 Draft 模式省成本:先低成本出預覽稿,確認後再渲染全質量,試錯費用大幅壓縮。 輸入靈活:支持文生視頻、圖生視頻、首尾關鍵幀插值三種工作流。 FLUX 3 Max的項目官網 項目地址:https://bfl.ai/models/flux-3-video#flux-3-max FLUX 3 Max的同類競品對比 對比維度 FLUX 3 Max MiniMax H3 產品定位 前沿模型的速度特化版,主打”最快” 通用音畫生成旗艦,主打”最全” 生成時長 5–20 秒 4–15 秒 分辨率 720p / 1080p 直出 768p 直出,2K 需二次再生 音頻能力 原生音頻 + 人物對話 原生 32kHz 立體聲 + 口型同步 生成速度 10 秒視頻約 12 秒生成 標準隊列速度(快版需選 H3 Max 變體) 榜單表現 圖生視頻並列第一(約 1138 Elo) 圖生視頻約 1140 Elo,略壓一頭 參考輸入 圖片、首尾關鍵幀 多模態參考:最多 9 圖 + 3 視頻 + 3 音頻 開放權重 否,僅 API 是,H3-Base 已上傳 Hugging Face FLUX 3 Max的應用場景 電商與虛擬試穿:上傳商品圖或模特圖生成動態展示視頻,替代傳統拍攝做詳情頁和廣告素材。 廣告與品牌營銷:Logo 動態演繹、產品質感鏡頭一鍵生成,品牌方無需傳統制作週期即可上新 campaign。 影視分鏡與預演:劇本文字直接轉動態分鏡,導演
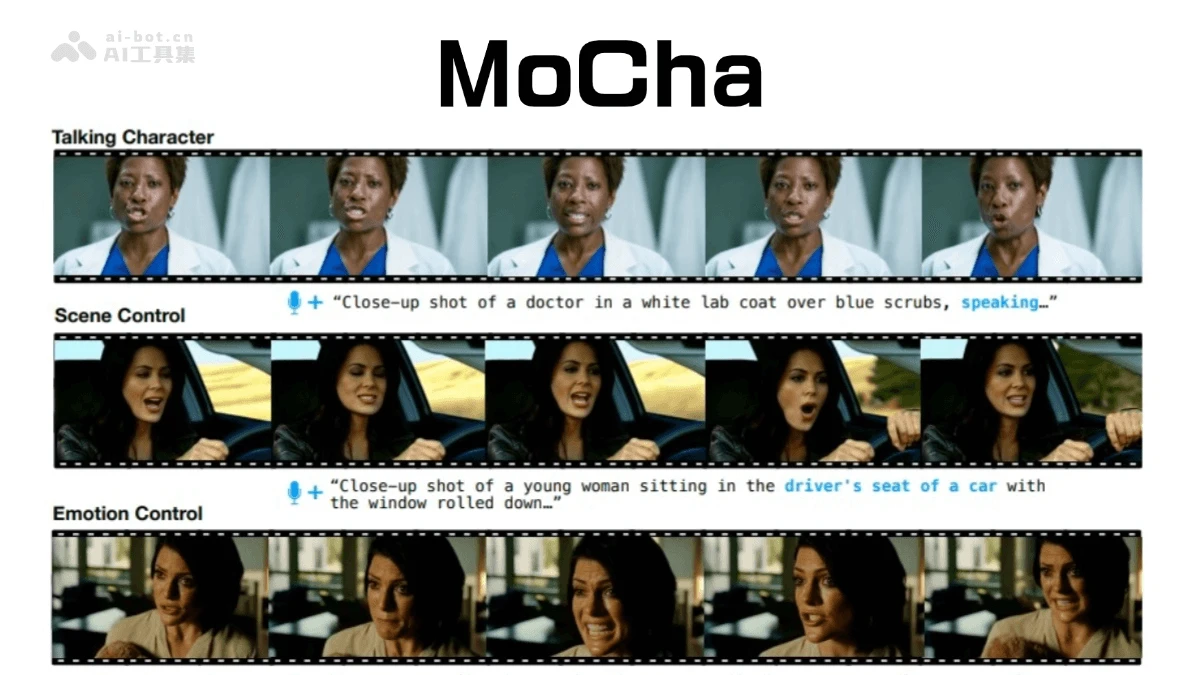
MoCha – Meta 聯合滑鐵盧大學推出的端到端對話角色視頻生成模型
MoCha是什麼 MoCha AI 是 Meta 和滑鐵盧大學聯合開發的端到端對話角色視頻生成模型。能根據文本或語音輸入生成帶有同步語音和自然動作的完整角色動畫。MoCha 採用語音-視頻窗口注意力機制,解決了視頻壓縮時音頻分辨率不匹配以及脣部動作錯位的問題。支持多角色輪換對話,能生成具有情感表達和全身動作的角色動畫。 MoCha的主要功能 語音驅動角色動畫生成:用戶輸入語音,MoCha 可以生成與語音內容同步的角色嘴型、面部表情、手勢及身體動作。 文本驅動角色動畫生成:用戶僅輸入文本腳本,MoCha 會先自動合成語音,再驅動角色進行完整的口型和動作表現。 全身動畫生成:與傳統僅生成面部表情或嘴型的模型不同,MoCha 能生成全身的自然運動,涵蓋嘴脣同步、手勢以及多角色之間的互動。 多角色輪番對話生成:MoCha 提供結構化提示模板與角色標籤,能自動識別對話輪次,實現角色間“你來我往”的自然對話呈現。在多角色場景中,用戶只需定義一次角色信息,可以通過簡單的標籤(如“人物1”“人物2”)在不同的場景中引用這些角色,無需重複描述。 MoCha的技術原理 擴散變壓器(DiT)架構:MoCha 基於擴散變壓器(Diffusion Transformer)架構,通過將文本和語音條件依次通過交叉注意力機制融入模型,有效捕捉語義和時間動態。能生成逼真且富有表現力的全身動作,同時確保角色動畫與輸入語音的精確同步。 語音-視頻窗口注意力機制:爲了解決視頻壓縮和並行生成帶來的語音-視頻對齊問題,MoCha 引入了語音-視頻窗口注意力機制。限制每個視頻標記只能關注與其時間上相鄰的音頻標記,提高口型同步的準確性和語音-視頻對齊效果。模擬了人類語音的運作方式,使角色的口型與對話內容精準匹配。 聯合訓練策略:MoCha 採用了聯合訓練策略,同時基於語音標註和文本標註的視頻數據進行訓練。增強了模型在多樣化角色動作上的泛化能力,通過自然語言提示實現對角色表情、動作、互動和環境的精細控制。 結構化提示模板:爲了簡化多角色對話的文本描述,MoCha 設計了結構化提示模板,通過爲每個角色分配唯一標籤在文本中使用這些標籤來描述角色的動作和互動。減少了冗餘,提高了模型在多角色場景中的生成效果。 多階段訓練框架:MoCha 採用了多階段訓練框架,根據鏡頭類型(如特寫鏡頭、中景鏡頭)對數據進行分類,逐步引入更復雜的任務。確保了模型在不同難度任務上的表現,同時提高了訓練效率。 MoCha的項目地址 項目官網:https://congwei1230.github.io/MoCha/ arXiv技術論文:https://arxiv.org/pdf/2503.23307 MoCha的應用場景 虛擬主播:MoCha 可以自動生成日常 Vlog、角色問答等內容。通過語音或文本輸入,生成與語音內容同步的角色嘴型、面部表情、手勢及身體動作,使虛擬主播更加生動自然。 動畫影視創作:MoCha 支持 AI 自動配音和自動動畫生成,能降低動畫影視創作的製作成本。能生成全身動畫,讓角色動作更加自然,接近電影級數字人演出。 教育內容創作:MoCha 可以作爲 AI 老師角色進行講課或互動。通過文本驅動的方式,生成與教學內容匹配的角色動畫,提高教育內容的趣味性和吸引力。 數字人客服:MoCha 可以用於擬人化企業客服、諮詢角色。通過語音或文本輸入,生成自然流暢的客服對話動畫,提升用戶體驗。
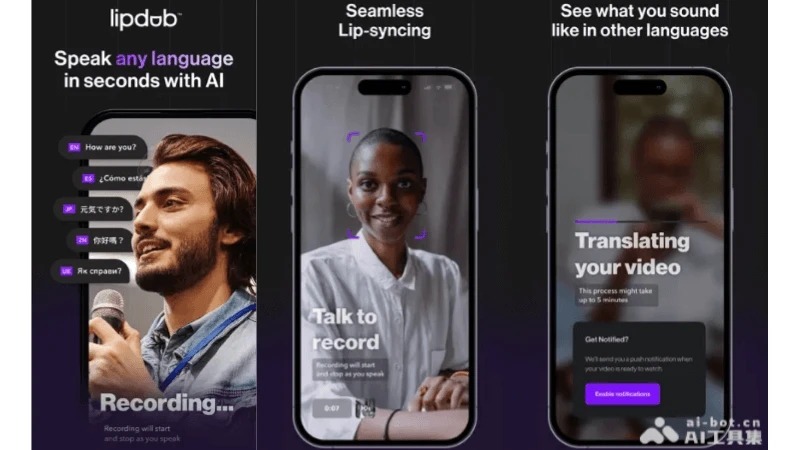
LipDub – 初創公司Captions推出的海外AI配音工具,實時轉換聲音口型同步
LipDub是什麼 Lipdub是Captio...