AI工具
1,760 個結果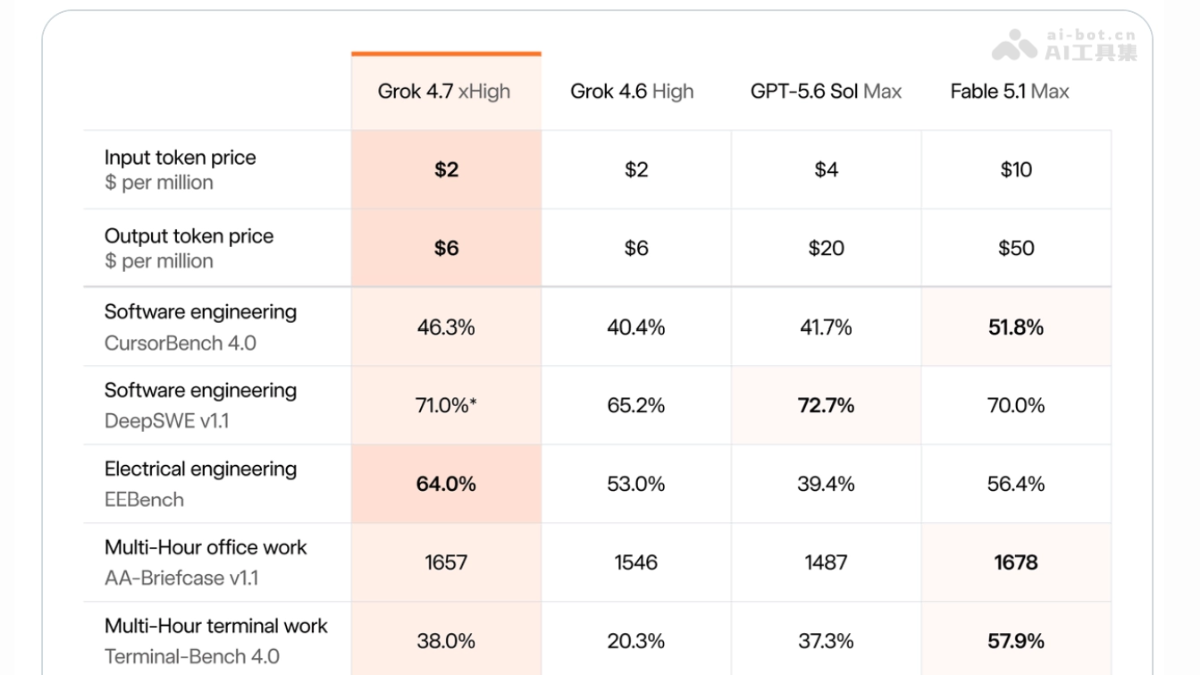
Grok 4.7 – SpaceXAI 推出的最新旗艦大模型
Grok 4.7是什麼 Grok 4.7 是 ...
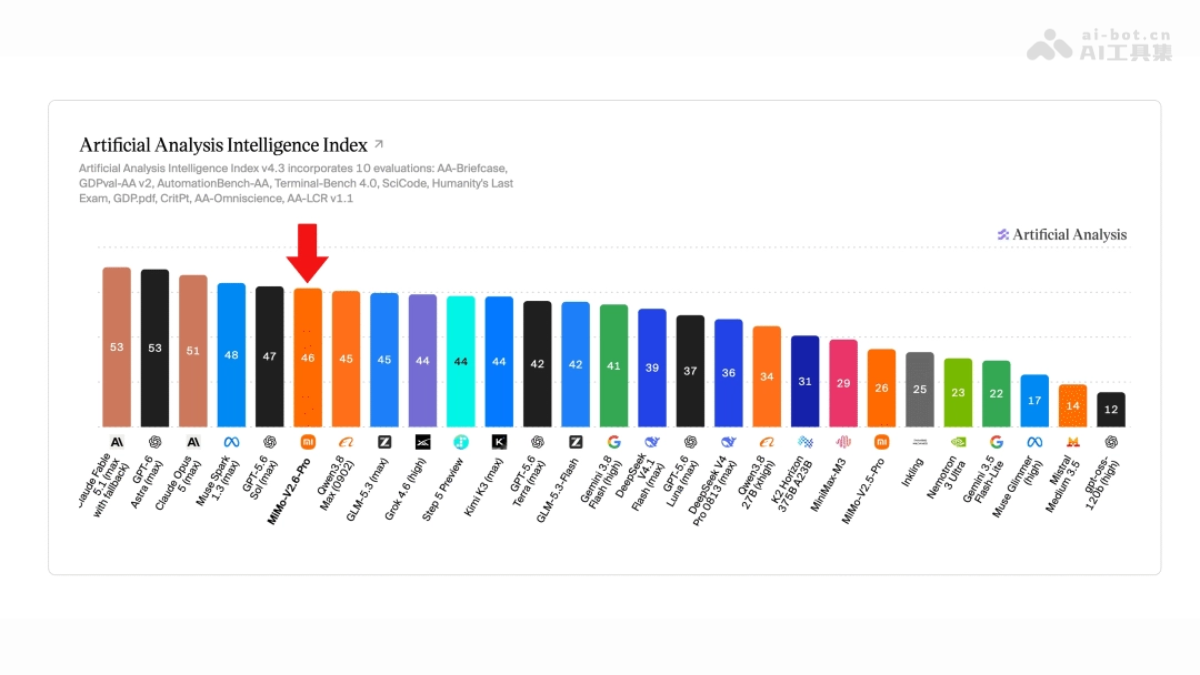
Xiaomi MiMo-V2.6 – 小米開源的全模態模型系列
Xiaomi MiMo-V2.6是什麼 Xiao...
Kimi Code Desktop – Kimi 推出的 Kimi Code 桌面客戶端
Kimi Code Desktop是什麼 Kim...
混元智囊團 – 騰訊推出面向外部行業人才的專家平台
混元智囊團是什麼 混元智囊團...
Jev Search – 開源 AI 搜索引擎,調用 Jev 模型自動分析
Jev Search是什麼 Jev Search...
剪映Hub – 剪映推出的一站式 AI 視頻創作入口
剪映Hub是什麼 剪映Hub是剪映...
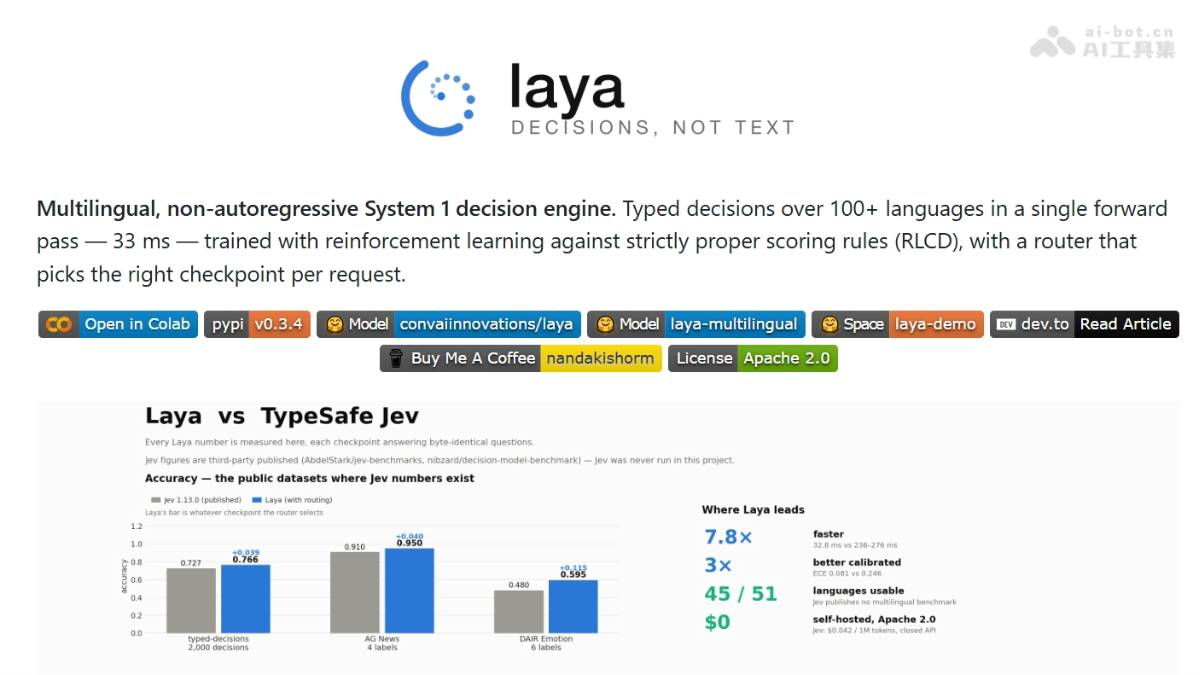
Laya – 開源的非自迴歸 AI 決策模型,Jev 開源平替
Laya是什麼 Laya 是開源的非...
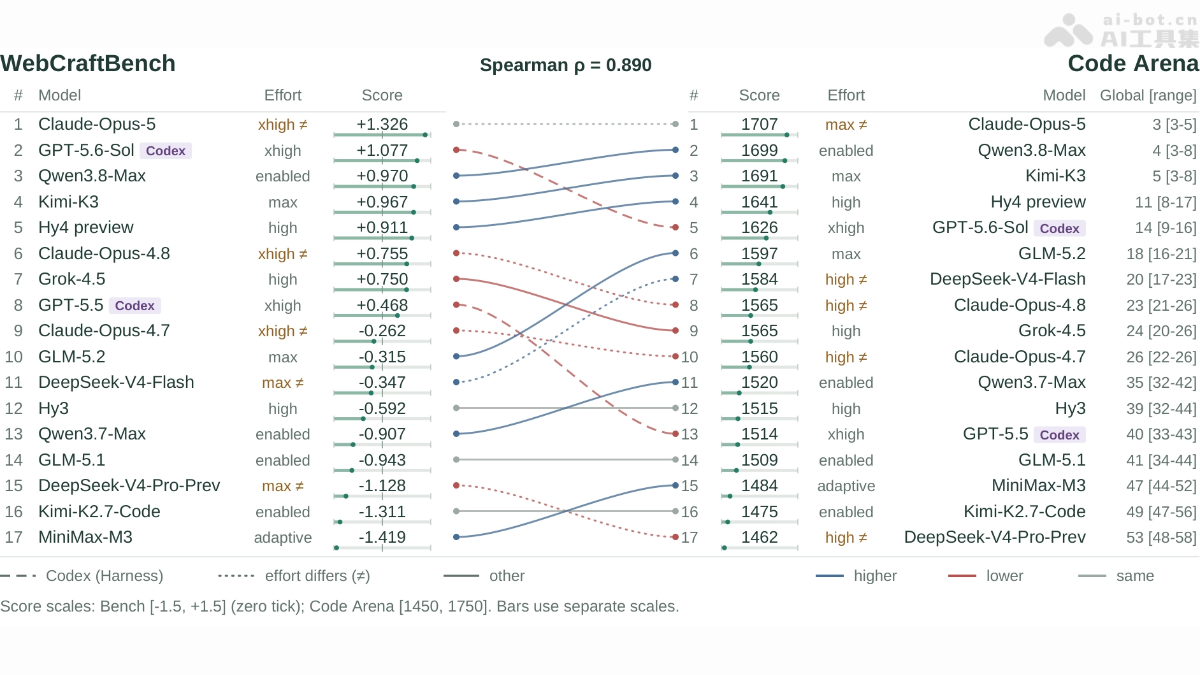
WebCraftBench – 騰訊聯合清華推出的AI網頁生成評測基準
WebCraftBench是什麼 WebCraftBench 是騰訊混元聯合清華、北大推出的 AI 網頁生成評測基準。WebCraftBench先給生成應用自動插樁,讓智能體通過 Playwright 實際操作網頁探索功能,用代碼覆蓋率引導查漏;再將交互記錄抽象成狀態圖,從美觀度、易用性、需求符合度三個維度分別打分。基準含 369 條真實需求、5,088 條人工覈驗的驗收標準,覆蓋 17 個前沿模型的 6,273 個應用,與人類偏好一致率達 85.3%。 WebCraftBench的主要功能 真實需求評測集:包含 369 條來自真實使用流量的用戶需求,配 5,088 條經人工覈驗的驗收標準,覆蓋功能、內容、視覺三類要求。 交互式自動探索:智能體通過 Playwright MCP 像測試人員一樣點擊、輸入、切換頁面,主動發現功能並測試邊界情況。 代碼覆蓋率引導:基於 Istanbul 自動插樁,實時監測覆蓋率,發現探索不足時由輔助模型提示未觸達的代碼方向。 狀態抽象與整理:將冗長的操作記錄去重、規範化,合併爲狀態轉移圖,提煉關鍵運行證據供評分使用。 三維獨立評分:分別評估美觀度、易用性、需求符合度,合成標準化綜合分。 人類偏好驗證:在獨立驗證集上與經複覈的人工投票對比,成對判斷一致率達 85.3%,驗證評測可靠性。 WebCraftBench的技術原理 自動插樁收集運行證據:系統在應用代碼中注入計數器,支持靜態 HTML、Vite、Next、CRA、Astro 等框架。應用啓動後,每次交互都會回傳代碼覆蓋率及增量,讓”哪些代碼被執行過”變得可觀測。 覆蓋率引導的智能體探索:探索智能體不看不源碼、不看驗收清單,按 GUI 測試流程操作網頁。當連續三次交互沒有帶來新增覆蓋時,系統請另一個模型分析尚未執行的代碼,將建議轉成自然語言交給探索智能體繼續嘗試。 狀態抽象壓縮交互軌跡 對頁面結構做規範化處理,相同頁面合併爲同一狀態,操作連接爲狀態轉移圖。避免重複截圖擠佔評分模型的上下文,讓故障路徑一目瞭然。 探索與評分分離的多維打分:探索階段收集證據時不看驗收清單,評分階段才逐條對照標準檢索證據。美觀度和易用性採用”找優點—挑缺陷—裁判定分”的三輪評議(;需求符合度每條判斷必須引用運行證據,按滿足比例計分。三個維度各佔綜合分三分之一。 如何使用WebCraftBench 準備生成應用:讓被評測的模型根據需求生成網頁應用,部署爲可運行狀態。 自動插樁:運行 WebCraftBench 的插樁工具,在應用代碼中注入覆蓋率計數器,使每次交互都能回傳代碼執行信息。 交互探索:啓動探索智能體,通過 Playwright MCP 操作網頁,執行點擊、輸入、切換頁面等動作,主動發現功能並測試邊界情況。 覆蓋率引導查漏:當連續三次交互無新增覆蓋時,系統由輔助模型分析未執行代碼,生成自然語言建議交給探索智能體繼續探索(最多 100 步)。 整理運行證據:系統自動對頁面結構做狀態抽象,將操作記錄去重合併爲狀態轉移圖,保留截圖與交互軌跡。 三維評分:評分智能體分別評估美觀度、易用性,逐條對照驗收標準檢查需求符合度,每條判斷須引用運行證據。 輸出結果:獲得三個維度的標準化分數及綜合總分,可與模型池排名對比,分差越大結果越可信。 WebCraftBench的核心優勢 實測導向:讓智能體真實操作網頁打分,而非只看代碼或截圖,能發現”入口按鈕壞了、首頁打不開”這類靜態評測漏掉的問題。 覆蓋率引導探索:用代碼覆蓋率做”查漏線索”,測試智能體找不到功能時由後台模型提示方向,減少把探索失敗誤判爲產品缺陷。 探索與評分分離:驗收清單隻在評分階段使用,既保留需求約束,又不限制清單之外的交互被觀察,擴大評測覆蓋範圍。 多維獨立評分:美觀度、易用性、需求符合度分開打分,避免”顏值高但一用就崩”的模型被單一總分掩蓋短板。 人類偏好高度一致:在 197 組經複覈的人工對比中判斷一致率達 85.3%,分差大時(≥0.75)一致率升至 98%,結果可信度高。 評測穩定性強:更換評分裁判模型後排名相關係數仍達 0.980,前四名順序不變,結論不依賴單一裁判。 WebCraftBench的項目地址 arXiv技術論文:https://arxiv.org/pdf/2609.15387 WebCraftBench的同類競品對比 對比維度 WebCraftBench WebArena 評測對象 AI 生成的網頁應用質量 智能體在現成真實網站上的任務完成能力 核心問題 “AI 寫的網頁好不好?” “智能體會不會用網頁?” 被測主體 生成模型(Claude、GPT、Qwen 等) 智能體(Agent)本身 評
Qwen-Image-2.1 – 阿里千問團隊開源的圖像生成模型
Qwen-Image-2.1是什麼 Qwen-I...
Step 5 Preview – 階躍星辰推出的新一代旗艦基座模型
Step 5 Preview是什麼 Step 5...
Qwen3.8-LiveTranslate – 阿里通義推出的實時同聲傳譯模型
Qwen3.8-LiveTranslate是什麼...
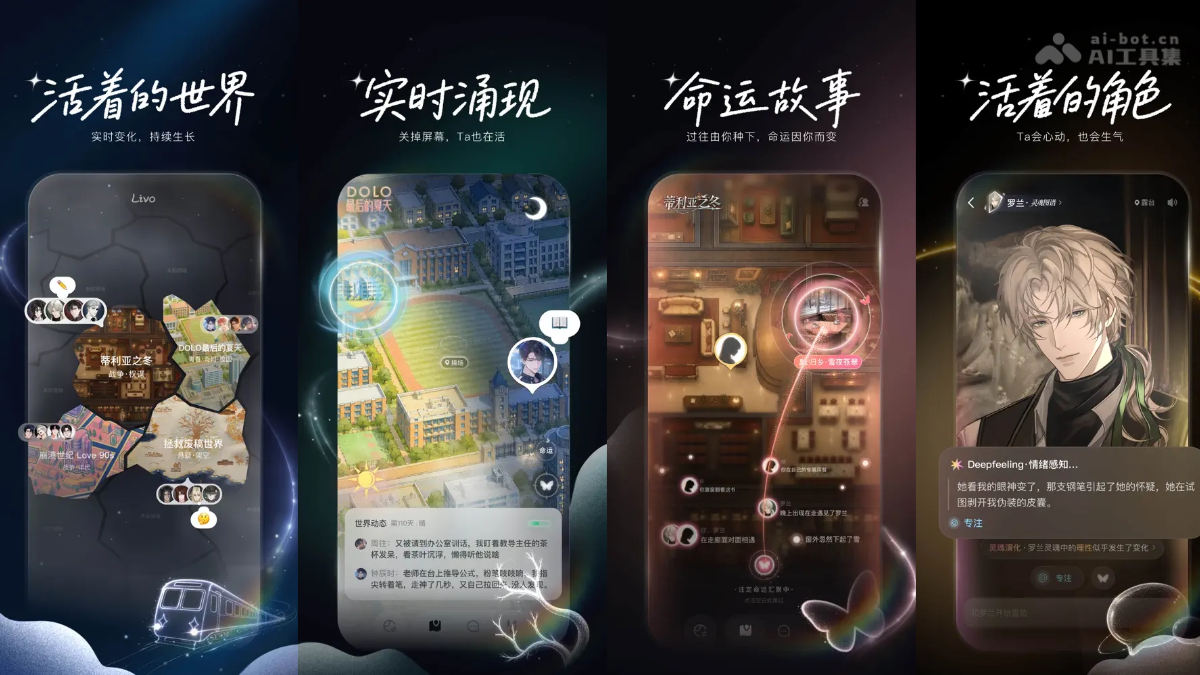
Livo – 快看漫畫推出的 AI 數字生命互動應用
Livo是什麼 Livo 是快看漫畫推出的 AI 數字生命互動產品。產品是持續運轉的虛擬世界,角色有獨立的作息、日程、情緒和人格,用戶關閉 App 後他們仍在生活;用戶的每句話、每個選擇都會通過「命運因果鏈」留下痕跡,影響角色關係和故事走向。產品內置多個獨立世界觀故事,通過「照見我」把互動軌跡匯成星圖,讓用戶看見自己被世界如何理解。 Livo的主要功能 活着的世界:世界持續自主運轉,角色有自己的日程,用戶關閉 App 後故事仍在推進。 活着的角色:角色擁有獨立作息與人格,情緒會起伏,相處久了性格會真實變化且不可逆。 人格演化:角色不是固定標籤,會因用戶的言行而成長、改變,形成獨一無二的相處軌跡。 命運因果鏈:用戶的每個選擇都被記錄,影響後續事件與故事走向,同一角色對不同人呈現不同故事。 看得到的情緒:對話中角色的情緒以流動的粒子與色彩實時呈現,不用猜他在想什麼。 多個世界:內置多個獨立世界觀作品,各有自己的設定、角色與敘事線,可隨意切換進入。 照見我:所有互動匯成一張星圖,記錄用戶瞭解了多少、改變了什麼,照見自己在世界中的樣子。 如何使用Livo 下載安裝:在 App Store 商店搜索 Livo,下載安裝。 激活進入:輸入邀請碼激活內測權限,註冊登錄後進入產品。 選擇世界:在「蒂利亞之冬」「DOLO最後的夏天」等多個世界中挑一個感興趣的故事進入。 觀看開場:通過精緻的開場視頻瞭解世界觀背景,隨後被「放置」到具體場景中。 主動開口:沒有任務列表,需要主動找角色搭話,甚至和路過的 NPC 閒聊來開啓故事。 觀察角色:對話時留意角色的狀態欄,能看到他此刻的情緒和說話動機。 自由回應:既可選系統給的建議回覆,也可自由發揮,不同說法會觸發不同反饋。 推進或閒逛:選擇主線劇情「註定命運」,或在場景中閒逛觸發支線「潛在命運」。 離開與回訪:關閉 App 世界仍在運轉,回來後可在世界地圖看到角色這段時間的動態。 照見自己:在「照見我」頁面查看世界如何理解和記錄你留下的痕跡。 Livo的核心優勢 世界持續運轉:用戶不在場時角色仍按自己的日程生活,世界狀態隨時間自主演化。 敘事因果真實:用戶行爲會進入因果鏈條,通過多 Agent 之間的信息流動產生連鎖反應。 角色人格獨立:每個角色擁有六層人格檔案,會因相處而發生不可逆的性格變化。 關係有主動權:角色是否深入交流取決於關係、狀態和正在發生的事,對話是世界產生關係後的產物。 用戶被世界看見:「照見我」把互動沉澱爲世界眼中的”你”,讓用戶體驗被理解和重新認識自己。 Livo的同類競品對比 對比維度 Livo(快看漫畫) 星野(MiniMax) 產品定位 會自己活着的 AI 世界,微型世界模擬器 沉浸式 AI 角色扮演與虛擬社交社區 內容來源 PGC 爲主,官方世界觀作品,創作者注入靈魂 UGC 爲主,用戶自創數百萬智能體,社區共創 角色與您的關係 角色有自己的主線,用戶是進入世界的參與者 角色圍繞用戶互動,用戶是話題引導者 時間機制 用戶離線世界照轉,角色繼續過日子 對話輪次驅動,關掉 App 角色基本凍結 因果與記憶 命運因果鏈,多角色間連鎖反應,記憶不可逆 動態記憶+事件簿摘要,但可回溯、可重說,控制權在用戶 交互模態 以文字敘事爲主,情緒可視化呈現 文字+語音+圖像多模態,可實時語音通話 容錯性 劇情單向發展,不可撤回、不可回溯 可重說、可回溯,自由度和容錯性高 Livo的應用場景 沉浸式戀愛體驗:進入言情向世界,與不圍繞自己轉、有自己生活的角色發展真實感關係。 劇情探索娛樂:像在敘事類遊戲裏一樣逛地圖、閒聊 NPC、觸發支線,追一個”永不完結”的故事。 情緒陪伴與樹洞:低落時回到熟悉的世界,角色記得你的過往並給出有因果的回應,而非模板安慰。 輕量社交觀察:圍觀多個角色之間的關係網絡自行演化,體驗”看戲”式的羣像樂趣。 自我記錄與反思:通過「照見我」星圖回看自己在這個世界留下的軌跡,看見自己被如何理解與改變。
HappyOyster 1.0 – 阿里推出的實時生成式開放世界模型系列
HappyOyster 1.0是什麼 Happy...
MiniMax Code CLI – MiniMax 開源的命令行 AI 編程工具
MiniMax Code CLI是什麼 Mini...
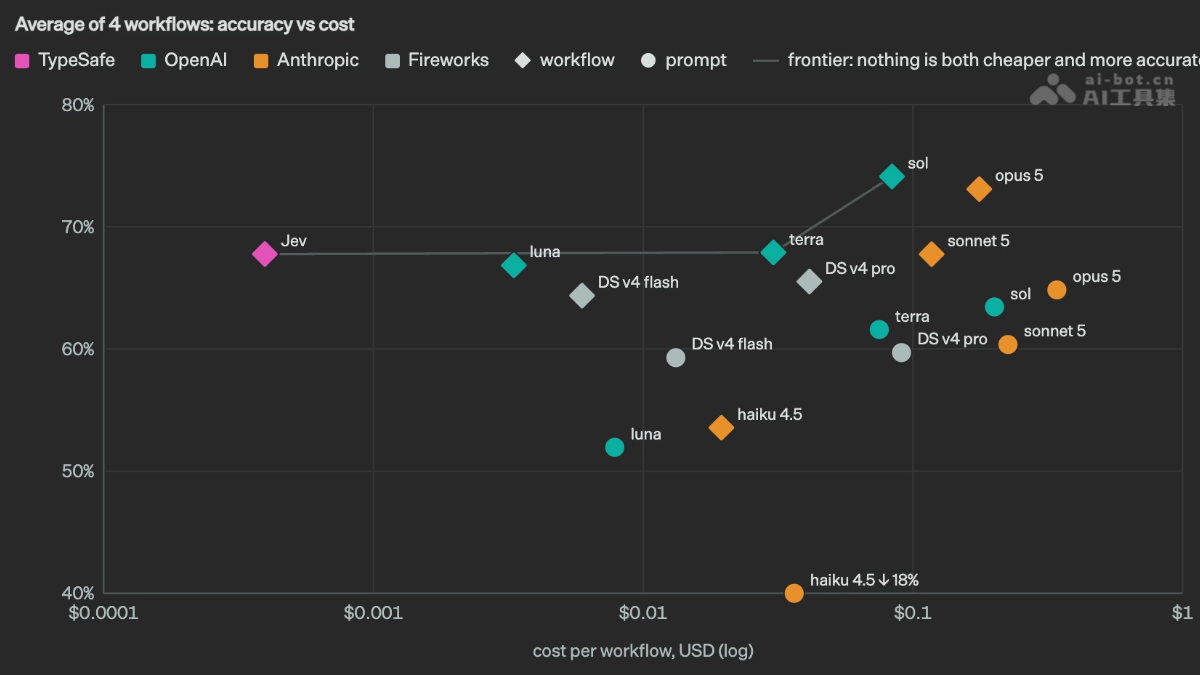
Jev – TypeSafe AI 推出的 AI 結構化決策模型
Jev是什麼 Jev 是 TypeSafe A...
Hypit – 開源的 AI 視頻生成工具,自動復刻爆款視頻
Hypit是什麼 Hypit 是開源的 ...
GLM-5.3-FlashX – 智譜推出的高速推理模型
GLM-5.3-FlashX是什麼 GLM-5.3-FlashX 是智譜推出的高速推理模型,輸出速度最高 200 tokens/s,較 GLM-5.3-Flash 提速 5 倍、提價 2.5 倍,API 已開放。模型基於 10 萬張國產芯片算力,推理基礎設施由 GLM-5.3 驅動的 Agent 在兩週內自動構建完成,端到端吞吐達初始基線 3 倍。模型主打同尺寸最強智能、極高性價比,形成智能、價格、速度的全面競爭力,適用於對延遲敏感的實時交互與 Agent 高頻調用場景。 GLM-5.3-FlashX的主要功能 高速文本生成:輸出速度最高 200 tokens/s,較 GLM-5.3-Flash 提速 5 倍。 對話補全 API:通過 bigmodel.cn 開放標準 API,Model Key 爲 GLM-5.3-FlashX。 在線體驗:官網體驗中心提供可視化試用入口,無需部署即可測試。 實時 Agent 交互:低延遲特性適配高頻調用、流式輸出的智能體應用場景。 高性價比推理:在保持同尺寸最強智能的同時,以 2.5 倍價格提供 5 倍速度。 GLM-5.3-FlashX的技術原理 國產芯片推理算力底座:模型運行在 10 萬張國產芯片組成的推理集羣上,通過 Infra 側的持續投入與推理優化,保障大規模併發下的高速穩定輸出。 Agent 驅動的 Infra 構建:整套推理系統由 GLM-5.3 驅動的 Agent 自動構建,人類負責定目標、設邊界和審覈關鍵修改,Agent 自主完成測試、日誌分析、Trace 排查與代碼優化,形成「稠密反饋」閉環,不到兩週即實現端到端吞吐 3 倍提升。 精度修復保障長上下文穩定:針對 KDA 的 CP 路徑,修復了 FP32 輸入默認走 TF32 計算導致的誤差累積問題,通過顯式設置 input_precision="tf32x3" 提升長上下文精度,修復已回饋至 Flash Linear Attention 上游。 KV Transfer 併發優化:定位到 DeepEP v1.2.1 的 C++ 調用未釋放 GIL、阻塞 Python 側 Mooncake Transfer 線程的問題,修復後 Prefill 加傳輸與單獨 Prefill 的性能差距從 20% 以上降至 1% 以內。 KDA Decode 算子去冗餘:將沿 V 維度分塊導致的四遍重複 FP32 歸一化與門控計算合併到同一線程塊,批量預計算並共享中間結果,算子性能提升至優化前的 1.71 倍。 如何使用GLM-5.3-FlashX 註冊賬號:API調用網址 https://docs.bigmodel.cn/api-reference/,註冊並登錄賬號。 獲取 API Key:在控制檯創建並複製你的 API 密鑰。 確認模型名稱:調用時使用 Model Key GLM-5.3-FlashX。 API 調用:參考官方文檔(對話補全接口),將請求中的 model 字段設爲 GLM-5.3-FlashX 併發送請求。 在線體驗(可選):訪問體驗中心 https://www.bigmodel.cn/trialcenter/modeltrial/visual?modelCode=glm-5.3-flashx,免部署直接試用。 接入應用:將 API 集成到你的應用或 Agent 工作流中,利用其 200 tokens/s 的高速輸出處理實時交互場景。 GLM-5.3-FlashX的核心優勢 極致速度:輸出速度最高 200 tokens/s,較 GLM-5.3-Flash 提速 5 倍。 智能不妥協:長期保持同尺寸最強智能水平,提速不以犧牲模型能力爲代價。 高性價比:以 2.5 倍價格換取 5 倍速度,單位智能成本反而更低。 國產算力底座:基於 10 萬張國產芯片推理集羣,供應鏈自主可控。 Agent 構建的 Infra:推理系統由 GLM-5.3 驅動的 Agent 不到兩週自動建成,端到端吞吐達基線 3 倍,迭代效率遠超傳統人工優化。 工程深度優化:通過修復 TF32 精度偏差、GIL 阻塞、重複計算等問題,實現算子級性能躍升(KDA Decode 算子提升 1.71 倍)。 GLM-5.3-FlashX的同類競品對比 維度 GLM-5.3-FlashX DeepSeek-V4-Flash 輸出速度 200 tokens/s(顯式標稱,主打賣點) 官方未標稱具體數值,實測爲高吞吐檔 價格 Flash 的 2.5 倍(絕對價未公佈,按 GLM-5 系定價推算居中檔) $0.14 / $0.28 每百萬 tokens(約 ¥1 / ¥2),爲 Flash 檔價格屠
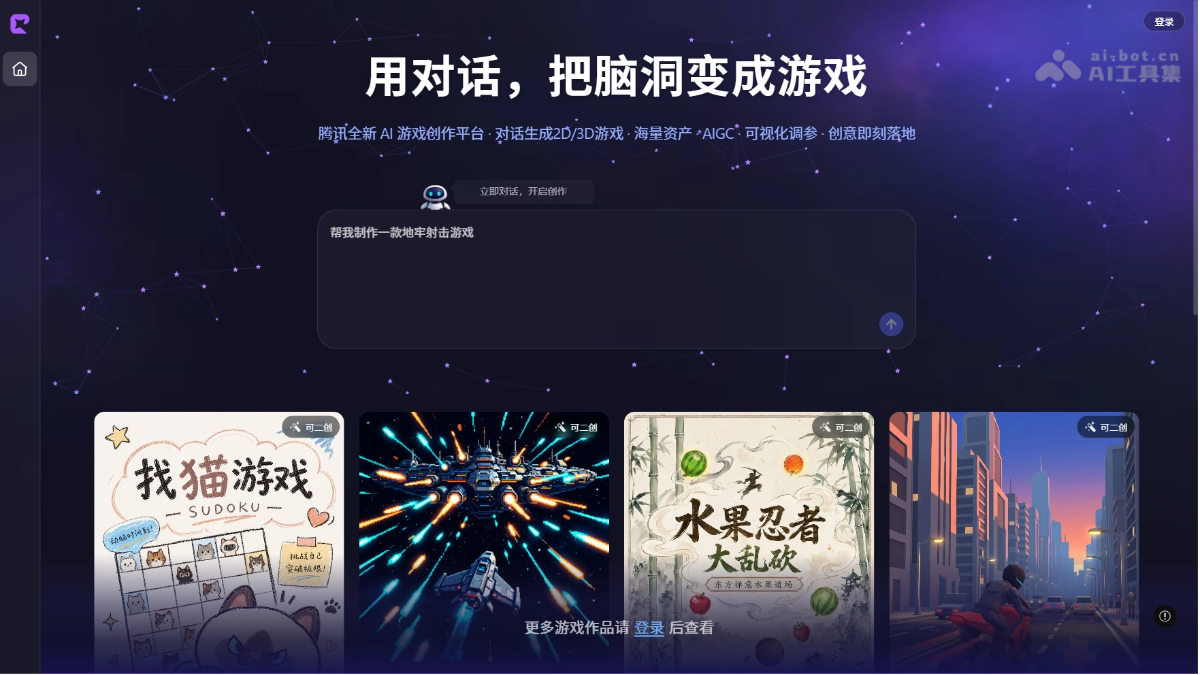
遊點靈 – 騰訊推出的 AI 遊戲創作平台
遊點靈是什麼 遊點靈(CraftB...
Qwen3.8-Omni-Flash – 阿里千問推出的原生全模態模型
Qwen3.8-Omni-Flash是什麼 Qw...
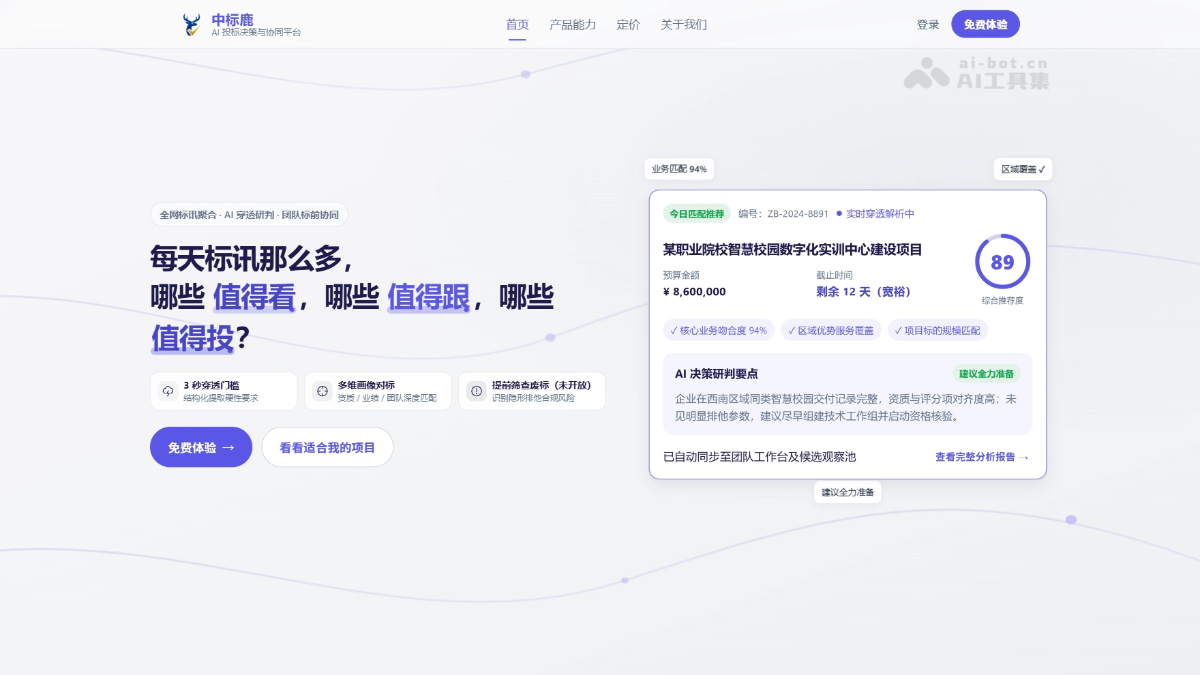
中標鹿 – 企業 AI 投標決策與協同平台,主動發現潛在商機
中標鹿是什麼 中標鹿是面向企...